
Zusammenfassung
- Der EDPB hält einen Ansatz des Gerichtshofs von 2019 für Suchmaschinen bei beiläufig und als Rest erhobenen sensiblen Daten im KI-Scraping möglicherweise für relevant, allerdings nur nach einer Prüfung von vier Bedingungen im Einzelfall.
- Der Entwurf verbindet diese begrenzte Möglichkeit mit Kontrollen vor und nach der Erhebung, während der Modellentwicklung und nach dem Einsatz. Die öffentliche Konsultation endet am 30. Oktober 2026.
Eine öffentlich erreichbare Webseite kann personenbezogene Daten enthalten, die ein KI-Entwickler gar nicht erheben wollte. Was gilt, wenn beim umfangreichen Scraping Informationen über Gesundheit, politische Ansichten, ethnische Herkunft oder sexuelle Orientierung auftauchen? Der Europäische Datenschutzausschuss (EDPB) behandelt diese Frage in seinem Entwurf der Leitlinien 03/2026 zum Web-Scraping für die Entwicklung generativer KI. Stellungnahmen sind bis zum 30. Oktober um 23:59 Uhr MEZ möglich. Der Text ist noch ein Konsultationsentwurf, weder eine endgültige Regel noch eine neue Ausnahme von der DSGVO.
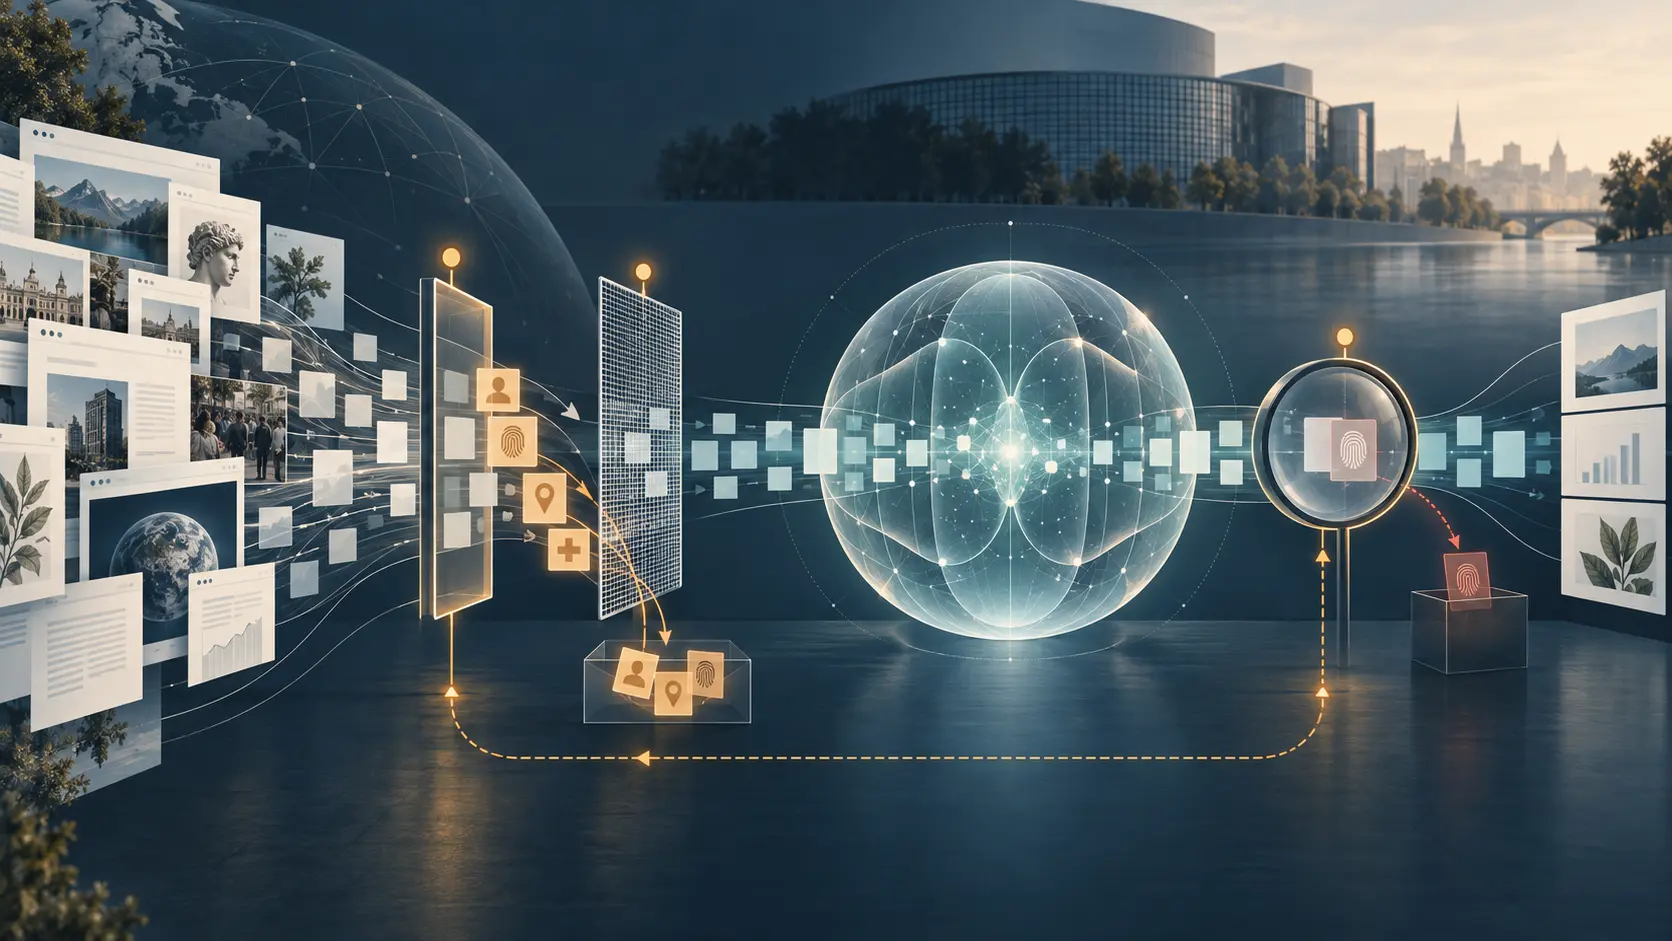
Ausgangspunkt ist die Trennung zwischen beabsichtigter Verarbeitung und unbeabsichtigten Restdaten. Wer besondere Kategorien personenbezogener Daten gezielt erhebt, benötigt eine Ausnahme nach Artikel 9 Absatz 2 DSGVO sowie eine Rechtsgrundlage nach Artikel 6. Davon getrennt betrachtet der Entwurf Daten, die trotz Schutzmaßnahmen zur Verhinderung ihrer Erhebung zurückbleiben. Der EDPB hält Teile der Begründung des Gerichtshofs der Europäischen Union im Urteil von 2019 in der Rechtssache GC u. a. gegen CNIL (C‑136/17) für möglicherweise einschlägig. In diesem Verfahren ging es um die Indexierung und Auslistung durch eine Suchmaschine, nicht um das Training generativer KI-Modelle. Der EDPB macht daraus deshalb keine fertige Erlaubnis für Modellentwickler.
Der Entwurf verlangt eine Einzelfallprüfung von vier Bedingungen. Die Verarbeitung muss in relevanten Punkten der vom Gericht geprüften Tätigkeit einer Suchmaschine ähneln; die Daten dürfen nur beiläufig und als Rest verarbeitet werden, nicht gezielt; der Verantwortliche muss nur schwer oder gar nicht feststellen und verhindern können, dass solche Daten erhoben werden; und er muss im Rahmen seiner Zuständigkeiten, Befugnisse und Möglichkeiten Maßnahmen gegen ihre Verbreitung ergreifen. Treffen die Voraussetzungen im konkreten Fall nicht zu, bietet die Suchmaschinenrechtsprechung keinen allgemeinen Weg an Artikel 9 vorbei.
Die Maßnahmen geben dem Wort „beiläufig“ einen prüfbaren Inhalt. Vor der Erhebung sollte der Verantwortliche genaue Kriterien festlegen, Filter anwenden und Webseiten ausschließen, die typischerweise solche Daten enthalten; der Entwurf nennt etwa Angebote, die hauptsächlich von Minderjährigen genutzt werden. Nach der Erhebung sind verbliebene Daten sofort oder unverzüglich nach ihrer Entdeckung zu löschen. Ein Antrag einer betroffenen Person sollte zur Löschung führen, wenn er plausibel erkennen lässt, dass die Daten unter das Verbot von Artikel 9 fallen.
Während der Modellentwicklung sollte der Verantwortliche Tests auf Datenextraktion und Datenschutzangriffe durchführen und Ausgaben filtern, die die Informationen offenlegen könnten. Nach dem Einsatz sollte der Anbieter des KI-Systems die Ausgaben laufend überwachen, Filter verschärfen oder bestimmte Eingaben und Funktionen einschränken, sobald sensible Informationen erscheinen. Wenn es der technische Fortschritt ermöglicht, sollte er auch maschinelles Verlernen oder eine gleich wirksame Methode erwägen.
Der EDPB erwartet außerdem, dass der Verantwortliche die vier Bedingungen und die Eignung und Wirksamkeit seiner Maßnahmen belegen kann. Regelmäßige Prüfungen sollen Entwicklung und Nutzung erfassen; unwirksame Maßnahmen müssen ergänzt oder ersetzt werden. Rechenschaftspflicht wird damit zu einer betrieblichen Nachweiskette: Erhebungskriterien, ausgeschlossene Quellen, Löschprotokolle, Modelltests, auffällige Ausgaben und Reaktionen darauf müssen zusammenpassen. Die bloße Bezeichnung der Erhebung als „beiläufig“ reicht nicht.
Diese Prüfung besonderer Kategorien ist von der Bewertung berechtigter Interessen zu trennen. Dass eine Seite öffentlich ist, bedeutet nicht, dass eine Person dem Scraping für einen bestimmten Zweck zugestimmt hat; auch das Fehlen einer robots.txt-Regel ist keine Einwilligung nach der DSGVO. Beschränkungen einer Webseite können dennoch in die Beurteilung einfließen, welche Verarbeitung betroffene Personen vernünftigerweise erwarten durften. Solche Signale verändern die Tatsachengrundlage, ersetzen aber weder die Rechtsgrundlage noch Artikel 9.
Praktisch verlagert der Entwurf die Frage an den Anfang der Kette. Sind sensible Daten nur deshalb schwer erkennbar, weil ohne Auswahlkriterien gesammelt wird, beweist diese Schwierigkeit allein nicht, dass die Verarbeitung bloß residual ist. Entscheidend ist, ob der Verantwortliche zumutbare Schritte zur Verhinderung der Erhebung unternahm, durch Filter gerutschte Daten erkennen und löschen konnte und eine Reproduktion durch das Modell verhindern kann. In der Konsultation können Organisationen und Einzelne hinterfragen, ob diese Erwartungen klar genug sind, bevor der EDPB den Text abschließt.
Quellen
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten