
Resumen
- El EDPB dice que un criterio judicial de 2019 para buscadores podría ser pertinente cuando el scraping para IA recoge datos sensibles de forma accidental y residual, pero solo si se cumplen cuatro condiciones específicas.
- El borrador vincula esa vía limitada con controles antes y después de la recogida, durante el desarrollo del modelo y tras su despliegue. Las observaciones públicas se reciben hasta el 30 de octubre de 2026.
Una página abierta al público puede contener datos personales que el desarrollador de un sistema de IA no pretendía recopilar. ¿Qué ocurre cuando una extracción a gran escala encuentra información sobre la salud, las opiniones políticas, el origen étnico o la orientación sexual de alguien? El Comité Europeo de Protección de Datos (EDPB) aborda esa cuestión en el proyecto de Directrices 03/2026 sobre scraping web para desarrollar IA generativa. El plazo de consulta termina el 30 de octubre a las 23:59 CET. Sigue siendo un borrador sujeto a comentarios, no una regla definitiva ni una nueva excepción al RGPD.
El punto de partida es distinguir entre tratar esos datos intencionadamente y encontrarlos como residuo. Si una organización busca extraer categorías especiales de datos personales, el artículo 9.2 del RGPD exige una excepción específica, además de una base jurídica del artículo 6. Por separado, el borrador examina lo que sucede cuando esos datos aparecen pese a las medidas destinadas a evitar su recogida. El EDPB considera que parte del razonamiento del Tribunal de Justicia en la sentencia de 2019 GC y otros contra CNIL (asunto C‑136/17) podría servir de referencia. El asunto trataba de indexación y retirada de resultados en buscadores, no de entrenar modelos de IA generativa. Por eso el EDPB no lo convierte en un permiso ya disponible para los desarrolladores de modelos.
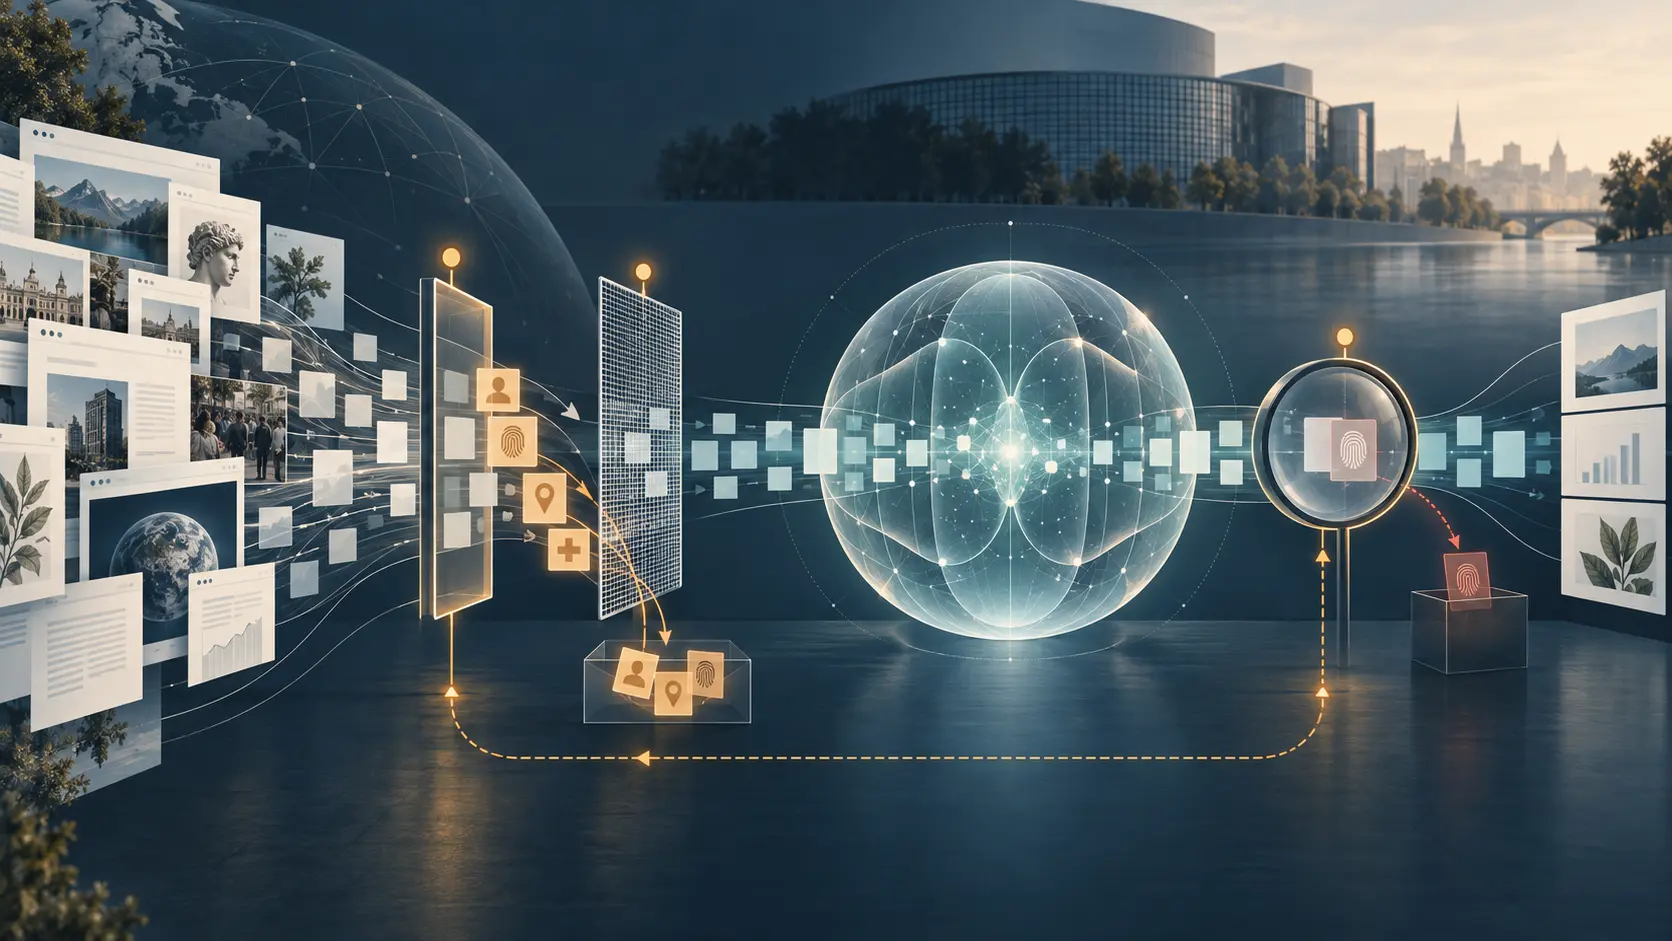
El texto propone una evaluación individual de cuatro condiciones. El tratamiento debe tener similitudes pertinentes con la actividad de un buscador examinada por el Tribunal; los datos deben ser incidentales y residuales, no objeto de un tratamiento deliberado; al responsable debe resultarle difícil o imposible determinar si están presentes y evitar su recogida; y debe emplear, dentro de sus responsabilidades, facultades y capacidades, medidas que impidan su divulgación. Si los hechos no encajan, el razonamiento sobre buscadores no ofrece una salida general a las exigencias del artículo 9.
Los controles dan un sentido práctico a la palabra «incidental». Antes de recopilar, el responsable debería fijar criterios precisos, aplicar filtros y excluir sitios que contengan de forma estructural información sensible; el borrador menciona sitios usados principalmente por menores. Después de la recopilación, los datos residuales deberían eliminarse de inmediato o en cuanto se detecten. Una solicitud de una persona debería llevar a borrar los datos si aporta indicios plausibles de que pertenecen a una categoría prohibida por el artículo 9.
Durante el desarrollo, el responsable debería probar la resistencia a la extracción y a ataques contra la privacidad, y filtrar las respuestas que revelen esos datos. Una vez desplegado el sistema de IA, su proveedor debería vigilar continuamente las salidas, reforzar filtros o limitar instrucciones cuando aparezca información sensible y considerar el desaprendizaje del modelo —u otro método de efecto equivalente— si los avances tecnológicos lo hacen viable.
El EDPB también espera que el responsable pueda demostrar que las cuatro condiciones se aplican y que sus controles son pertinentes y eficaces. La verificación periódica debería abarcar tanto el desarrollo como el uso del modelo; si una medida no funciona, habrá que introducir otras o modificarla. Así, la responsabilidad demostrable se traduce en registros operativos: criterios de recopilación, fuentes excluidas, eliminaciones, pruebas del modelo, incidentes de salida y respuestas posteriores deben ser coherentes entre sí. Llamar «incidental» a la recopilación no sustituye esa evidencia.
Este análisis de categorías especiales es distinto del interés legítimo. Que una página sea pública no equivale a consentir que se extraigan sus datos para un propósito concreto, y la falta de una regla robots.txt no constituye consentimiento conforme al RGPD. Las restricciones de un sitio sí pueden influir en las expectativas razonables de las personas al ponderar el interés legítimo. Esas señales cambian los hechos que deben evaluarse, pero no reemplazan la base jurídica ni las exigencias del artículo 9.
El efecto práctico del proyecto es llevar la pregunta a una fase anterior. Si los datos sensibles son difíciles de detectar porque la extracción no discrimina, esa dificultad no demuestra por sí sola que el tratamiento sea residual. La vía propuesta pregunta si el responsable tomó medidas viables para impedir la recogida, podía detectar y retirar lo que superase los filtros y podía evitar que el modelo lo reprodujera. La consulta ofrece a organizaciones y personas la oportunidad de cuestionar si esas expectativas están suficientemente claras antes de que el EDPB cierre el texto.
Fuentes
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance