
摘要
- EDPB表示,欧盟法院2019年针对搜索引擎的裁判思路,或可用于分析AI抓取中偶然、残余的敏感数据,但须逐案满足四项条件。
- 草案把这一有限路径与采集前过滤、采集后删除、模型开发期间的保护和部署后的持续监测相连。公众意见征集于2026年10月30日截止。
公开网页中可能包含AI开发者并未打算收集的个人数据。若大规模抓取碰到涉及某人健康、政治观点、族裔或性取向的信息,接下来该如何处理?欧洲数据保护委员会(EDPB)在《生成式人工智能背景下网页抓取指南03/2026》草案中提出了一个框架。意见提交期截至10月30日23:59(中欧时间)。这仍是征求意见的草案,并非最终规则,也没有创设GDPR的新豁免。
草案首先区分了有意处理与意外残留。如果组织有意抓取特殊类别个人数据,GDPR第9条第2款要求具备特定例外依据,同时还需第6条规定的合法性基础。草案另行讨论的是:组织采取了防止措施,仍有少量此类数据漏入采集结果的情况。EDPB认为,欧盟法院在2019年“GC等诉法国国家信息与自由委员会”(C‑136/17)案中针对搜索引擎所作判断,可能对这类情况有参考价值。但该案处理的是搜索引擎索引与删除链接,并非生成式AI模型训练。EDPB并未把它说成模型开发者现成可用的许可。
草案要求逐案核对四项条件:相关处理活动须与法院审理的搜索引擎处理有实质相似性;敏感数据只能是偶然、残余出现,而不是有意处理的对象;控制者须难以或无法在采集前确定此类数据是否存在并阻止其被收集;控制者还须在自身责任、权限和能力范围内采取措施防止数据传播。若事实不符合这些条件,搜索引擎裁判思路就不能成为绕过第9条要求的一般通道。
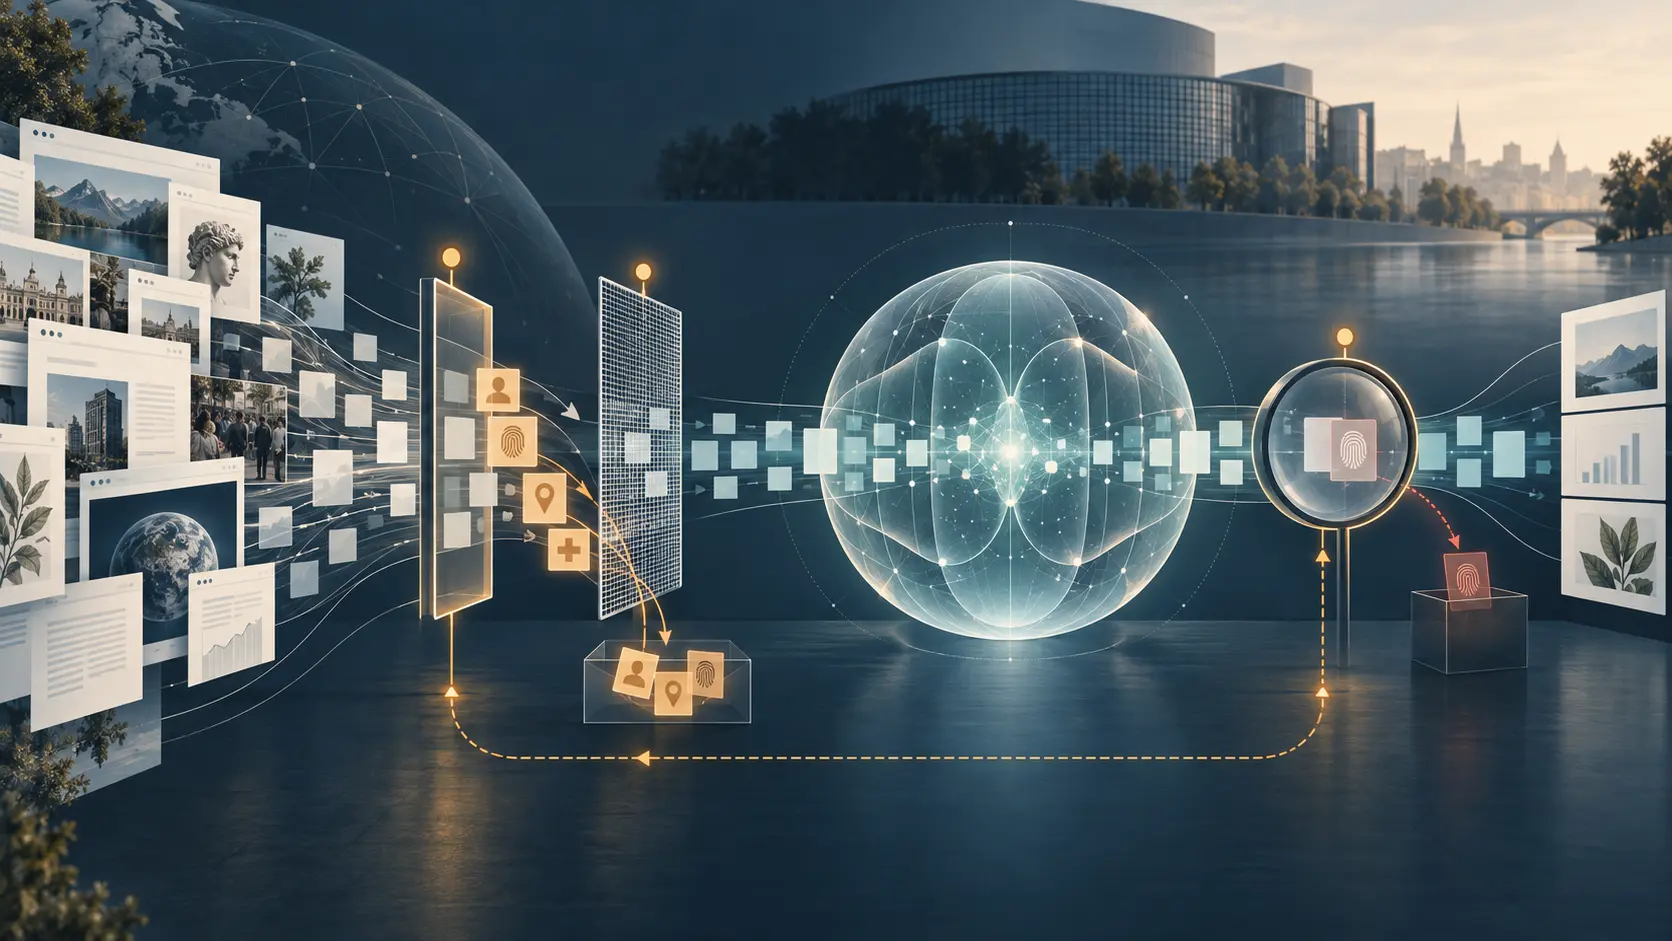
“偶发”需要跨越多个环节的证据支撑。采集之前,控制者应设定精确的筛选标准、使用过滤器,并排除结构上经常包含敏感数据的网站;草案举例提到主要由未成年人使用的网站。采集之后,意外残留的数据应立即删除,或在发现后尽快删除。若个人请求删除且提供了合理迹象,说明有关数据可能属于第9条禁止处理的类别,控制者应予删除。模型开发期间,应测试数据能否从模型中被提取,并评估抵御隐私攻击的能力,同时过滤可能泄露此类数据的输出。系统上线后,服务提供者应持续监测模型输出;一旦出现敏感信息,就加强过滤或限制相关提示,并在技术进步允许时考虑模型遗忘或效果相当的处理方式。
EDPB还要求控制者能够证明四项条件确实适用于该案,并证明防护措施相关且有效。定期核验应覆盖模型开发与使用阶段;如果措施失效,就应补充或更换。问责因此落到可复核的运营记录上:采集标准、排除来源清单、删除记录、模型测试、输出事件和后续处理应能彼此印证。只把抓取称为“偶发”,不能替代这些证据。
这项特殊类别数据分析与合法利益的判断是两回事。网页公开可见,不等于个人同意将其数据用于某种特定抓取目的;没有 robots.txt 规则也不构成GDPR意义上的同意。网站设置的限制仍可能影响控制者对个人合理预期的评估,并进入合法利益的权衡。但这些信号改变的是个案事实,不能替代法律基础或第9条要求。
草案的实际影响,是把问题提前到采集端。如果敏感数据难以识别只是因为组织进行无差别抓取,这种困难本身并不能证明数据只是残余。草案要求判断控制者是否采取了可行的预防措施,能否发现并删除漏网数据,以及能否阻止模型再次生成这些信息。公众咨询为组织和个人提供了机会,在EDPB定稿前质疑这些要求是否足够清晰。
来源
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance