
摘要
- 日本广域工作负载转移(Wide-Area Workload Shift)联盟由12家机构组成。联盟称,示范项目于8月启动,计划持续至2027年2月:它把研究网络、电力公司的光纤与数据中心集群连接起来,并拟由编排器参考电力、市场、GPU、电池和网络状况安排任务。
- “虚拟超大规模云”是目标构想,不是已披露的运营能力。共同接口、开放运营模式、商业模式和治理仍属于后续工作。真正的考验,是能否让可迁移任务成为一项有买方、有价格、也有明确服务责任方的业务。
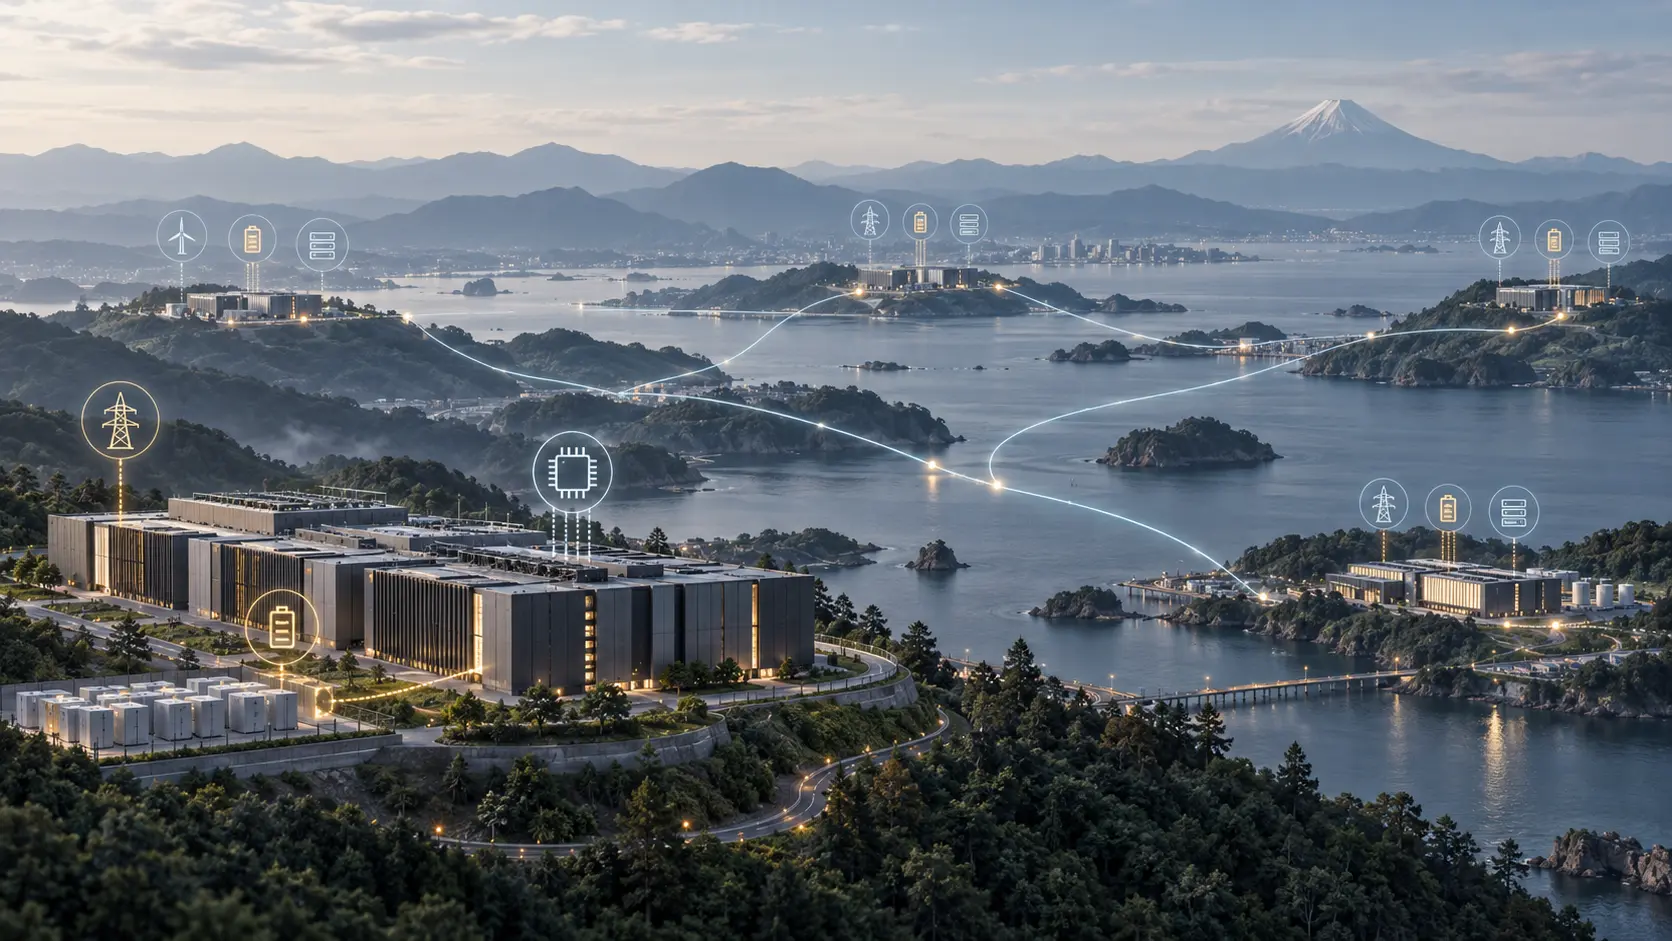
这个名称先许下了承诺,项目本身还没有证明它。所谓“虚拟超大规模云”,听起来像是由分布式数据中心组成、而非依托单一园区的云服务商。但日本广域工作负载转移示范项目的12家参与机构描述的是一次试验,并非已经上线的商业云。它们在10月7日的公告中称,工作于8月开始,计划持续到2027年2月。项目要验证的是:能否在AI训练和推理中协调通信、电力与计算资源,并且在技术、运营和商业层面可行。联盟公告
选址问题确实存在。日本《2025年能源白皮书》称,2023年东京和大阪地区约占全国数据中心总建筑面积的九成;无碳电源则分布不均。这是以建筑面积为口径、对应2023年的历史数据,不是今天可用容量的地图。但它说明,测试一种能把部分任务安排到电力更充足地点的网络具有现实动机。即便如此,迁移任务不会让电力穿过受限输电线路,不会自动获得并网接入,也不能保证接收站点有空闲GPU。日本资源能源厅《能源白皮书》
拟议架构比“虚拟超大规模云”这个名称具体。联盟计划利用日本国立情报学研究所的SINET研究网络,以及东京电力电网公司的暗光纤;同时验证数据中心部分区域之间的全光直连。编排器拟综合电力供需、市场信息、GPU利用率、电池状态和网络条件,决定工作负载在哪里运行。软银和富士通分别承担平台开发角色;参与方还包括通信运营商、电力企业、数据中心供应商和大学。这些设施构成试验环境,却尚不能让各家的计算容量彼此通用。
工作负载能否迁移,是第一道经济筛选。一项可以等待区域电力富余时再运行的训练任务,与用户要求即时返回结果的在线推理请求不同。即使任务允许延迟,也可能依赖大型数据集、检查点状态、软件环境、数据驻留规则或性能承诺,迁移成本并不低。2026年一项研究使用一周的阿里巴巴集群轨迹数据,并根据其模型估计,在灵活性窗口内最多可推迟22%的负载。这说明部分任务可能具有时间灵活性;它不是日本项目的测量结果,也没有证明这些任务能在互不隶属的运营商之间迁移。Caprara等,《International Journal of Electrical Power & Energy Systems》
联盟列出的后续计划,本身就揭示了示范与产品之间的距离:开放运营模式和共同接口有待开发,商业模式和统一规则仍待研究。公告没有披露服务定价、客户合同、收入分配、调度权限、服务等级承诺或实测工作负载量;也未报告弃电、排放或电网投资因此减少。这些信息未公开,并不等于项目失败;它们划定了项目尚未对外回答的商业问题。
云客户需要的不只是一个能找出看似更便宜或更清洁地点的调度器。客户要知道哪些任务符合迁移条件、允许延迟多久、目的地满载时怎么办、谁控制数据路径,以及错过期限时由哪家运营商补救。数据中心所有者在让第三方安排负载之前,需要弄清收入或节省电费如何分配。通信运营商需要给带宽定价并维护性能。电力市场信号也必须对应一个可用地点和实际响应权限,而不能只是仪表盘上的区域电价。
因此,最先成形的产品或许是规则手册与接口,而不是一套新的云控制台。如果试点产出统一的工作负载描述、可验证的遥测、可互操作的调度方式,以及参与者认可的结算机制,原本彼此割裂的容量才可能更容易签约。若只是在几所大学或指定合作方之间成功转移任务,它证明的是一种技术路径,而不是超大规模云服务,更不是可投资的市场。
计划于2027年2月结束的时间点应被视为检查节点,而非商业上线预测。值得观察的是:实际符合条件并完成的任务数量与类型、延迟和失败率、每次调度采用的电力和网络条件,以及客户和运营商承担的合同义务。只有当控制权、成本和服务承诺也随任务一起流转时,“虚拟”才代表真正的共享服务。
来源
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance