摘要
- W3C 在 2011 年 5 月 24 日公布的首份 Resource Timing 工作草案,把计时从整页深入到单项资源,以图片为例列出获取、域名查询、连接、请求和响应时间。
- 2017 年 3 月 30 日的一级候选建议把资源记录放进性能时间线,规定有限容量的缓冲区,并用
Timing-Allow-Origin决定跨来源资源的详细时间能否被页面读取。
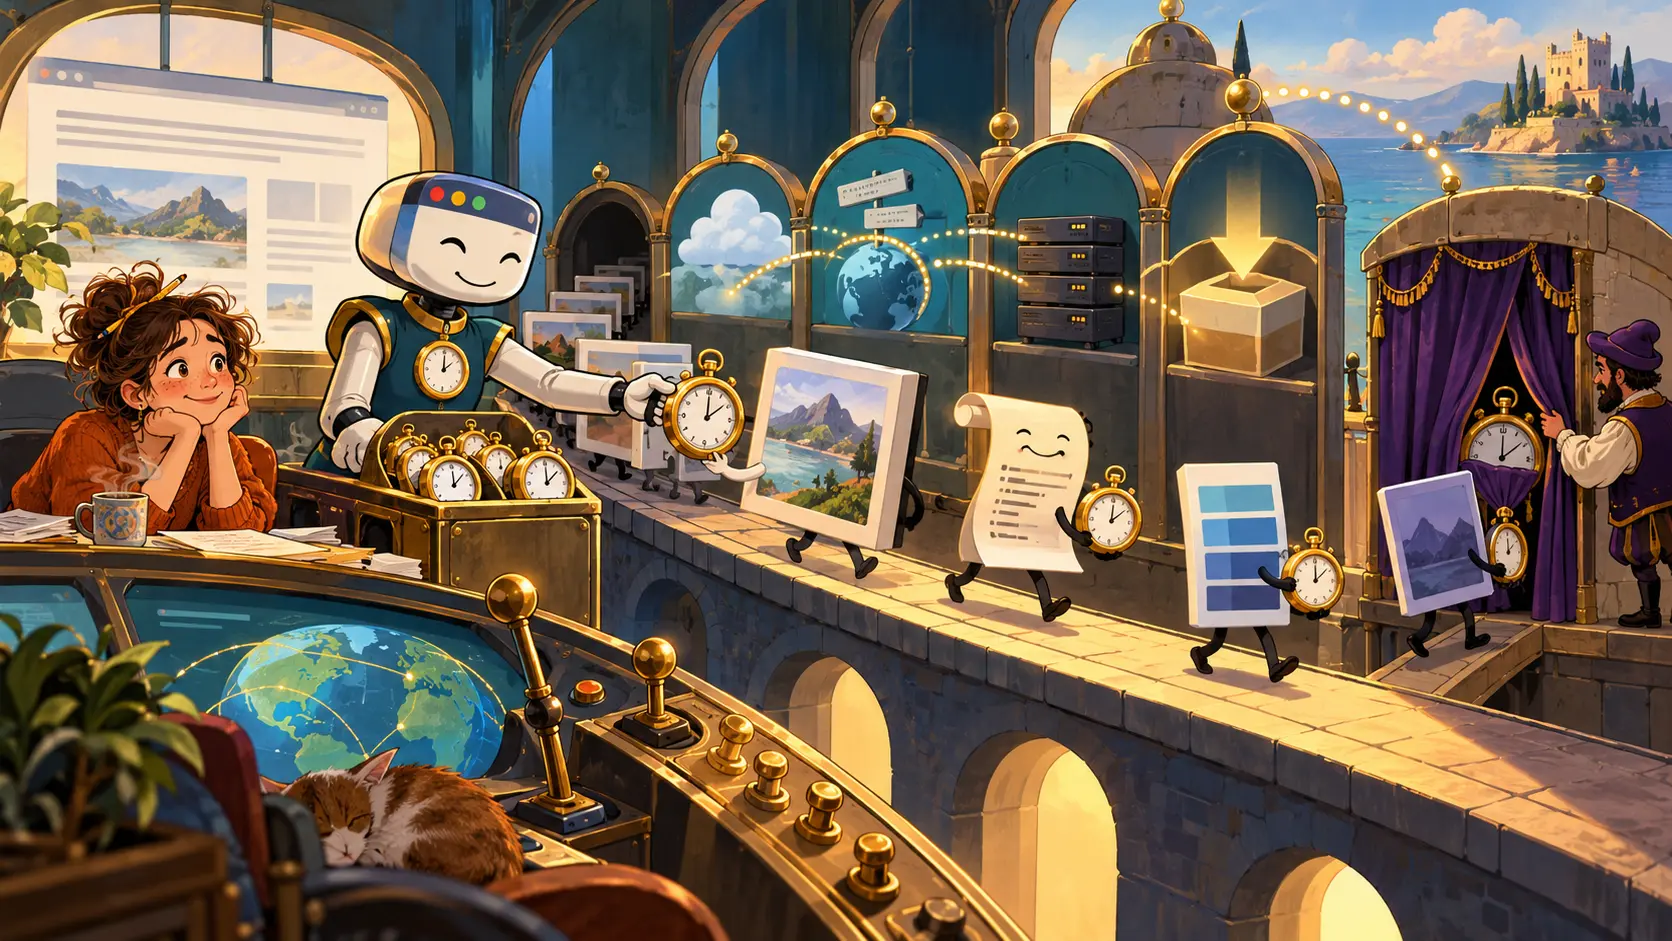
一页网页迟到了。头图说是样式表挡路,样式表说脚本磨蹭,脚本望着服务器叹气。整页加载时长只能证明读者等过,无法把迟到责任分给每一项资源。Resource Timing 干脆把秒表发给图片、样式表和脚本,让各自的到达过程留下记录。它没有替网页修理速度;它先让争论有了具体对象。
W3C 于 2011 年 5 月 24 日发布的首份 Resource Timing 工作草案,开头就把问题放在网页内部的延迟上。草案举的是一张图片的获取时间。文档导航有自己的起点和终点,页面里的资源却各走各的路。一张照片可能还在路上,标题已经出现;一个脚本可能结束了下载,画面仍在等待下一步。把它们全塞进同一张总账,能算结账时间,却找不出是谁占着柜台。
草案给每条记录安排资源名称、触发类型和一串节点。fetchStart 标记获取开始,domainLookupStart、connectStart、requestStart、responseStart 与 responseEnd 把域名查询、连接、请求、首批响应及接收结束放到一条线上。若一张图片耗时突出,运营人员可以接着看时间留在了哪段,而不是随口把锅扔给“网络”。读这些点不是为了给图表填满颜色,而是为了决定去检查哪个环节。
有时表针几乎叠在一起,原因很普通:浏览器复用了连接,或者从缓存拿到了资源。一次已走过的路不必再走一遍。相同的时间值可以说明某一步并没有重新执行,不能机械地当作坏钟表。比较两次访问时,也得问清哪次带着热缓存、哪次是首次加载。资源计时记录的是一次具体获取,不是一张图片永恒不变的性格。
到了2017 年 3 月 30 日的 W3C Resource Timing Level 1 候选建议,这些记录进入性能时间线。规范的例子调用 performance.getEntriesByType('resource'),筛出 initiatorType 为 img 的条目,再拿 responseEnd 与 startTime 比出获取时长。几张图片因此可以排在一起,谁迟到、迟在哪段都有可查的线索。脚本和样式资源也能按同样思路盘点。整个页面终于不用站在嫌疑人席上替每张图片回答。
计时本身也占地方。2017 年文本描述了有限的资源计时缓冲区,以及 setResourceTimingBufferSize()、clearResourceTimings() 等管理方法。资源多的网页可能把本子写满。采集方必须决定留多少页、何时清空。漏掉后半场记录的报表不会让后半场突然变快;它只说明记账员没纸了。这是性能观察的一项实际配置,不能在分析结果时假装它不存在。
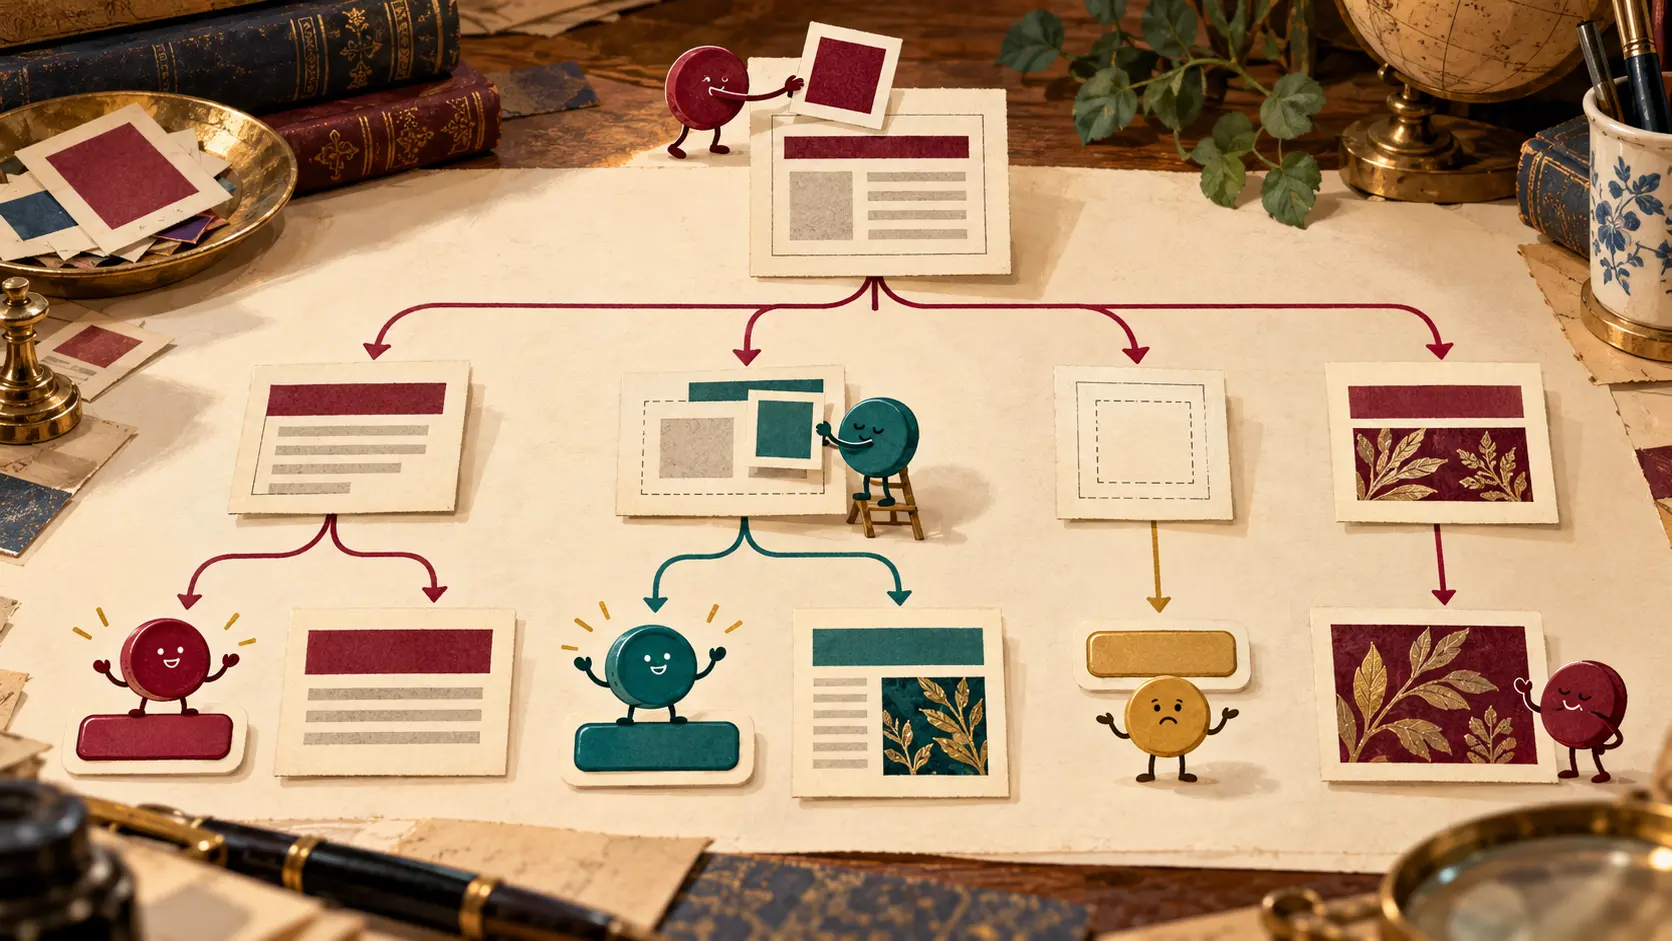
更微妙的是别人的资源。页面能嵌入外部图片,浏览器也能为这次获取留下条目;但详细阶段时间默认受限制。提供资源的服务器可以通过 Timing-Allow-Origin 响应头,让指定来源读取更多细节。页面作者有权看自己发出的请求,却不能因为把别人的图片嵌进来,就理所当然打开别人服务器的每一格秒表。是否掀帘子,由资源供应方决定。
这条边界也改变了数字的读法。外部资源的条目可能有名字、有总时长,域名查询、连接和响应的细格却看不见。把空白或受限值读成“零毫秒”会得出荒唐结论:仿佛远处的服务器不用接电话就能送货。只有在供应方开放详细时间后,那些分段数字才适合用于分段判断。没开放时,应承认数据的可见范围,再查能看到的证据。
W3C 于 2026 年 9 月 1 日发布的候选建议草案延续了逐项资源记录,并描述了比早期文本更丰富的属性和更大的缓冲区。日期在这里很要紧:2011 年的首份草案、2017 年候选建议与 2026 年草案不是同一张冻结的接口清单。它们贯穿的一条线更简单:浏览器把一次资源获取写成可检索的时间记录,页面从这张记录里找工作线索。
最慢的图片也未必最值得先修。它可能躲在很远的下方;另一张稍快的图片可能正挡着读者要看的标题。Resource Timing 回答的是资源怎样到达,不会替编辑判断它在画面里的位置。团队还得把秒表与页面布局、显示顺序和读者实际感受到的等待拼在一起。然后才谈压缩、改变投递方式、调整顺序,或者让不急的资源晚点上场。
于是会议里的句子可以变短,也变准。“网页慢”是一声叹息。“这张图片的请求等在这里,样式表复用了连接,那项外部资源的细节没有开放”是一张待办单。秒表不会替团队跑腿,但至少让头图想嫁祸样式表时,先交出自己的考勤卡。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance