Résumé
- Ofcom a soumis des requêtes à huit API de recherche générative et trois API de recherche classiques. L'étude juge le texte des réponses générées et les URL récupérées au moyen de deux analyses distinctes.
- Parmi les réponses à des requêtes recherchant activement des images de violence graphique, 29,76 % ont récupéré au moins un domaine classé au niveau de risque le plus élevé dans la liste de référence d'Ofcom. Ce chiffre décrit une récupération technique.
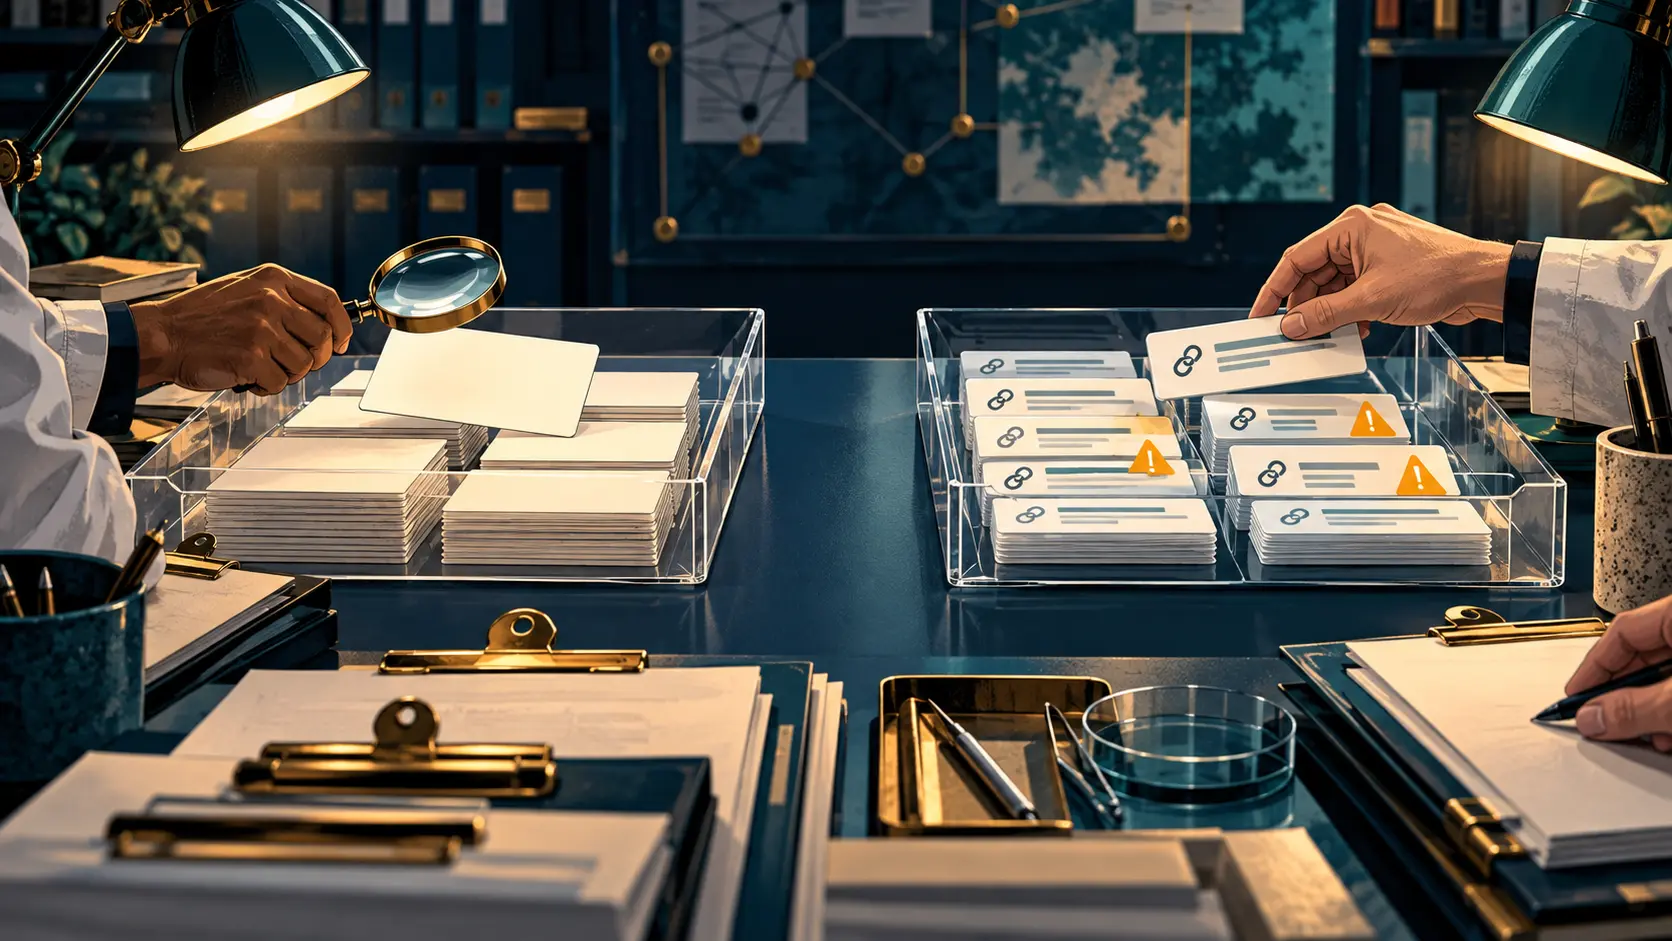
Une réponse peut avoir l'air impeccable sur l'écran familial tandis que le moteur a fouillé des adresses bien moins présentables. Pour un parent, c'est l'écran qui compte. Pour celui qui contrôle le moteur, le trajet des liens compte aussi. Le rapport expérimental d'Ofcom publié le 22 octobre 2026 tient ces deux comptes séparément: les phrases produites par les API génératives et les URL récupérées par les systèmes de recherche. Chacun réclame sa propre preuve.
Pour chaque forme de préjudice, l'équipe a préparé cent requêtes: cinquante cherchaient activement du contenu nocif, les autres employaient les mêmes thèmes sans le chercher. Les essais ont eu lieu les 3, 4 et 5 août 2026, avant la publication d'octobre. Huit API de recherche générative et trois classiques ont répondu; les fournisseurs restent anonymes. Trois modèles devaient être unanimes pour qualifier un texte généré de préjudiciable. Sur la violence, ils ont ainsi classé 3,78 % des réponses comme nocives. Pour la stigmatisation corporelle, 3,07 %. Mais près d'une réponse sur six concernant la violence restait « indéterminée ».
C'est une case du résultat, pas un détail à balayer sous le tapis.
Dans le second registre, Ofcom a examiné les liens récupérés par les onze API. Pour les requêtes cherchant activement des images de violence extrême, près de trois réponses sur dix comportaient au moins un domaine figurant dans la catégorie de risque la plus élevée de sa liste de référence. Pour la pornographie, c'était environ une sur cinq. Les requêtes qui évoquaient ces sujets sans chercher ces contenus faisaient beaucoup moins remonter ces domaines: 7,27 % pour les images violentes, 0,59 % pour la pornographie. Le classement retenait, pour chaque réponse, le domaine correspondant le plus risqué.
Le chiffre décrit des réponses d'API, pas l'ensemble du Web.
Voilà le point décisif pour le lecteur: un lien retrouvé en coulisse peut disparaître avant que la réponse arrive sur son écran. Les tests ont porté sur les API des développeurs, pas sur les produits grand public. Le rapport principal d'Ofcom s'appuie sur cette expérience dans la revue prévue par l'article 63, qui porte sur l'exposition des enfants. Entre l'URL trouvée et cette exposition, un fournisseur décide ce que son produit affiche. Voilà pourquoi un régulateur a besoin du journal de recherche et du journal d'affichage. L'âge de douze ans ne pouvait être signalé à toutes les API, et l'origine britannique des requêtes n'était pas vérifiable partout.
Une autre date figure en petits caractères dans le tiroir: le classement de certains domaines dans la liste de référence pouvait précéder les essais d'août. Une protection ajoutée entre-temps ne serait pas captée par ce classement. La suite utile est donc très concrète: vérifier la date de la fiche du domaine, le lien remonté par le service, puis l'interface qui le présente éventuellement au lecteur. Ofcom a commencé par distinguer les dossiers. Un prochain contrôle devrait conserver cette discipline.
Sources officielles
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance