Résumé
- Publié en mai 1996, le RFC 1945 présente
Referercomme un en-tête pouvant transmettre au serveur destinataire l’URI de la page à l’origine du lien. Il cite les listes de liens entrants, les journaux et la réparation des adresses erronées. Il signale aussi que l’origine peut être une page privée. - En janvier 1997, le RFC 2068 conserve l’en-tête, remarque que son nom est mal orthographié et décrit le risque de révéler une URI privée. Une adresse saisie au clavier n’a pas de page source à signaler ; le fragment de l’URI n’est pas transmis.
- Le projet de recommandation W3C du 26 janvier 2017 décrit plusieurs politiques : transmettre l’URL entière, seulement l’origine du site, ou aucun referrer. Le document établit des règles datées, sans mesurer leur déploiement dans les navigateurs.
Le serveur demandait un chemin de retour
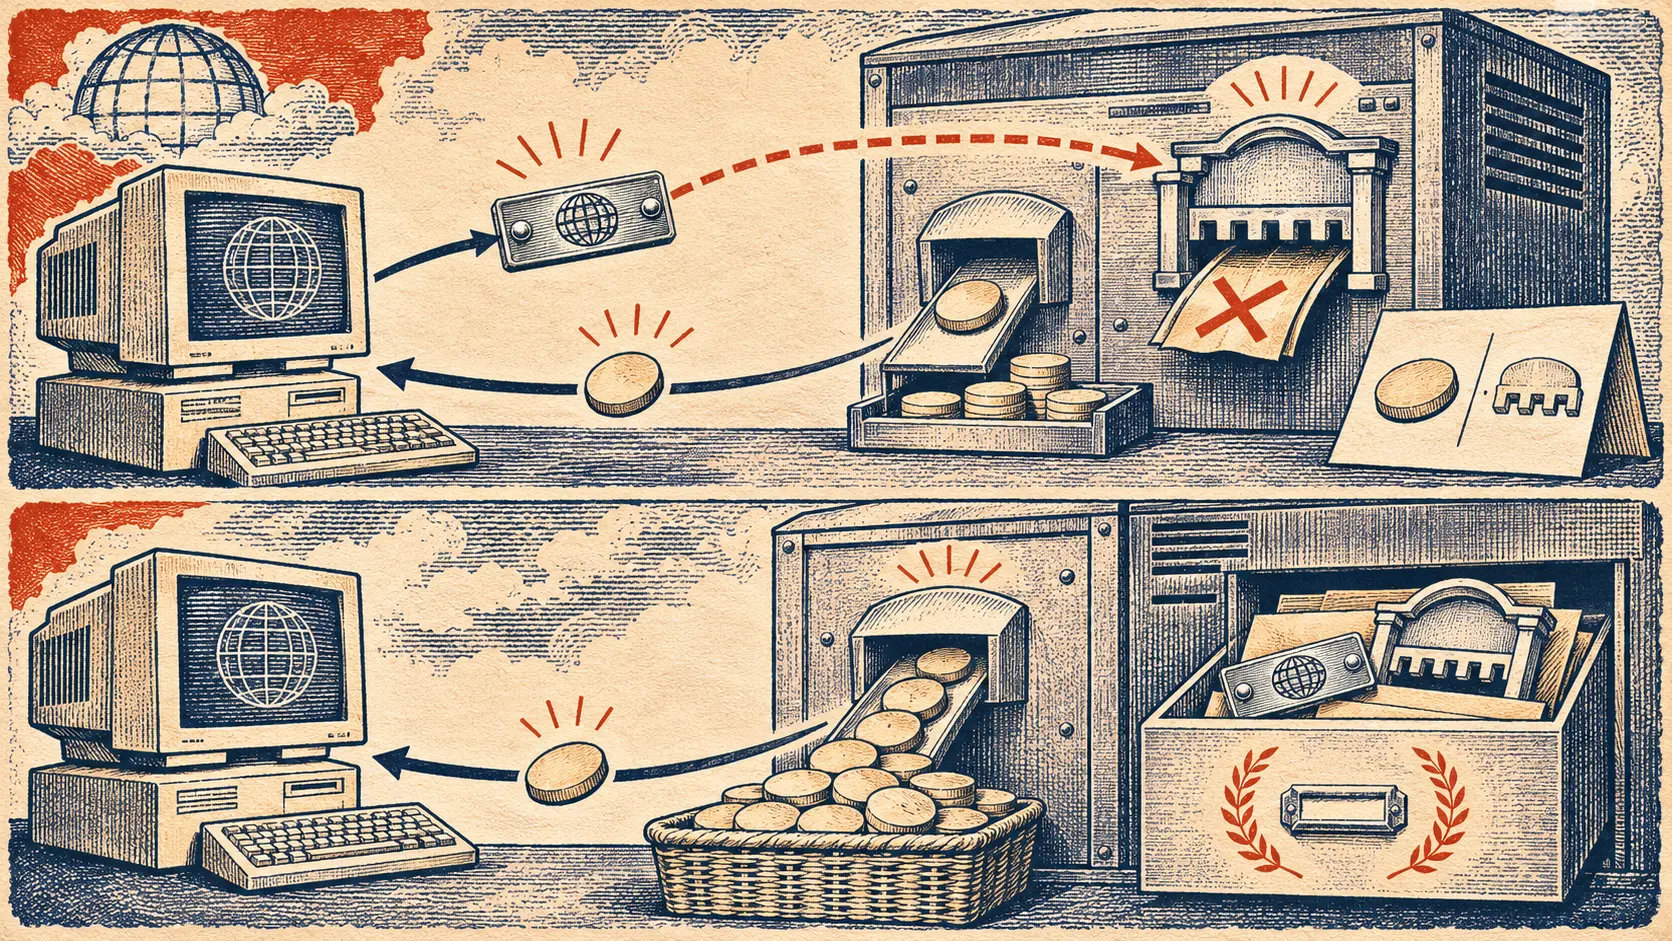
Dans le RFC 1945 de mai 1996, consacré à HTTP/1.0, un serveur pouvait recevoir un renseignement sur le trajet du visiteur. Après un clic, le navigateur pouvait ajouter à la requête un en-tête Referer contenant l’URI de la page où il avait trouvé le lien. Le serveur d’arrivée pouvait alors dresser la liste des pages qui pointaient vers lui, tenir un journal, optimiser certains usages du cache ou retrouver une ancienne adresse mal recopiée. Ce sont les emplois que le texte donnait à ce petit bout d’information.
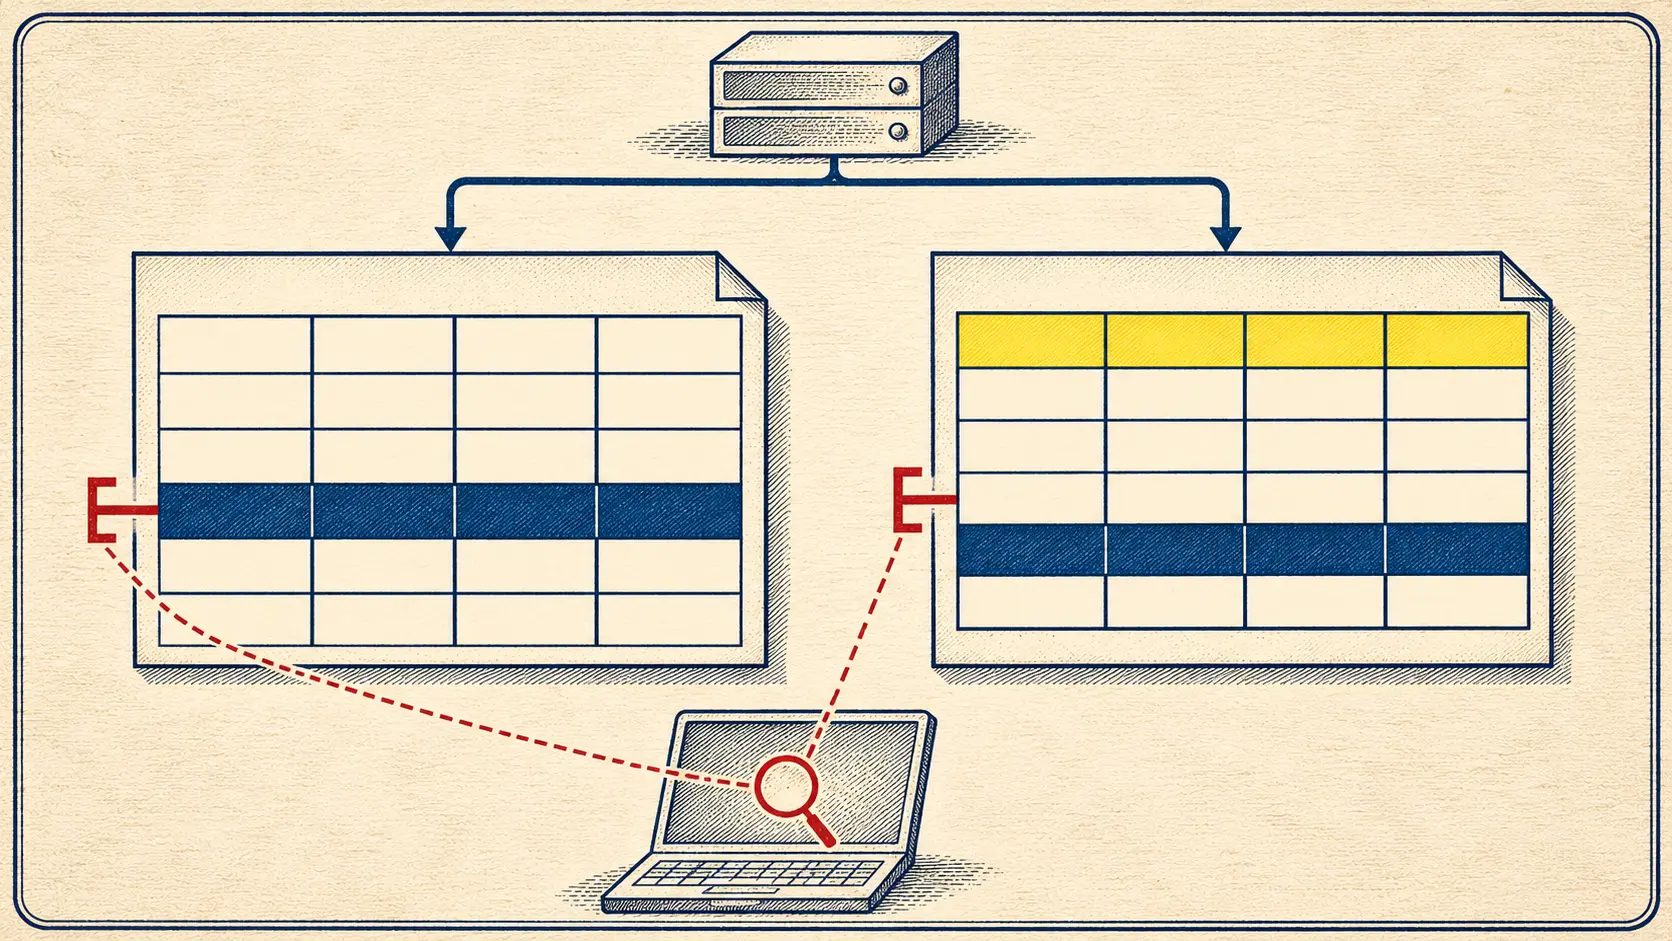
Le besoin était concret. Une bibliothèque déplace une notice ; des pages extérieures continuent de citer l’ancienne adresse. Si chaque demande arrive avec l’adresse de la page qui contient le lien, l’administrateur sait où prévenir ou quoi réparer. Il voit un morceau du réseau des liens à partir de sa propre porte, sans posséder les sites qui envoient des lecteurs. L’en-tête fabriquait une sorte d’index inversé au fil des visites.
Le mécanisme n’inventait pas une origine à toute visite. Le RFC précisait qu’il ne fallait pas envoyer Referer lorsque l’adresse demandée venait d’une source dépourvue d’URI, par exemple une saisie directe au clavier. Le fragment d’une URI devait aussi être retiré. Un clic depuis une page et une adresse tapée par une personne ne laissent donc pas le même renseignement au serveur d’arrivée.
La mise en garde suivait sans attendre la fin du document. Une page source peut être privée, ou son adresse révéler un lieu d’information privé. Les auteurs recommandaient fortement de laisser l’utilisateur choisir si le navigateur envoyait l’en-tête ; ils évoquaient même un interrupteur entre navigation ouverte et anonyme. La commodité et son coût figuraient côte à côte en 1996. Le problème n’a pas été découvert après coup par des gens qui auraient oublié l’utilité des liens entrants.
La faute d’orthographe a survécu
Le RFC 2068, version HTTP/1.1 publiée en janvier 1997, nomme franchement la faute : Referer est la graphie erronée de « referrer ». Le champ échangé par le navigateur et le serveur garde pourtant son nom. Son rôle reste le même : indiquer une source pour les listes de liens entrants, les journaux et la maintenance. L’interdiction d’en inventer une après une saisie au clavier demeure, comme l’exclusion du fragment.
La coquille est amusante, mais le transfert d’information l’est beaucoup moins. Une page de départ confie son adresse à un serveur d’arrivée. Celui-ci a de bonnes raisons de vouloir savoir d’où viennent ses lecteurs. Il n’a pas forcément besoin du chemin exact d’un dossier privé pour réparer un lien ou compter une visite. Le nom mal épelé a été conservé par les échanges réels ; la question de la précision de l’adresse restait à trancher.
La section du RFC 2068 consacrée aux risques de sécurité disait que Referer permettait d’étudier les parcours de lecture et de reconstruire des liens en sens inverse. Même débarrassée de données personnelles explicites, l’adresse pouvait désigner un document privé. Un chemin de profil, un dossier réservé ou un paramètre de session suffisent à rendre l’URL révélatrice. La fuite ne demande pas que la personne ait écrit son nom dans le texte visible du lien. Elle se produit dans les métadonnées de la requête.
Les deux RFC décrivent un mécanisme et ses limites, pas un registre de ce que chaque navigateur envoyait effectivement. Leur enseignement historique est plus net : le serveur destinataire souhaitait un reçu de provenance pour faire fonctionner le Web ; l’origine et son lecteur pouvaient perdre une information sensible en lui donnant ce reçu.
Une adresse porte plus que le nom d’un site
Dire qu’un visiteur vient d’un domaine n’est pas dire de quelle page il vient. Une URL complète peut contenir le chemin d’un profil, d’un espace de travail ou d’un document non public. Elle peut inclure des paramètres utiles à une session. Le serveur qui reçoit le clic voit alors une partie du contexte quitté par le lecteur, alors que le lien visible ne lui promettait qu’une visite.
Cette asymétrie met le choix au mauvais bout de la liaison. Le destinataire peut enregistrer ce qu’il reçoit. Le site de départ sait ce que signifient ses propres chemins et peut savoir qu’une adresse ne doit pas voyager telle quelle. L’utilisateur veut atteindre la page suivante ; il n’a pas nécessairement décidé de fournir l’URL précise de la précédente. Le commutateur individuel proposé en 1996 répondait à cette tension par un choix global du navigateur. Le réglage par page permettra de poser une question plus fine.
Trois réponses se distinguent. Envoyer l’URL complète donne au destinataire une provenance détaillée. Envoyer seulement l’origine, c’est-à-dire le schéma, l’hôte et le port, lui dit quel site a envoyé la visite sans révéler le chemin. Ne rien envoyer lui retire même cette indication. Les trois options changent la valeur du journal de liens entrants et la quantité d’information abandonnée au serveur d’en face.
Le site d’origine prend la molette
Le projet de recommandation W3C « Referrer Policy » du 26 janvier 2017 donne un exemple parlant. La page de profil d’un réseau social contient un lien vers le site d’un groupe de musique. Le groupe pourrait apprendre que la visite vient du réseau social sans obtenir l’URL du profil, susceptible d’identifier son propriétaire. Le document imagine aussi une application dont l’URL porte un identifiant de session ou une capacité d’accès. Ici, l’adresse est elle-même une partie de ce qu’il faut protéger.
La spécification détaille des comportements différents. no-referrer supprime l’en-tête. same-origin garde l’URL complète pour les demandes adressées au même site et n’envoie rien aux autres. origin transmet le schéma, l’hôte et le port sans le chemin ni les paramètres. strict-origin ajoute une limite pour les départs protégés vers une destination moins sûre. D’autres valeurs combinent des règles distinctes pour les échanges internes et externes. Le sujet n’est plus seulement « envoyer ou non » ; c’est « quelle portion de l’adresse, et à qui ? ».
Un auteur pouvait exprimer ce choix par l’en-tête de réponse Referrer-Policy, un élément meta, un attribut sur certains éléments ou la relation noreferrer d’un lien. La politique a la bonne orthographe ; le champ de requête qu’elle commande garde Referer. Le Web a corrigé l’anglais sur l’instruction nouvelle sans casser le vieux nom sur le fil.
Le document de 2017 était un projet de recommandation à cette date. Il décrit les effets attendus des différentes politiques. Pour dater leur arrivée dans chaque navigateur, il faudrait un registre de versions et d’implémentations. Le texte suffit à dater une évolution de la conception : la page qui risque de révéler son contexte obtient un moyen de demander au navigateur quelle précision laisser sortir.
Le lien retour se paie en information
Le journal de provenance rend toujours un service au destinataire. Il aide à réparer des adresses, à comprendre les chemins des lecteurs et à retrouver des citations anciennes. Le RFC de 1996 avait raison de nommer ces bénéfices et raison, dans le même souffle, de signaler le danger. Une adresse de retour n’est pas un simple numéro de ticket lorsqu’elle pointe vers une page privée.
La politique ultérieure déplace la décision vers le site d’origine. Celui-ci peut laisser passer le nom du domaine et retenir le chemin d’un profil ; il peut aussi choisir le silence. Le serveur destinataire reçoit moins de détails dans son journal. Ce n’est pas un accident secondaire : c’est le prix exact de la réduction de la divulgation. La maintenance d’un site ne donne pas à son opérateur un droit automatique au trajet précis de chacun des lecteurs venus d’ailleurs.
Le nom Referer garde sa faute. L’invention plus importante est la séparation entre « quel site m’a envoyé cette visite ? » et « quelle page exacte la personne vient-elle de quitter ? ». Un lien retour devient une décision de divulgation dès que la réponse peut révéler davantage que le nom du site.
Sources
- RFC 1945, HTTP/1.0, mai 1996 : définition de
Referer, usages de maintenance et mise en garde sur les adresses privées. - RFC 2068, HTTP/1.1, janvier 1997 : faute d’orthographe reconnue, règles de l’en-tête et risque de divulgation d’une URI privée.
- W3C, projet de recommandation « Referrer Policy », 26 janvier 2017 : choix entre URL complète, origine seule et absence de provenance.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé au Cercle stratégique
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance