Résumé
- Publiée en avril 2013, la RFC 6920 a défini les identifiants Named Information, ou
ni, qui associent un algorithme de hachage à une valeur calculée sur un objet numérique. Pour comparer deux noms, la valeur et l'algorithme priment sur l'autorité facultative du lien. - Le nom peut être converti en URL HTTP(S) sous
/.well-known/ni/pour demander l'objet à un serveur. Le registre de l'IANA coordonne les noms et longueurs d'algorithmes ; il ne tient pas l'inventaire des serveurs qui possèdent le fichier. - Un client doit recevoir le nom attendu, trouver des octets candidats et effectuer le calcul pour vérifier leur correspondance. Une trace datée de ces trois étapes établirait l'usage d'un système précis.
Le nom d'un lieu pouvait changer son contenu
La commodité du Web tient à la souplesse d'une URL. On demande à un hôte une ressource située à un chemin donné. L'hôte peut corriger, remplacer ou retirer ce qu'il sert à ce chemin. Pour un journal vivant, c'est normal. Pour un exemplaire précis d'un logiciel, d'un document ou d'un jeu de données, la même souplesse brouille la question : le fichier obtenu est-il bien celui qui était visé lorsque l'adresse a été communiquée ?
Avant la RFC 6920, plusieurs systèmes inséraient déjà des résultats de hachage dans leurs identifiants. Ils le faisaient chacun à leur manière. La RFC 6920 a donné à cette pratique une grammaire commune. Un nom ni contient le nom de l'algorithme, un séparateur et la valeur du condensat codée en base64url sans remplissage. Par défaut, le calcul porte sur les octets de l'objet qu'on s'attend à récupérer. Une autre définition de l'entrée demande une règle dans le protocole qui emploie le nom.
L'identifiant répond ainsi à une question différente de celle d'une adresse ordinaire. L'adresse indique où tenter une requête. L'empreinte indique quels octets doivent satisfaire la requête. Le fichier peut voyager vers un autre hébergeur et conserver son identité. Un hébergeur peut conserver la même URL et changer le fichier ; ce changement produit alors un autre condensat. La stabilité ne dépend plus de la promesse implicite d'un chemin.
La règle de comparaison est le cœur de l'affaire. Deux noms ni désignent le même objet lorsque l'algorithme, la longueur et la valeur du condensat coïncident. Le champ d'autorité, lorsqu'il existe, ne tranche pas cette identité. Les paramètres de requête non plus. Deux serveurs différents peuvent donc annoncer la même chose sans posséder chacun un droit de redéfinir ce qu'est cette chose.
L'hôte revient quand il faut livrer les octets
Un nom fondé sur l'empreinte a encore besoin d'un chemin jusqu'au fichier. La RFC 6920 définit une conversion vers une URL HTTP ou HTTPS sous /.well-known/ni/. Quand le nom ni contient une autorité, elle fournit l'hôte de cette URL. En son absence, l'application peut choisir l'hôte selon son contexte. Une redirection peut suivre. À la fin de cette chaîne, un client capable de vérifier recalcule le condensat sur les données obtenues.
La conversion ne promet pas que l'objet se trouve à l'adresse obtenue. La RFC le dit explicitement. On peut posséder la bonne empreinte et tomber sur une armoire vide. C'est un échec de disponibilité, distinct de la réception d'un mauvais fichier. Ce dernier cas laisse une trace plus accusatrice : un serveur a répondu, mais ses octets ne portent pas l'identité demandée.
Il y a donc trois décisions et trois acteurs. La personne ou le système qui remet le nom choisit les octets attendus. Le distributeur choisit ce qu'il garde accessible. Le logiciel client choisit s'il calcule et compare effectivement l'empreinte. La RFC autorise le traitement d'un nom sans contrôle systématique de la liaison entre nom et données. Écrire ni dans un champ ne rend pas, à lui seul, un client vérificateur.
Le document prévoit aussi des formats adaptés à d'autres contraintes. Une forme binaire raccourcit la représentation dans certains protocoles ; nih facilite la lecture orale avec des caractères hexadécimaux et un chiffre de contrôle. Ces formes transmettent la même idée d'identité dérivée d'un contenu. Aucune ne remplace les machines qui stockent et servent ce contenu.
L'IANA coordonne le vocabulaire, pas l'entrepôt
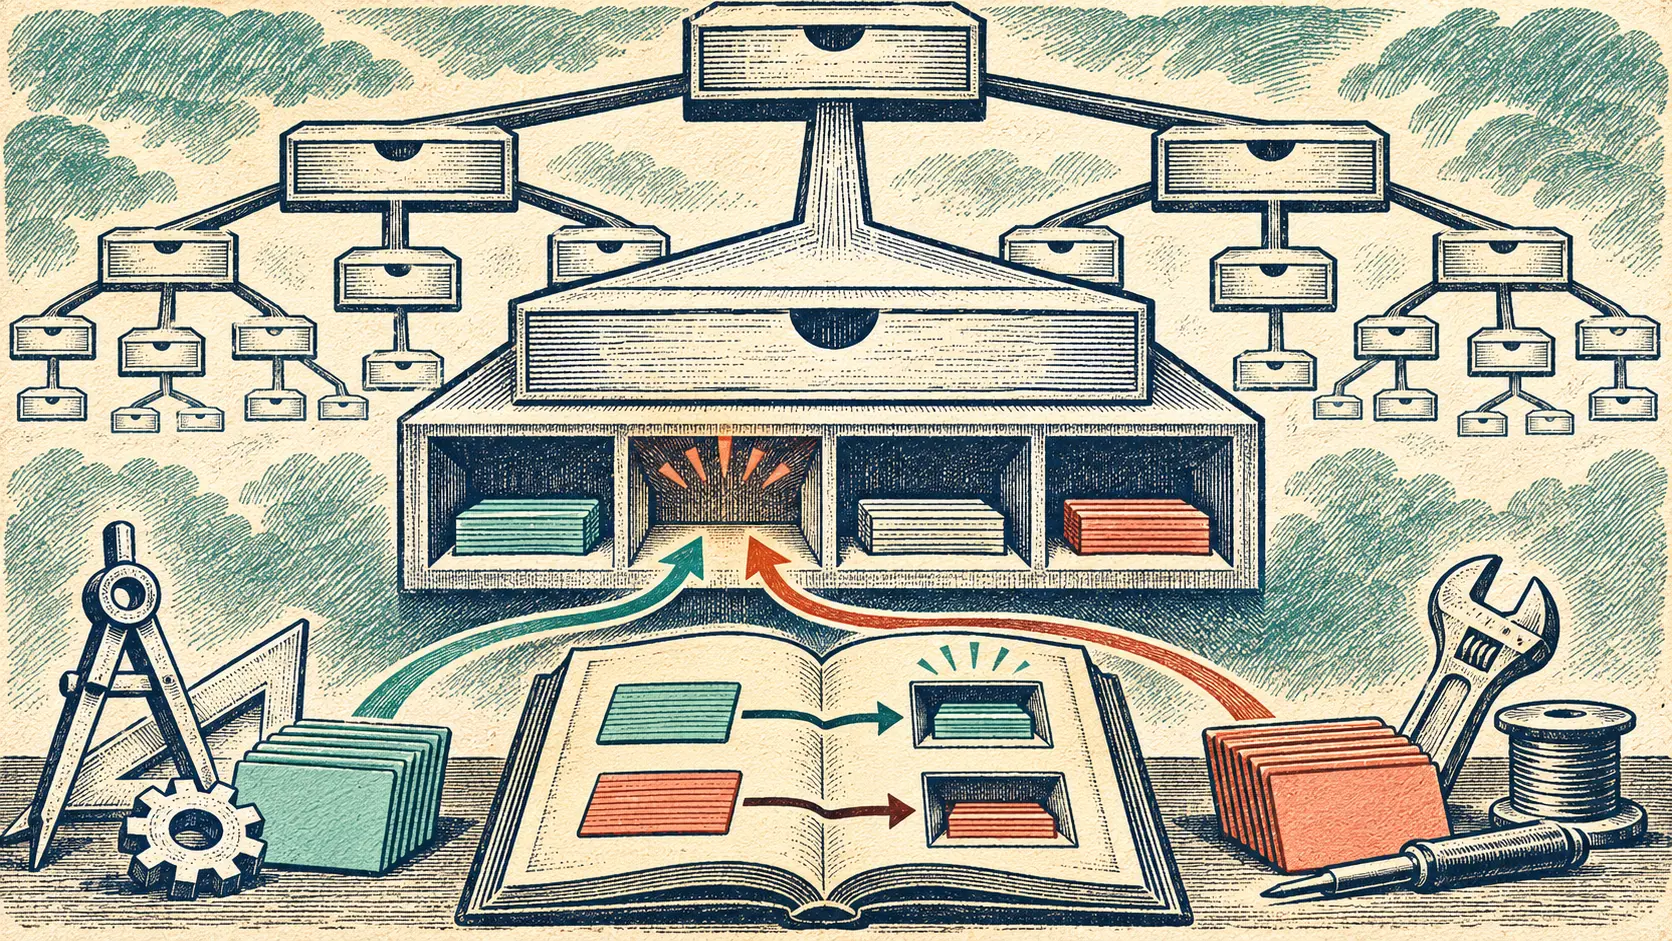
Pour que deux logiciels comparent un nom, ils doivent s'accorder sur le nom de l'algorithme et sur la longueur du résultat. Le registre Named Information de l'IANA fournit ces désignations, leurs références et un paramètre de type de contenu. La RFC 6920 impose la prise en charge de SHA-256 complet et prévoit des formes tronquées explicitement nommées. Une valeur courte augmente le risque de collision ; sa longueur fait partie de ce que le lecteur doit reconnaître.
Une ligne du registre donne un langage commun à des implémentations indépendantes. Elle n'enregistre ni copie du fichier ni fournisseur capable de la livrer. Confondre la liste des algorithmes avec un annuaire d'objets serait demander à une administration de noms de faire le travail d'un réseau de stockage. Cette séparation a une vertu institutionnelle : la coordination minimale reste possible sans que le détenteur du registre acquière le contrôle des contenus.
La limite de sécurité est tout aussi nette. La RFC 6920 explique que la liaison entre un nom et des octets dépend de la confiance accordée au nom reçu. Quelqu'un qui fournit à la fois un fichier malveillant et son empreinte correcte remet une paire parfaitement cohérente. Le calcul prouve une correspondance ; la provenance du nom doit être établie ailleurs. Un condensat publié peut même aider à retrouver un objet devinable dans un dépôt. Il ne le rend pas secret.
Les textes officiels établissent le format, la comparaison et la conversion HTTP. Pour montrer qu'une archive ou une application déterminée s'en est servie, il faut sa trace datée de distribution et le calcul effectué par le client. La proposition de 2013 reste précise : séparer la question « quels octets ? » de la question « chez qui les demander ? ».
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé au Cercle stratégique
Cercle stratégique
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre le Cercle stratégiqueRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance