
Résumé
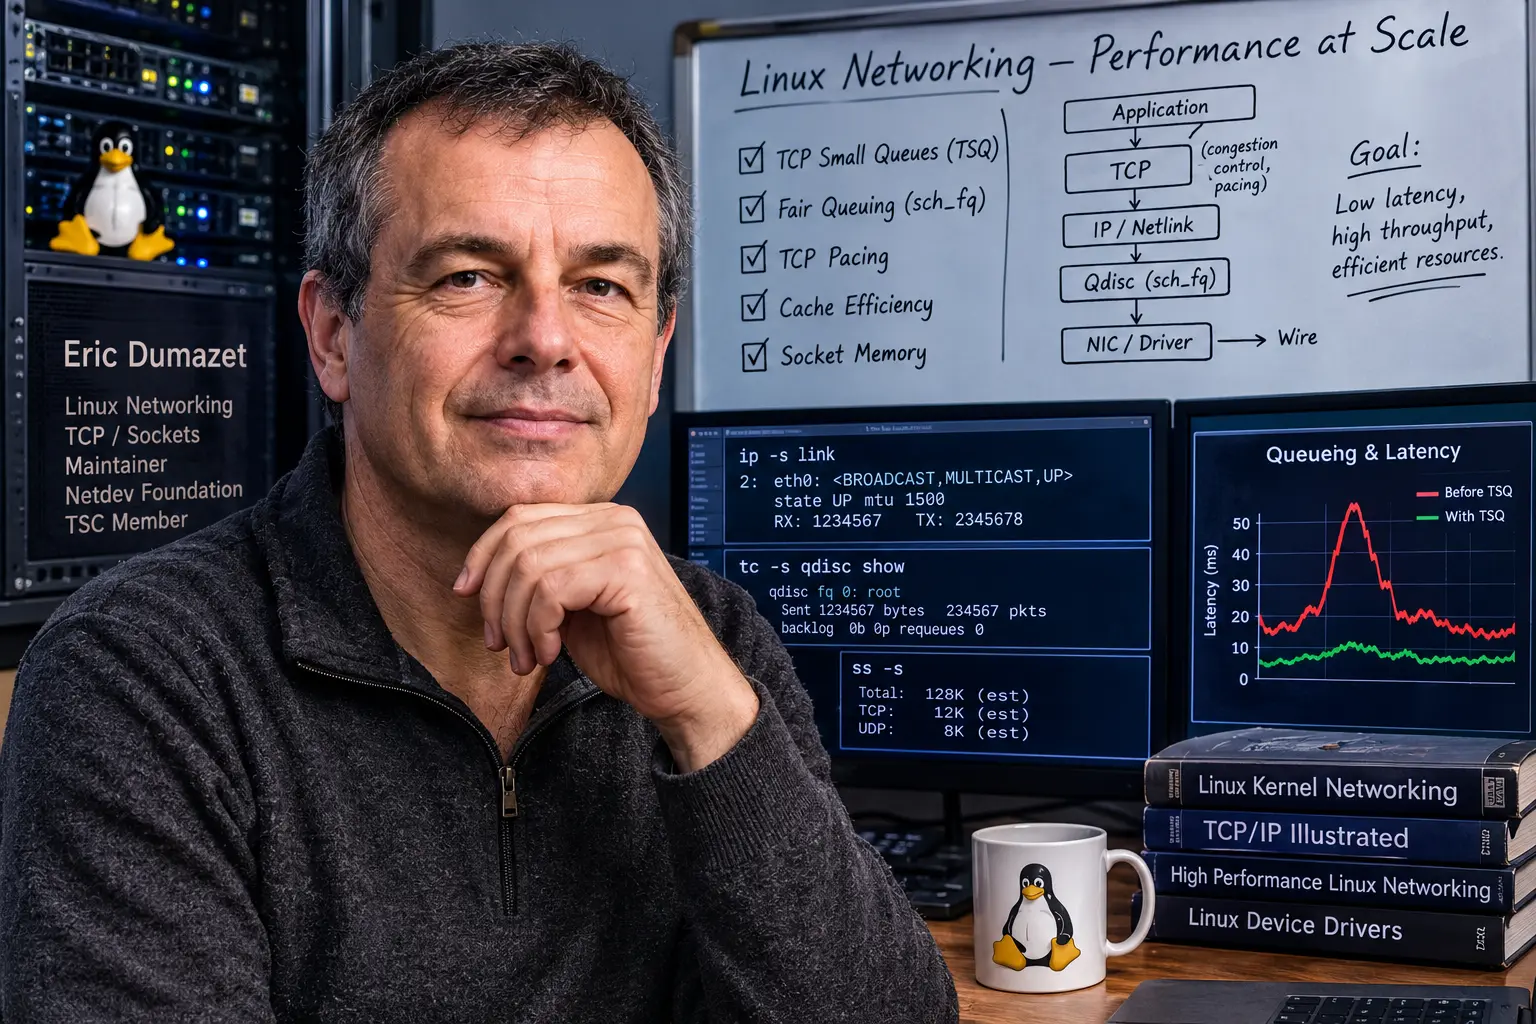
- Eric Dumazet figure actuellement comme mainteneur de Linux pour le réseau général, TCP et les sockets, et fait partie du comité technique de la Netdev Foundation. Ces rôles sont partagés avec d'autres mainteneurs et relecteurs: ils impliquent une grande responsabilité d'intégration, pas un contrôle individuel sur la pile réseau.
- Sa contribution nommée la plus claire est TCP Small Queues, introduite en 2012 pour empêcher qu'un seul flux TCP dépose une quantité excessive de données dans des files d'attente situées sous la couche transport. En liant le crédit local du socket à l'achèvement des paquets, TSQ a réduit la latence et la pression mémoire côté émetteur sans supprimer toutes les files d'attente du chemin.
- Ses travaux ultérieurs sur
sch_fqet le pacing interne ont fait du moment d'envoi un contrôle explicite. Le fair queueing sépare les flux et le pacing répartit les paquets dans le temps. Ces éléments servent plusieurs algorithmes de contrôle de congestion, y compris des environnements avec BBR, mais BBR a sa propre paternité et son histoire. - Son travail le plus récent relie la conception des structures, le trafic de lignes de cache et l'état par socket à l'efficacité des grandes flottes. La conclusion est que le réseau sous Linux est aussi une comptabilité de CPU, de mémoire, de profondeur de file d'attente et de temps. L'effet économique peut être matériel, bien que les preuves publiques ne permettent pas de lui attribuer un chiffre monétaire ni de promettre le même résultat sur tous les systèmes.
Un serveur rapide peut encore perdre du temps derrière ses propres paquets
L'histoire commence dans une file d'attente de transmission. L'application a écrit des données, TCP considère qu'il peut en envoyer davantage et le noyau les a remises aux couches inférieures. D'en haut, elles semblent envoyées, mais elles peuvent continuer d'attendre sur la même machine.
Le lien reste occupé et le problème est caché. Une requête interactive attend derrière un transfert massif, les tampons retiennent de la mémoire et la notion de « données en vol » cesse de correspondre à ce qui est simplement accumulé localement. TCP Small Queues a changé cette relation en limitant la quantité qu'un socket pouvait placer sous TCP et en lui rendant la permission d'envoyer lorsque le matériel achevait un travail réel.
Le registre public explique l'ingénierie et évite d'inventer une biographie
Les meilleures preuves proviennent du noyau lui-même:MAINTAINERS, débats de correctifs, documentation, conférences et relecture publique. Ces registres soutiennent son travail continu sur le réseau, TCP et les sockets, son poste à la Netdev Foundation et une affiliation visible à Google via l'adresse e-mail de mainteneur.
Ils n'offrent pas une biographie complète, un titre d'entreprise actuel vérifié, un recensement total des correctifs ou la répartition exacte de son temps. Combler ces lacunes avec des détails plausibles serait peu rigoureux. Le profil se concentre donc sur les mécanismes et les décisions observables. Dumazet apparaît comme un ingénieur à responsabilité technique dont le travail ne devient une infrastructure qu'après que d'autres l'ont relu, modifié, testé et déployé.
Être mainteneur le place près des décisions, pas au-dessus de la communauté
Au 4 août 2026, les registres de Linux l'incluaient dans le réseau général, TCP et les sockets. Un mainteneur peut demander la refonte d'une interface, refuser une charge de maintenance injustifiée, appliquer des changements acceptés et représenter le sous-système auprès de la ligne principale.
La même source montre une autorité partagée. David S. Miller, Jakub Kicinski et Paolo Abeni figurent dans le réseau général; Neal Cardwell partage TCP, et d'autres relecteurs interviennent selon le sujet. Les correctifs passent en outre par l'architecture, les pilotes, la sécurité, les tests, les branches stables et le processus final du noyau. L'influence de Dumazet est notable parce qu'elle fonctionne au sein de ce réseau de contrôles.
Linux est devenu une infrastructure économique lorsque les connexions ont augmenté
Sur une petite machine, quelques octets supplémentaires par socket ou un défaut de cache se remarquent à peine. Sur un serveur avec des centaines de milliers de connexions, le coût se multiplie jusqu'à concurrencer l'application, la mémoire et l'énergie.
« Économie des serveurs » ne signifie pas qu'il existe un chiffre public d'économies. Cela décrit des conséquences de flotte: combien de connexions tiennent, combien de CPU reste pour le service, combien de mémoire consomme le réseau et combien de fois une file d'attente locale brise un objectif de latence. Les distributions et les opérateurs choisissent les versions, les qdisc, le contrôle de congestion et les NIC. Dumazet ne contrôle pas ces décisions; il change le point de départ commun.
Le travail familier de TCP cache un système de comptabilité très complexe
TCP offre un flux fiable, mais il doit décider combien d'octets peuvent rester en attente, quand retransmettre, comment facturer la mémoire, comment ordonner les paquets et comment partager CPU et files d'attente entre des milliers de sockets.
Une implémentation peut être correcte et mal performer: trop de backlog local, des rafales, des verrous partagés ou des structures qui gaspillent le cache. Le fil conducteur de l'œuvre de Dumazet est comptable. Les octets sont imputés au socket, les achèvements rendent du crédit, les temps d'envoi sont calculés et les champs chauds sont séparés des champs froids. L'objectif est d'utiliser les ressources nécessaires sans construire un second réseau caché dans l'hôte.
Avant TCP Small Queues, l'émetteur pouvait construire un backlog qu'il ne contrôlait plus
Avant TSQ, TCP pouvait remettre beaucoup de trafic au qdisc et au pilote. La fenêtre de congestion pouvait être raisonnable et, malgré tout, une longue file locale maintenir des paquets sous la couche transport. L'application ne pouvait plus les retirer lorsqu'un flux urgent apparaissait.
Cette accumulation affaiblissait le retour d'information: TCP voyait des accusés de réception du chemin, mais une partie des données n'était même pas sortie de l'hôte. Elle consommait aussi de la mémoire, surtout lorsque de nombreux flux répétaient le motif. Il fallait maintenir le débit sans permettre à chaque socket d'utiliser les couches inférieures comme entrepôt illimité.
La série TSQ de 2012 a rendu au socket un budget de file d'attente locale
Les correctifs de 2012 ont limité par socket la quantité de données mises en file sous TCP. Lorsque le crédit local était épuisé, le socket s'arrêtait; à l'achèvement des paquets, il récupérait la capacité d'envoyer.
L'idée était simple: compter les octets locaux et prendre l'achèvement comme preuve de progrès. Le contrôle revenait au transport qui connaissait le flux. Il n'était plus nécessaire de déposer un gros lot à l'avance pour garder le lien occupé. L'importance de TSQ réside précisément dans le fait que des applications étrangères au mécanisme ont reçu un comportement plus discipliné sans modifier leur code.
L'achèvement des paquets est devenu un signal utile dans l'hôte
L'achèvement pourrait sembler un simple nettoyage. TSQ l'a transformé en information: une partie du chemin inférieur a progressé et le socket peut émettre davantage.
Ce retour local complète les accusés de réception distants. Les uns décrivent la progression à travers le réseau; l'autre, la progression sous TCP. Les statistiques du qdisc, du pilote et du NIC comptent d'autres parties. Aucun signal ne suffit à lui seul. TSQ a utilisé l'un d'eux pour contrôler l'excès local sans remplacer le contrôle de congestion de bout en bout.
TSQ a réduit une source de bufferbloat, pas toutes les files du trajet
TSQ n'a pas éliminé le bufferbloat. Il agit sur le backlog de l'émetteur sous TCP. Il reste des files d'attente dans le qdisc, le pilote, le NIC, l'accès, les routeurs, les commutateurs et le récepteur.
L'affirmation utile est plus précise: TSQ réduit la capacité d'un socket à créer une file cachée trop grande. Il peut diminuer la latence et la mémoire et rapprocher l'état de TCP de la progression du périphérique. Il ne remplace ni la gestion active des files d'attente, ni une configuration sensée, ni la congestion de bout en bout.
Seuils, déchargements et charges déterminent combien TSQ aide
Le résultat dépend de la limite, de la taille des paquets, du qdisc, des files d'attente matérielles, du TSO et du mélange de flux. Un service interactif et une réplication massive ne répondent pas de la même manière.
L'implémentation a aussi changé après 2012. D'autres développeurs ont ajusté les limites et corrigé les interactions. La paternité du concept peut être attribuée à Dumazet sans présenter le mécanisme actuel comme une pièce figée et exclusivement sienne.
sch_fqa séparé les flux et intégré le temps à l'ordonnanceur
En 2013, Dumazet a publié l'ordonnanceursch_fq. Il maintient un état par flux et une structure ordonnée dans le temps pour libérer les paquets selon leur date cible. Les nouveaux flux peuvent recevoir du service rapidement, tandis que les flux régulés attendent leur tour.
Il résout deux problèmes: éviter qu'un gros transfert monopolise la file locale et fournir un endroit où le noyau peut respecter les temps d'envoi. Il ne garantit pas l'égalité entre applications; il offre une politique plus disciplinée et un support pratique pour le pacing.
Le fair queueing est une politique, pas une promesse de résultats égaux
« Équitable » peut sembler plus absolu que ce qu'il est. Séparer les flux dans une file n'égale pas les performances des applications. La taille des paquets, le chemin, le récepteur, le contrôle de congestion, les déchargements et le nombre de connexions continuent d'.
Même l'identité d'un flux est une décision: une application peut ouvrir de nombreuses connexions et une autre une seule.sch_fqlimite la domination locale, mais ne résout pas l'équité entre utilisateurs ou entreprises. Pour l'opérateur, c'est un outil d'arbitrage, pas une garantie universelle.
Le pacing convertit une estimation de débit en une séquence d'instants d'envoi
Un algorithme peut décider du bon débit et pourtant le lâcher en rafale. La moyenne se maintient, mais la file subit un pic.
Le pacing répartit les paquets dans le temps. Il peut stabiliser les files, améliorer la coexistence et mieux exprimer le modèle de congestion. L'implémentation exige des horodatages, des minuteries, un qdisc, une segmentation et des NIC cohérents. Le débit logiciel ne compte que s'il se convertit en temps réels sur le lien.
Le pacing et le contrôle de congestion résolvent des parties distinctes
Le contrôle de congestion décide combien utiliser le chemin; le pacing décide quand les données autorisées sortent. Un bon modèle peut être ruiné par des rafales, et un pacing parfait peut exécuter un mauvais débit.
L'infrastructure de Dumazet permet à plusieurs algorithmes d'exprimer un débit dans le temps. La paternité de chaque modèle revient à ses concepteurs, même s'il dépend de cette infrastructure.
BBR utilise le pacing, mais possède sa propre paternité et évolution
BBR est souvent associé à Dumazet en raison de sa dépendance au pacing et de l'environnement Google. Cela n'en fait pas l'inventeur unique. BBR a ses propres auteurs, modèle et versions.
La contribution de Dumazet est de base: files d'attente, pacing, instrumentation et sockets rendent déployables des algorithmes ultérieurs. Cette description reconnaît son importance et conserve le crédit de Neal Cardwell et des autres auteurs de contrôle de congestion.
TSO économise du CPU et peut reconstruire la rafale que le pacing tentait d'éviter
Le déchargement de segmentation TCP (TSO) permet de remettre un grand segment au NIC pour qu'il le divise ensuite. Il réduit fortement le coût par paquet, mais interpose le matériel entre la décision temporelle et l'émission.
Si le segment sort comme une unité, le NIC peut produire une rafale. TSQ, qdisc, TSO, pilote et matériel doivent être traités comme un système. Une économie de CPU peut aggraver la latence si elle n'est pas coordonnée avec la forme du trafic.
Quantum, horodatages et comportement du NIC doivent décrire la même réalité
Le noyau travaille avec des quanta, une résolution de minuterie, des horodatages, des unités de déchargement et des files d'attente physiques. Un grand quantum crée des rafales; un petit gaspille du CPU; un NIC qui interprète une autre granularité altère la sortie.
C'est pourquoi le qdisc fait partie de la planification de capacité. Les développeurs doivent mesurer le chemin complet, et les bancs d'essai qui ne nomment que le contrôle de congestion ou la vitesse du lien omettent une grande partie du système.
Le pacing interne de TCP a réduit la dépendance à un qdisc particulier
En 2017, Dumazet a publié le pacing interne dans TCP. Le transport a gagné davantage de capacité à retenir le trafic selon son débit et ses minuteries, sans dépendre entièrement d'une discipline spécifique.
Le qdisc est resté pertinent pour l'ordre et la politique. La logique s'est rapprochée du sous-système détenteur de l'intention, mais la sortie finale est restée répartie entre TCP, l'ordonnanceur, le pilote et le NIC. C'est une évolution par couches, pas une substitution propre.
La discipline de file d'attente reste une décision opérationnelle aux conséquences réelles
Linux offre des qdisc pour différents objectifs.sch_fqfavorise le pacing; FQ-CoDel combine la séparation des flux avec la gestion active des files d'attente. Ce n'est pas la même chose.
Les valeurs par défaut varient selon la distribution et l'environnement. Les images cloud, les appliances et les hôtes de conteneurs peuvent choisir différemment, et le matériel peut déplacer l'exécution. L'amont offre des mécanismes; l'opérateur décide s'ils deviennent un comportement réel du service.
Quelques octets par socket deviennent une limitation de flotte
Chaque connexion maintient des séquences, des minuteries, un état de congestion, des files d'attente et des compteurs. À grande échelle, chaque octet se multiplie et chaque champ fréquent occupe du cache.
Réduire la mémoire par socket peut augmenter la densité; améliorer la disposition peut diminuer les défauts de cache et la cohérence entre CPU. C'est le pont le plus solide vers l'économie des serveurs, mais il ne permet pas de calculer une économie universelle ni une valorisation personnelle du travail.
Une ligne de cache devient une infrastructure lorsqu'elle est touchée à chaque paquet
Le processeur déplace des lignes complètes, pas des champs individuels. Des données chaudes à côté de champs froids font circuler des octets inutiles; deux CPU modifiant la même ligne génèrent du trafic de cohérence même s'ils touchent des valeurs différentes.
L'œuvre récente de Dumazet adopte cette vision physique. Séparer les champs chauds et froids réduit le trafic mémoire qui croît avec les paquets et les sockets. Le bénéfice dépend du processeur et de la charge, de sorte que le profil d'une flotte ne peut pas être transformé tel quel en loi universelle.
Le travail de 2024 sur les structures montre une phase mûre d'ingénierie de la performance
La présentation de 2024 a commencé par des profils: quels champs sont chauds, quelles lignes se déplacent et quelles structures dominent la mémoire. Des outils peuvent suggérer des réorganisations, mais ne remplacent pas la relecture sur l'alignement, le verrouillage, la compatibilité et la maintenance.
Dans une infrastructure mûre, de grands gains peuvent venir d'éviter un défaut de cache ou de déplacer un champ, pas d'un nouvel algorithme. C'est moins visible qu'une marque de congestion, mais cela détermine la performance réelle.
Les profils hyperscale sont des preuves puissantes et une science publique incomplète
Les grands opérateurs voient des populations et du matériel difficiles à reproduire. Ils peuvent découvrir des coûts qui n'apparaissent pas en laboratoire. L'affiliation de Dumazet à Google le situe dans cet environnement.
Une partie des charges et des données reste privée. Une présentation peut montrer la méthode et le résultat sans livrer toutes les entrées. La solution n'est pas de rejeter la preuve, mais d'en limiter la portée et de convertir davantage de cas réels en tests publics et en CI.
Verrous et files de réception appartiennent à la même histoire de ressources
Bien que l'axe du profil soit la transmission, la trajectoire de Dumazet inclut les sockets et la réception. Les paquets entrants nécessitent du polling, de la mémoire, de la classification, des files d'attente et une livraison entre CPU. À haut débit, les verrous et l'état partagé deviennent un coût.
Linux réduit ce coût en déplaçant le travail, en regroupant les opérations et en réduisant la contention. Le principe est le même: utiliser la coordination nécessaire à la correction sans permettre à la comptabilité de consommer le service.
Le batching élève le débit et modifie la latence et le partage équitable
Regrouper les paquets ou les achèvements amortit les verrous, les appels et le cache. NAPI, les pilotes et les déchargements en dépendent.
Le lot, cependant, attend et peut arriver en rafale. De grands lots améliorent l'amortissement et augmentent l'attente ou la domination. TSQ, le fair queueing et le pacing ne rejettent pas le batching; ils le bornent pour conserver le retour d'information et la latence.
La performance TCP émerge de couches qui peuvent s'annuler mutuellement
L'algorithme définit l'intention; TCP crée les paquets; TSQ limite le backlog; le qdisc ordonne; TSO regroupe; le pilote mappe; le NIC émet; le réseau ajoute des files d'attente et des pertes.
Un pacing précis peut être annulé par une segmentation grossière; un qdisc à faible latence, par un excès d'enfilement; une disposition compacte, par un nouveau verrou. L'importance de Dumazet réside dans le travail sur ces coutures et l'amélioration du chemin installé plutôt que de s'en séparer.
La relecture publique convertit une optimisation locale en infrastructure partagée
Une amélioration commence comme une affirmation: moins de latence, de mémoire ou de CPU. Pour entrer dans Linux, elle doit survivre à netdev: méthodologie, interface générique, architectures rares, tests et coût futur.
Un mainteneur peut diviser la série, rejeter une abstraction de fournisseur ou reporter un changement. C'est plus lent qu'un correctif privé et plus durable. L'autorité de Dumazet inclut de juger non seulement si quelque chose fonctionne aujourd'hui, mais si Linux pourra le maintenir pendant des années.
netetnet-nextséparent la réparation urgente du développement futur
Les correctifs vont normalement ànet; les fonctions, ànet-next. La séparation évite de mélanger la maintenance urgente avec des refactorisations d'une version future.
La classification exige du jugement. Un correctif peut changer le comportement et une fonction révéler un ancien défaut. Les mainteneurs divisent les séries pour que le risque soit explicite et pour empêcher qu'une date commerciale remplace la préparation technique.
La relecture, le rejet et la refonte n'apparaissent pas dans le compteur de commits
Les commits mesurent la paternité visible, mais pas la phrase qui oblige à refondre une interface ni le rejet qui évite une charge de plusieurs années. Appliquer un correctif signifie assumer l'intégration, pas inventer son idée.
Le profil combine des mécanismes attribués avec la gestion (stewardship). TSQ,sch_fq, le pacing et les dispositions sont clairs, mais ils n'épuisent pas des décennies de relecture et ne transforment pas tous les changements intégrés en œuvres personnelles.
Les tests réduisent le risque sans représenter toutes les machines que Linux verra
Les builds, les autotests, KUnit, syzbot, les laboratoires de pilotes et les déploiements en aval trouvent des défauts, mais ne couvrent pas tous les CPU, NIC, qdisc et charges.
Un changement utile pour l'hyperscale peut endommager un périphérique rare. Les mainteneurs ont toujours besoin d'expérience, de compatibilité et de retour arrière. Les tests renforcent la gouvernance; ils n'éliminent pas le jugement.
Les rétroportages stables exigent une autre décision après la ligne principale
Un correctif de la ligne principale n'entre pas automatiquement dans toutes les branches. La branche stable exige un correctif réel, borné et à faible risque. Les distributions prennent encore une autre décision.
Les changements de performance peuvent dépendre de code environnant absent d'une vieille branche. L'impact arrive par étapes: amont, stable, distribution, cloud et configuration. Personne ne contrôle la chaîne complète.
La responsabilité actuelle sur TCP et les sockets est répartie de manière délibérée
MAINTAINERSdistribue la charge entre Dumazet, Neal Cardwell et d'autres mainteneurs et relecteurs. Cela réduit la dépendance à une personne et combine des connaissances en congestion, sockets, pilotes et tests.
La pluralité exige une propriété claire. Les chevauchements peuvent laisser des lacunes si tous attendent un autre. Une succession saine répartit l'autorité et conserve les raisons derrière les décisions, pas seulement les noms dans un fichier.
La Netdev Foundation peut financer sans devenir une autorité de fusion
La fondation, sous l'égide de la Linux Foundation, soutient la CI, les outils, les déplacements et la recherche. Dumazet fait partie de son TSC. Une subvention ne garantit pas qu'un correctif soit accepté.
La distinction est saine: maintenir le réseau coûte de l'argent et du temps, mais la légitimité en amont continue de venir de preuves publiques. Le financement doit augmenter la capacité de décider, pas acheter des exceptions.
L'affiliation à Google apporte de la capacité sans propriété sur le TCP de Linux
L'adresse e-mail de Google prouve l'affiliation, pas un titre complet. Un hyperscaler peut financer des profils, du matériel et de la relecture qui profitent ensuite à tout Linux.
L'asymétrie est que ses charges et ses données ne sont pas entièrement publiques. La relecture ouverte compense: le correctif doit être générique et acceptable en dehors de Google. L'entreprise apporte du temps et des preuves; elle ne possède pas la pile.
Les opérateurs en aval décident si l'amélioration change leur service
Les distributions choisissent les noyaux; les clouds, les qdisc et la congestion; les appliances, les versions; les fournisseurs de NIC, les capacités; les applications, le trafic. Il n'existe pas de recensement complet de l'utilisation de TSQ ou desch_fq.
Un mécanisme peut être compilé et non actif, ou actif par défaut sans visibilité pour l'utilisateur. L'impact de Dumazet est large mais indirect: il change les options communes; chaque opérateur les convertit en expérience.
Les piles utilisateur concurrencent pour des charges spécialisées, pas pour toutes les fonctions de Linux
DPDK, VPP et des piles propriétaires peuvent éviter des parties du noyau pour atteindre des débits élevés, au prix de cœurs dédiés, de pages énormes et d'un autre modèle opérationnel.
Linux intègre les sockets, la sécurité, les espaces de noms, l'observabilité et les pilotes. Le travail de Dumazet réduit le coût du chemin général sans affirmer qu'il est parfait pour tout. Le contournement reste pour des usages spécifiques; Linux demeure la base de la majorité.
Linux reste le choix par défaut parce que l'intégration vaut plus que la vitesse brute
Une pile doit être rapide, compatible, sûre, observable et maintenable. Un chemin isolé peut donner plus de paquets par seconde et créer des coûts d'exploitation et de support.
Une application Linux hérite de TSQ, du pacing et de la comptabilité via des sockets normaux. Cette invisibilité fait partie de la force: le bénéfice continue même si l'utilisateur ne connaît pas le nom de l'auteur.
Un hôte plus rapide ne prouve pas que la route réseau est meilleure
Améliorer la file locale ne corrige pas un accès congestionné, un récepteur lent ni des routeurs qui perdent des paquets. TSQ et le pacing gouvernent l'émetteur, pas tout le chemin.
Ils peuvent réduire une source de délai et rendre le flux plus régulier. Ils ne garantissent pas le résultat applicatif. La performance de bout en bout continue de dépendre de l'application, du récepteur, du chemin et de la configuration.
Un banc d'essai ne représente pas chaque serveur, NIC et charge de travail
La taille des paquets, les connexions, le CPU, le cache, le NIC, les déchargements, le qdisc, les minuteries, le noyau et la charge changent le résultat. Un profil Google peut découvrir un coût réel sans prédire le pourcentage dans une autre flotte.
La bonne information conserve les conditions. Les présentations de Dumazet sont des preuves opérationnelles attribuées; des tests publics et des mesures indépendantes sont nécessaires pour généraliser.
La succession est un problème technique parce qu'une grande partie du design vit dans la mémoire
Des limites étranges peuvent exister à cause d'un ancien NIC, d'une API encore utilisée ou d'une régression oubliée. Le code n'explique pas toujours pourquoi.
Les mainteneurs vétérans portent ce contexte. La documentation, les tests, les archives et de nouveaux relecteurs convertissent la mémoire privée en connaissance institutionnelle. La succession doit préserver les principes et permettre de les réexaminer pour le matériel futur.
Le pacing matériel et la mémoire de périphérique peuvent déplacer à nouveau la frontière
Les NIC modernes programment les paquets, gèrent plus de files d'attente et exposent de la télémétrie ou de la mémoire locale. Ils réduisent le CPU et déplacent le comportement vers le micrologiciel.
Linux doit exprimer l'intention, observer ce qui s'est passé et récupérer lorsque le matériel et le logiciel diffèrent. Les API de pilote, les horodatages et les erreurs seront aussi importants que le débit. Les principes restent: retour d'information, limites aux files cachées et observabilité.
L'économie du cache peut offrir plus de gains que de nouvelles formules de transport
Des algorithmes de congestion continueront d'apparaître, mais la prochaine amélioration matérielle pourrait être une meilleure disposition, un meilleur verrou ou un meilleur lot. Cela n'a pas de marque attrayante et profite à plusieurs algorithmes.
Le travail de 2024 montre une pile mûre évaluée par des coûts physiques. La question passe de « quel protocole gagne » à « combien de machine consomme chaque connexion ».
La contribution durable de Dumazet est la discipline des ressources, pas une légende héroïque
Une version exagérée en ferait l'inventeur du TCP moderne et de BBR; une autre effacerait l'individu dans la communauté. Les preuves permettent une position précise.
Il a introduit TSQ, signé un travail fondateur sursch_fq, impulsé le pacing interne et montré la pertinence de la disposition. Il maintient également des domaines critiques au sein d'un système partagé. Son apport est de traiter les paquets et les sockets comme des demandes de temps, de mémoire, de file d'attente et de localité CPU.
L'impact final se disperse entre la conception, la relecture, l'intégration et l'exploitation. Un commit s'attribue; une flotte plus dense ou une panne évitée ne s'attribue pas. Cette difficulté n'autorise ni l'exagération ni l'effacement: elle démontre que la valeur d'infrastructure naît d'une chaîne collective avec des décisions individuelles identifiables.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance