
Zusammenfassung
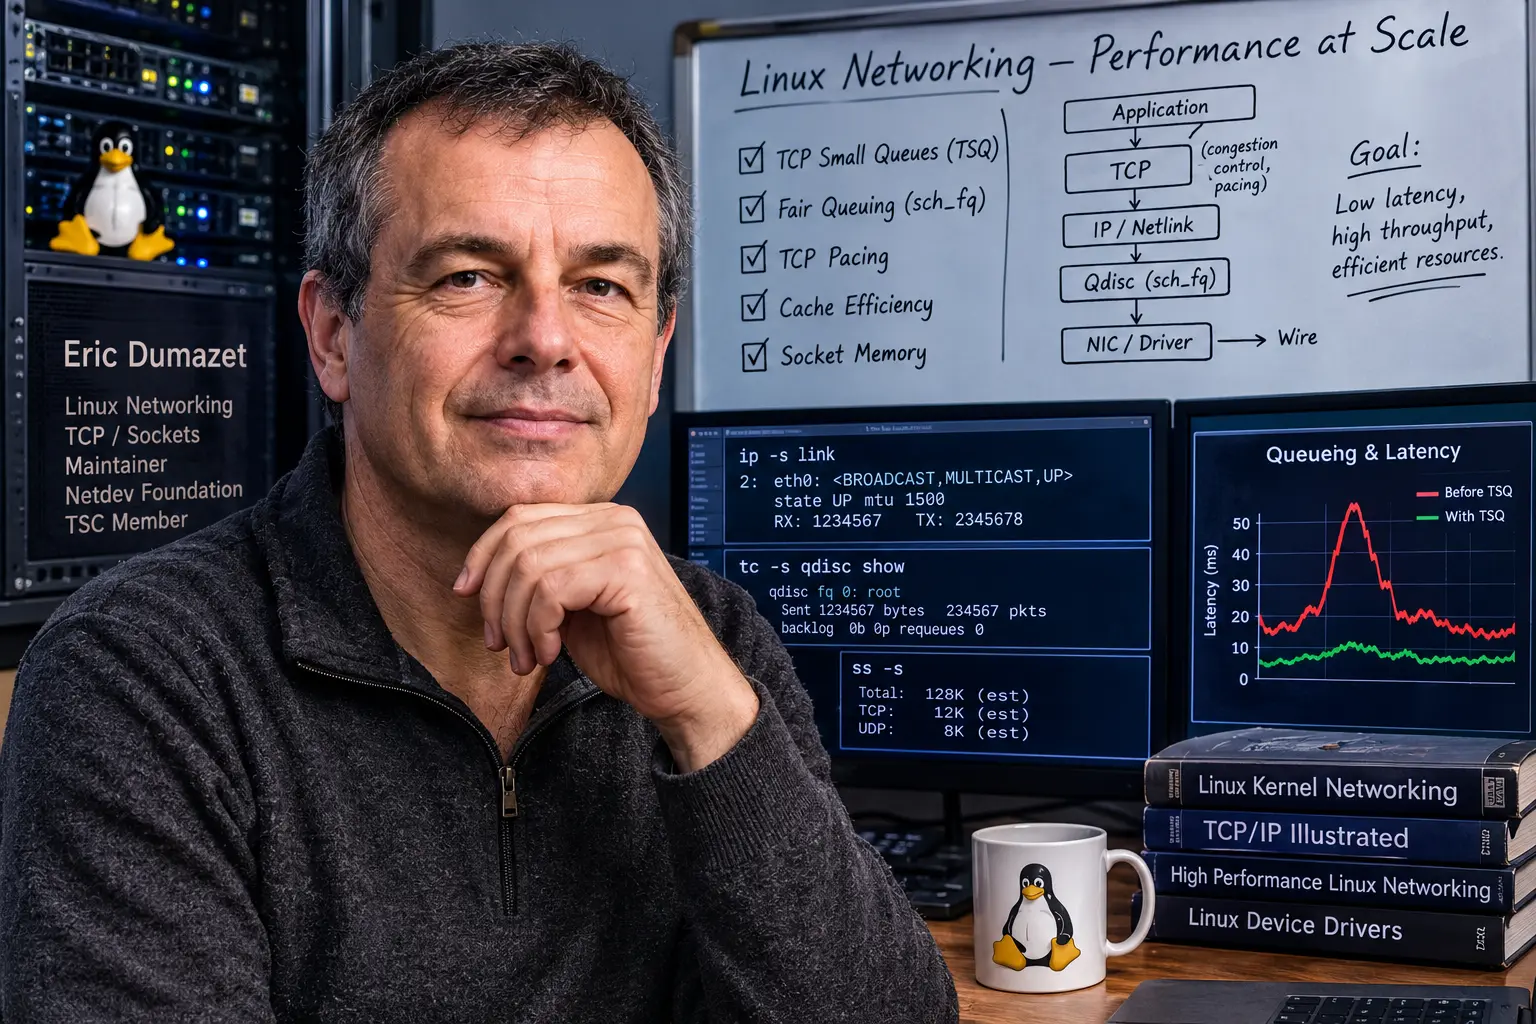
- Eric Dumazet ist derzeit als Linux-Maintainer für allgemeines Networking, TCP und Sockets tätig und gehört dem technischen Komitee der Netdev Foundation an. Diese Rollen teilt er mit anderen Maintainern und Reviewern: Sie bedeuten große Integrationsverantwortung, aber keine individuelle Kontrolle über den Netzwerk-Stack.
- Sein klarster namentlich zugeordneter Beitrag ist TCP Small Queues, eingeführt 2012, um zu verhindern, dass ein einzelner TCP-Fluss übermäßig viele Daten in Warteschlangen unterhalb der Transportschicht ablegt. Indem TSQ das lokale Socket-Guthaben mit dem Abschluss von Paketen verknüpfte, reduzierte es Latenz und Speicherdruck beim Sender, ohne alle Warteschlangen im Pfad zu beseitigen.
- Seine späteren Arbeiten zu
sch_fqund internem Pacing machten den Sendezeitpunkt zu einer expliziten Steuerung. Fair Queueing trennt Flüsse, und Pacing verteilt Pakete über die Zeit. Diese Bausteine dienen mehreren Congestion-Control-Algorithmen, auch Umgebungen mit BBR, aber BBR hat seine eigene Urheberschaft und Geschichte. - Seine jüngste Arbeit verbindet Strukturdesign, Cache-Zeilen-Verkehr und Zustand pro Socket mit der Effizienz großer Flotten. Die Schlussfolgerung: Networking unter Linux ist auch Buchhaltung über CPU, Speicher, Warteschlangentiefe und Zeit. Der wirtschaftliche Effekt kann erheblich sein, obwohl die öffentliche Beweislage weder eine Geldsumme noch dasselbe Ergebnis auf allen Systemen erlaubt.
Ein schneller Server kann immer noch Zeit hinter seinen eigenen Paketen verlieren
Die Geschichte beginnt in einer Sende-Warteschlange. Die Anwendung hat Daten geschrieben, TCP hält weitere Sendungen für möglich, und der Kernel hat sie an untere Schichten übergeben. Von oben scheinen sie gesendet, können aber weiter auf derselben Maschine warten.
Die Verbindung bleibt ausgelastet, und das Problem bleibt verborgen. Eine interaktive Anfrage wartet hinter einer großen Übertragung, Puffer halten Speicher belegt, und der Begriff „Daten in der Übertragung“ stimmt nicht mehr mit dem überein, was nur lokal angesammelt ist. TCP Small Queues veränderte dieses Verhältnis, indem es begrenzte, wie viel ein Socket unterhalb von TCP ablegen durfte, und Sendeerlaubnis zurückgab, wenn die Hardware echte Arbeit abschloss.
Die öffentliche Aufzeichnung erklärt die Technik und vermeidet eine erfundene Biografie
Die beste Evidenz stammt aus dem Kernel selbst:MAINTAINERS, Patch-Diskussionen, Dokumentation, Konferenzen und öffentliche Reviews. Diese Aufzeichnungen belegen seine fortlaufende Arbeit an Networking, TCP und Sockets, seinen Sitz im Netdev Foundation und eine sichtbare Zugehörigkeit zu Google über die Maintainer-E-Mail.
Sie liefern jedoch keine vollständige Biografie, keinen aktuell geprüften Konzerntitel, keine vollständige Patch-Zählung und keine genaue Zeitaufteilung. Diese Lücken mit plausiblen Details zu füllen wäre unseriös. Das Profil konzentriert sich deshalb auf beobachtbare Mechanismen und Entscheidungen. Dumazet erscheint als Ingenieur mit technischer Verantwortung, dessen Arbeit erst dann Infrastruktur wird, wenn andere sie prüfen, ändern, testen und einsetzen.
Maintainer zu sein bringt ihn in die Nähe von Entscheidungen, nicht über die Gemeinschaft
Am 4. August 2026 führten ihn die Linux-Aufzeichnungen im allgemeinen Networking, bei TCP und bei Sockets. Ein Maintainer kann einen Schnittstellen-Neuentwurf verlangen, ungerechtfertigte Wartungslast ablehnen, akzeptierte Änderungen anwenden und das Subsystem gegenüber Mainline vertreten.
Dieselbe Quelle zeigt geteilte Autorität. David S. Miller, Jakub Kicinski und Paolo Abeni erscheinen im allgemeinen Networking; Neal Cardwell teilt sich TCP, und weitere Reviewer greifen themenabhängig ein. Patches durchlaufen außerdem Architektur, Treiber, Sicherheit, Tests, stabile Zweige und den finalen Kernel-Prozess. Dumazets Einfluss ist bemerkenswert, weil er innerhalb dieses Netzes von Kontrollen wirkt.
Linux wurde zur wirtschaftlichen Infrastruktur, als die Verbindungen wuchsen
Auf einer kleinen Maschine fallen ein paar zusätzliche Bytes pro Socket oder ein Cache-Miss kaum auf. Auf einem Server mit Hunderttausenden Verbindungen vervielfachen sich die Kosten, bis sie mit Anwendung, Speicher und Energie konkurrieren.
„Server-Ökonomie“ bedeutet nicht, dass es eine öffentliche Einsparungszahl gibt. Sie beschreibt Flottenfolgen: wie viele Verbindungen passen, wie viel CPU für den Dienst bleibt, wie viel Speicher Networking verbraucht und wie oft eine lokale Warteschlange ein Latenzziel bricht. Distributionen und Betreiber wählen Versionen, qdisc, Congestion Control und NIC. Dumazet kontrolliert diese Entscheidungen nicht; er verändert den gemeinsamen Ausgangspunkt.
Die vertraute TCP-Arbeit verbirgt ein sehr komplexes Buchhaltungssystem
TCP bietet einen zuverlässigen Strom, muss aber entscheiden, wie viele Bytes ausstehen dürfen, wann erneut gesendet wird, wie Speicher berechnet wird, wie Pakete geordnet werden und wie CPU und Warteschlangen unter Tausenden Sockets geteilt werden.
Eine Implementierung kann korrekt sein und dennoch schlecht arbeiten: zu viel lokaler Backlog, Bursts, geteilte Locks oder Strukturen, die Cache verschwenden. Der rote Faden in Dumazets Werk ist buchhalterisch. Bytes werden dem Socket angelastet, Abschlüsse geben Guthaben zurück, Sendezeitpunkte werden berechnet und heiße Felder von kalten getrennt. Das Ziel ist, nötige Ressourcen zu nutzen, ohne ein zweites verstecktes Netz im Host aufzubauen.
Vor TCP Small Queues konnte der Sender einen Backlog aufbauen, den er nicht mehr kontrollierte
Vor TSQ konnte TCP viel Verkehr an qdisc und Treiber übergeben. Das Congestion Window konnte angemessen sein, und trotzdem hielt eine lange lokale Warteschlange Pakete unterhalb der Transportschicht. Die Anwendung konnte sie nicht mehr zurückziehen, wenn ein dringender Fluss auftauchte.
Diese Anhäufung schwächte das Feedback: TCP sah Acknowledgements vom Pfad, aber ein Teil der Daten hatte den Host gar nicht verlassen. Sie verbrauchte auch Speicher, besonders wenn viele Flüsse das Muster wiederholten. Es galt, den Durchsatz zu halten, ohne dass jeder Socket die unteren Schichten als unbegrenztes Lager nutzte.
Die TSQ-Serie von 2012 gab dem Socket ein lokales Warteschlangenbudget zurück
Die Patches von 2012 begrenzten pro Socket die Menge der unter TCP eingereihten Daten. War das lokale Guthaben erschöpft, hielt der Socket an; nach Abschluss von Paketen erhielt er wieder Sendekapazität.
Die Idee war einfach: lokale Bytes zählen und den Abschluss als Fortschrittsbeweis nehmen. Die Kontrolle kehrte zur Transportschicht zurück, die den Fluss kannte. Es war nicht mehr nötig, im Voraus einen großen Stapel abzulegen, um die Verbindung ausgelastet zu halten. Die Bedeutung von TSQ liegt gerade darin, dass Anwendungen ohne Kenntnis des Mechanismus diszipliniertes Verhalten erhielten, ohne ihren Code zu ändern.
Der Paketabschluss wurde zu einem nützlichen Signal im Host
Der Completion könnte als einfache Bereinigung erscheinen. TSQ machte ihn zur Information: Ein Teil des unteren Pfads kam voran, und der Socket darf mehr senden.
Dieses lokale Feedback ergänzt die entfernten Acknowledgements. Die einen beschreiben Fortschritt durch das Netz; das andere Fortschritt unterhalb von TCP. Statistiken von qdisc, Treiber und NIC zählen andere Teile. Kein Signal genügt allein. TSQ nutzte eines davon, um lokalen Überschuss zu begrenzen, ohne die Ende-zu-Ende-Congestion-Control zu ersetzen.
TSQ verringerte eine Bufferbloat-Quelle, nicht alle Warteschlangen im Pfad
TSQ beseitigte Bufferbloat nicht. Es wirkt auf den Sender-Backlog unterhalb von TCP. Weiterhin existieren Warteschlangen in qdisc, Treiber, NIC, Zugang, Routern, Switches und Empfänger.
Die nützliche Aussage ist präziser: TSQ verringert die Fähigkeit eines Sockets, eine zu große versteckte Warteschlange aufzubauen. Es kann Latenz und Speicher senken und den TCP-Zustand dem Gerätefortschritt annähern. Es ersetzt weder Active Queue Management, sinnvolle Konfiguration noch Ende-zu-Ende-Congestion-Control.
Schwellen, Offloads und Lasten bestimmen, wie sehr TSQ hilft
Das Ergebnis hängt vom Limit, der Paketgröße, der qdisc, den Hardware-Warteschlangen, TSO und der Flussmischung ab. Ein interaktiver Dienst und eine Massenreplikation reagieren nicht gleich.
Die Implementierung änderte sich auch nach 2012. Andere Entwickler passten Limits an und korrigierten Wechselwirkungen. Die Urheberschaft des Konzepts kann Dumazet zugeschrieben werden, ohne den aktuellen Mechanismus als eingefrorenes, ausschließlich ihm gehörendes Stück darzustellen.
sch_fqtrennte Flüsse und brachte Zeit in den Scheduler
2013 veröffentlichte Dumazet den Schedulersch_fq. Er hält Zustand pro Fluss und eine zeitlich geordnete Struktur, um Pakete gemäß ihrem Zielzeitpunkt freizugeben. Neue Flüsse können früh bedient werden, während gepacte Flüsse auf ihren Termin warten.
Er löst zwei Probleme: Er verhindert, dass eine große Übertragung die lokale Warteschlange monopolisiert, und bietet einen Ort, an dem der Kernel Sendezeitpunkte respektieren kann. Er garantiert keine Gleichheit zwischen Anwendungen; er bietet eine diszipliniertere Politik und praktische Unterstützung für Pacing.
Fair Queueing ist eine Politik, kein Versprechen gleicher Ergebnisse
„Fair“ kann absoluter klingen, als es ist. Flüsse in einer Warteschlange zu trennen gleicht Anwendungsleistung nicht an. Paketgröße, Pfad, Empfänger, Congestion Control, Offloads und Verbindungszahl bleiben wichtig.
Selbst die Identität eines Flusses ist eine Entscheidung: Eine Anwendung kann viele Verbindungen öffnen, eine andere nur eine.sch_fqbegrenzt lokale Dominanz, löst aber keine Fairness zwischen Nutzern oder Unternehmen. Für den Betreiber ist es ein Werkzeug zur Schlichtung, keine universelle Garantie.
Pacing verwandelt eine Ratenschätzung in eine Folge von Sendezeitpunkten
Ein Algorithmus kann die richtige Rate bestimmen und sie dennoch als Burst loslassen. Der Durchschnitt bleibt, aber die Warteschlange erleidet eine Spitze.
Pacing verteilt Pakete über die Zeit. Es kann Warteschlangen stabilisieren, das Miteinander verbessern und das Congestion-Modell besser ausdrücken. Die Implementierung erfordert kohärente Timestamps, Timer, qdisc, Segmentierung und NIC. Die Software-Rate zählt nur, wenn sie zu realen Zeitpunkten auf der Leitung wird.
Pacing und Congestion Control lösen unterschiedliche Teile
Congestion Control entscheidet, wie viel vom Pfad genutzt wird; Pacing entscheidet, wann erlaubte Daten hinausgehen. Ein gutes Modell kann durch Bursts ruiniert werden, und perfektes Pacing kann eine falsche Rate ausführen.
Dumazets Infrastruktur erlaubt mehreren Algorithmen, eine Rate über die Zeit auszudrücken. Die Urheberschaft jedes Modells gehört seinen Entwicklern, auch wenn es auf diese Infrastruktur angewiesen ist.
BBR nutzt Pacing, hat aber eigene Urheberschaft und Entwicklung
BBR wird oft mit Dumazet verbunden, wegen der Abhängigkeit vom Pacing und dem Google-Umfeld. Das macht ihn nicht zum alleinigen Erfinder. BBR hat eigene Autoren, Modell und Versionen.
Dumazets Beitrag ist grundlegend: Warteschlangen, Pacing, Instrumentierung und Sockets machen spätere Algorithmen einsetzbar. Diese Beschreibung würdigt seine Bedeutung und bewahrt zugleich die Anerkennung für Neal Cardwell und andere Congestion-Autoren.
TSO spart CPU und kann den Burst wieder aufbauen, den Pacing vermeiden wollte
TCP Segmentation Offload erlaubt es, ein großes Segment an die NIC zu übergeben, damit sie es später teilt. Es senkt die Kosten pro Paket erheblich, schiebt aber Hardware zwischen die zeitliche Entscheidung und die Aussendung.
Geht das Segment als Einheit hinaus, kann die NIC einen Burst erzeugen. TSQ, qdisc, TSO, Treiber und Hardware müssen als System behandelt werden. Eine CPU-Ersparnis kann die Latenz verschlechtern, wenn sie nicht mit der Verkehrsform abgestimmt ist.
Quantum, Timestamps und NIC-Verhalten müssen dieselbe Realität beschreiben
Der Kernel arbeitet mit Quanta, Timer-Auflösung, Timestamps, Offload-Einheiten und physischen Warteschlangen. Ein großes Quantum erzeugt Bursts; ein kleines kostet CPU; eine NIC, die eine andere Granularität interpretiert, verändert den Ausgang.
Deshalb gehört qdisc zur Kapazitätsplanung. Entwickler müssen den gesamten Pfad messen, und Benchmarks, die nur Congestion Control oder Leitungstempo nennen, lassen einen großen Teil des Systems aus.
Das interne TCP-Pacing verringerte die Abhängigkeit von einer bestimmten qdisc
2017 veröffentlichte Dumazet internes Pacing in TCP. Die Transportschicht konnte Verkehr stärker nach ihrer Rate und ihren Timern zurückhalten, ohne vollständig auf eine bestimmte Disziplin angewiesen zu sein.
Die qdisc blieb für Ordnung und Politik relevant. Die Logik rückte näher an das Subsystem, dem die Absicht gehört, aber der endgültige Ausgang blieb auf TCP, Scheduler, Treiber und NIC verteilt. Es ist Evolution in Schichten, kein sauberer Ersatz.
Die Warteschlangendisziplin bleibt eine operative Entscheidung mit realen Folgen
Linux bietet qdiscs für unterschiedliche Ziele.sch_fqbegünstigt Pacing; FQ-CoDel kombiniert Flusstrennung mit Active Queue Management. Das ist nicht dasselbe.
Die Standardwerte variieren je nach Distribution und Umgebung. Cloud-Images, Appliances und Container-Hosts können unterschiedlich wählen, und Hardware kann die Ausführung verschieben. Upstream liefert Mechanismen; der Betreiber entscheidet, ob sie zu realem Dienstverhalten werden.
Ein paar Bytes pro Socket werden zur Flottenbeschränkung
Jede Verbindung hält Sequenzen, Timer, Congestion-Zustand, Warteschlangen und Zähler. Im großen Maßstab vervielfacht sich jedes Byte, und jedes häufige Feld belegt Cache.
Weniger Speicher pro Socket kann die Dichte erhöhen; ein besseres Layout kann Misses und Kohärenz zwischen CPUs senken. Das ist die stärkste Brücke zur Server-Ökonomie, erlaubt aber weder eine universelle Einsparungsrechnung noch eine persönliche Bewertung der Arbeit.
Eine Cache-Zeile wird zur Infrastruktur, wenn sie bei jedem Paket berührt wird
Der Prozessor bewegt ganze Zeilen, keine einzelnen Felder. Heiße Daten neben kalten Feldern lassen unnütze Bytes zirkulieren; zwei CPUs, die dieselbe Zeile ändern, erzeugen Kohärenzverkehr, auch wenn sie unterschiedliche Werte berühren.
Dumazets jüngste Arbeit nimmt diese physische Sicht an. Heiße und kalte Felder zu trennen reduziert Speicherverkehr, der mit Paketen und Sockets wächst. Der Nutzen hängt von Prozessor und Last ab, daher kann ein Flottenprofil nicht einfach zum universellen Gesetz werden.
Die Strukturarbeit von 2024 zeigt eine reife Phase des Performance Engineering
Die Präsentation von 2024 begann mit Profilen: welche Felder heiß sind, welche Zeilen sich bewegen und welche Strukturen den Speicher dominieren. Werkzeuge können Umstellungen vorschlagen, ersetzen aber nicht die Prüfung von Ausrichtung, Locking, Kompatibilität und Wartbarkeit.
In reifer Infrastruktur können große Gewinne daraus entstehen, einen Miss zu vermeiden oder ein Feld zu verschieben, statt einen neuen Algorithmus einzuführen. Das ist weniger sichtbar als eine Congestion-Marke, bestimmt aber die reale Leistung.
Hyperscale-Profile sind starke Evidenz und unvollständige öffentliche Wissenschaft
Große Betreiber sehen Populationen und Hardware, die schwer zu reproduzieren sind. Sie können Kosten entdecken, die im Labor nicht auftauchen. Dumazets Zugehörigkeit zu Google stellt ihn in dieses Umfeld.
Ein Teil der Lasten und Daten bleibt privat. Ein Vortrag kann Methode und Ergebnis zeigen, ohne alle Eingaben zu liefern. Die Lösung ist nicht, die Evidenz zu verwerfen, sondern ihren Geltungsbereich zu begrenzen und mehr reale Fälle in öffentliche Tests und CI zu überführen.
Locks und Empfangswarteschlangen gehören zur selben Ressourcengeschichte
Obwohl der Schwerpunkt des Profils auf dem Senden liegt, umfasst Dumazets Laufbahn auch Sockets und Empfang. Eingehende Pakete brauchen Polling, Speicher, Klassifizierung, Warteschlangen und Auslieferung zwischen CPUs. Bei hoher Rate werden Locks und geteilter Zustand zu Kosten.
Linux senkt diese Kosten, indem es Arbeit verschiebt, Operationen bündelt und Konflikte verringert. Das Prinzip ist dasselbe: nötige Koordination für Korrektheit nutzen, ohne dass die Buchhaltung den Dienst verzehrt.
Batching erhöht den Durchsatz und verändert Latenz und faire Aufteilung
Pakete oder Abschlüsse zu bündeln amortisiert Locks, Aufrufe und Cache. NAPI, Treiber und Offloads hängen davon ab.
Der Batch wartet jedoch und kann als Burst ankommen. Große Batches verbessern die Amortisation und erhöhen Wartezeit oder Dominanz. TSQ, Fair Queueing und Pacing lehnen Batching nicht ab; sie begrenzen es, um Feedback und Latenz zu erhalten.
Die TCP-Leistung entsteht aus Schichten, die einander aufheben können
Der Algorithmus definiert die Absicht; TCP erzeugt Pakete; TSQ begrenzt den Backlog; qdisc ordnet; TSO bündelt; der Treiber mappt; die NIC sendet; das Netz fügt Warteschlangen und Verluste hinzu.
Präzises Pacing kann durch grobe Segmentierung aufgehoben werden; eine Latenz-qdisc durch übermäßiges Enqueue; ein kompaktes Layout durch einen neuen Lock. Dumazets Bedeutung liegt darin, an diesen Nähten zu arbeiten und den installierten Pfad zu verbessern, statt sich von ihm zu trennen.
Öffentliche Review macht eine lokale Optimierung zu geteilter Infrastruktur
Eine Verbesserung beginnt als Behauptung: weniger Latenz, Speicher oder CPU. Um in Linux aufgenommen zu werden, muss sie netdev überstehen: Methodik, generische Schnittstelle, seltene Architekturen, Tests und künftige Kosten.
Ein Maintainer kann die Serie teilen, eine Anbieter-Abstraktion ablehnen oder eine Änderung verschieben. Das ist langsamer als ein privater Patch und haltbarer. Dumazets Autorität umfasst die Beurteilung, ob etwas nicht nur heute funktioniert, sondern ob Linux es jahrelang tragen kann.
netundnet-nexttrennen dringende Reparatur und künftige Entwicklung
Fixes gehen normalerweise nachnet; Funktionen nachnet-next. Die Trennung verhindert, dringende Wartung mit Refactorings einer künftigen Version zu vermischen.
Die Einordnung erfordert Urteil. Ein Fix kann Verhalten ändern, und eine Funktion kann einen alten Fehler offenbaren. Maintainer teilen Serien, damit das Risiko explizit wird und ein Geschäftstermin nicht die technische Vorbereitung ersetzt.
Review, Ablehnung und Neuentwurf erscheinen nicht im Commit-Zähler
Commits messen sichtbare Urheberschaft, nicht den Satz, der einen Schnittstellen-Neuentwurf erzwingt, noch die Ablehnung, die eine jahrelange Last verhindert. Einen Patch anzuwenden bedeutet, Integration zu übernehmen, nicht seine Idee zu erfinden.
Das Profil kombiniert zugeschriebene Mechanismen mit Stewardship. TSQ,sch_fq, Pacing und Layouts sind klar, erschöpfen aber nicht Jahrzehnte der Review und machen nicht alle integrierten Änderungen zu persönlichen Werken.
Tests reduzieren Risiken, ohne alle Maschinen abzubilden, die Linux sehen wird
Builds, Selftests, KUnit, syzbot, Treiberlabore und Downstream-Deployments finden Fehler, decken aber nicht alle CPUs, NICs, qdiscs und Lasten ab.
Eine für Hyperscale nützliche Änderung kann ein seltenes Gerät beschädigen. Maintainer brauchen weiterhin Erfahrung, Kompatibilität und Rollback. Tests stärken die Governance; sie beseitigen das Urteil nicht.
Stabile Backports erfordern nach Mainline eine weitere Entscheidung
Ein Mainline-Patch gelangt nicht automatisch in alle Zweige. Stable verlangt einen echten, begrenzten Fix mit geringem Risiko. Distributionen treffen eine weitere Entscheidung.
Performance-Änderungen können von umgebendem Code abhängen, der in einem alten Zweig fehlt. Die Wirkung kommt stufenweise: Upstream, Stable, Distribution, Cloud und Konfiguration. Niemand kontrolliert die gesamte Kette.
Die aktuelle Verantwortung für TCP und Sockets ist bewusst geteilt
MAINTAINERSverteilt die Last zwischen Dumazet, Neal Cardwell und anderen Maintainern und Reviewern. Das reduziert die Abhängigkeit von einer Person und kombiniert Kenntnisse zu Congestion, Sockets, Treibern und Tests.
Die Vielfalt verlangt klare Ownership. Überlappungen können Lücken hinterlassen, wenn alle auf andere warten. Eine gesunde Nachfolge teilt Autorität und bewahrt die Gründe hinter Entscheidungen, nicht nur die Namen in einer Datei.
Die Netdev Foundation kann finanzieren, ohne Merge-Autorität zu werden
Die Stiftung unter der Linux Foundation unterstützt CI, Werkzeuge, Reisen und Forschung. Dumazet gehört ihrem TSC an. Eine Förderung garantiert nicht, dass ein Patch angenommen wird.
Die Unterscheidung ist gesund: Networking zu pflegen kostet Geld und Zeit, aber die Upstream-Legitimität kommt weiterhin aus öffentlicher Evidenz. Finanzierung sollte die Entscheidungsfähigkeit erhöhen, nicht Ausnahmen kaufen.
Die Zugehörigkeit zu Google bringt Kapazität ohne Eigentum an Linux-TCP
Die Google-E-Mail belegt Zugehörigkeit, keinen vollständigen Titel. Ein Hyperscaler kann Profile, Hardware und Review finanzieren, die später ganz Linux zugutekommen.
Die Asymmetrie ist, dass seine Lasten und Daten nicht vollständig öffentlich sind. Die offene Review gleicht aus: Der Patch muss generisch und außerhalb von Google akzeptabel sein. Das Unternehmen liefert Zeit und Evidenz; es besitzt den Stack nicht.
Downstream-Betreiber entscheiden, ob die Verbesserung ihren Dienst verändert
Distributionen wählen Kernel; Clouds, qdisc und Congestion; Appliances, Versionen; NIC-Anbieter, Fähigkeiten; Anwendungen, Verkehr. Es gibt keine vollständige Nutzungszählung von TSQ odersch_fq.
Ein Mechanismus kann kompiliert und inaktiv sein oder standardmäßig aktiv ohne Sichtbarkeit für den Nutzer. Dumazets Wirkung ist breit, aber indirekt: Er verändert die gemeinsamen Optionen; jeder Betreiber macht daraus Erfahrung.
Userspace-Stacks konkurrieren um spezialisierte Lasten, nicht um alle Linux-Funktionen
DPDK, VPP und eigene Stacks können Teile des Kernels umgehen, um hohe Raten zu erreichen, gegen dedizierte Cores, Huge Pages und ein anderes Betriebsmodell.
Linux integriert Sockets, Sicherheit, Namespaces, Observability und Treiber. Dumazets Arbeit senkt die Kosten des allgemeinen Pfads, ohne zu behaupten, er sei für alles perfekt. Der Bypass bleibt für spezifische Zwecke; Linux bleibt die Basis der meisten.
Linux bleibt der Standard, weil Integration mehr wert ist als rohe Geschwindigkeit
Ein Stack muss schnell, kompatibel, sicher, beobachtbar und wartbar sein. Ein isolierter Pfad kann mehr Pakete pro Sekunde liefern und Betriebs- und Supportkosten erzeugen.
Eine Linux-Anwendung erbt TSQ, Pacing und Buchhaltung über normale Sockets. Diese Unsichtbarkeit ist Teil der Stärke: Der Nutzen bleibt, auch wenn der Nutzer den Namen des Autors nicht kennt.
Ein schnellerer Host beweist nicht, dass der Netzpfad besser ist
Die lokale Warteschlange zu verbessern behebt keinen überlasteten Zugang, keinen langsamen Empfänger und keine Router, die Pakete verwerfen. TSQ und Pacing steuern den Sender, nicht den gesamten Pfad.
Sie können eine Verzögerungsquelle verringern und den Fluss gleichmäßiger machen. Sie garantieren kein Anwendungsergebnis. Die Ende-zu-Ende-Leistung hängt weiter von Anwendung, Empfänger, Pfad und Konfiguration ab.
Ein Benchmark repräsentiert nicht jeden Server, jede NIC und jede Last
Paketgröße, Verbindungen, CPU, Cache, NIC, Offloads, qdisc, Timer, Kernel und Last verändern das Ergebnis. Ein Google-Profil kann echte Kosten entdecken, ohne den Prozentsatz in einer anderen Flotte vorherzusagen.
Gute Information bewahrt Bedingungen. Dumazets Vorträge sind zugeschriebene operative Evidenz; öffentliche Tests und unabhängige Messungen sind nötig, um zu verallgemeinern.
Nachfolge ist ein technisches Problem, weil ein Großteil des Designs im Gedächtnis lebt
Seltsame Limits können wegen einer alten NIC, einer noch genutzten API oder einer vergessenen Regression bestehen. Der Code erklärt nicht immer, warum.
Erfahrene Maintainer tragen diesen Kontext. Dokumentation, Tests, Archive und neue Reviewer machen privates Gedächtnis zu institutionellem Wissen. Nachfolge muss Prinzipien bewahren und erlauben, sie für künftige Hardware zu überprüfen.
Hardware-Pacing und Gerätespeicher können die Grenze erneut verschieben
Moderne NICs programmieren Pakete, verwalten mehr Warteschlangen und legen Telemetrie oder lokalen Speicher offen. Sie senken CPU und verlagern Verhalten in Firmware.
Linux muss Absicht ausdrücken, beobachten, was geschah, und sich erholen, wenn Hardware und Software abweichen. Treiber-APIs, Timestamps und Fehler werden so wichtig wie die Rate. Die Prinzipien bleiben: Feedback, Grenzen für versteckte Warteschlangen und Observability.
Cache-Ökonomie kann mehr Gewinne bieten als neue Transportformeln
Congestion-Algorithmen werden weiter erscheinen, aber die nächste materielle Verbesserung kann ein verbessertes Layout, ein Lock oder ein Batch sein. Es hat keine attraktive Marke und nützt mehreren Algorithmen.
Die Arbeit von 2024 zeigt einen reifen Stack, der nach physischen Kosten bewertet wird. Die Frage wechselt von „welches Protokoll gewinnt“ zu „wie viel Maschine verbraucht jede Verbindung“.
Dumazets dauerhafter Beitrag ist Ressourcendisziplin, keine Heldenlegende
Eine übertriebene Version machte ihn zum Erfinder des modernen TCP und von BBR; eine andere löschte das Individuum in der Gemeinschaft aus. Die Evidenz erlaubt eine präzise Position.
Er führte TSQ ein, zeichnete Grundlagenarbeit ansch_fq, trieb internes Pacing voran und zeigte die Bedeutung des Layouts. Er pflegt außerdem kritische Bereiche innerhalb eines geteilten Systems. Sein Beitrag ist, Pakete und Sockets als Anforderungen an Zeit, Speicher, Warteschlange und CPU-Lokalität zu behandeln.
Die endgültige Wirkung verteilt sich auf Design, Review, Integration und Betrieb. Ein Commit wird zugeschrieben; eine dichtere Flotte oder ein verhinderter Ausfall nicht. Diese Schwierigkeit rechtfertigt weder Übertreibung noch Auslöschung: Sie zeigt, dass der Wert von Infrastruktur aus einer kollektiven Kette mit identifizierbaren individuellen Entscheidungen entsteht.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten