
Resumo
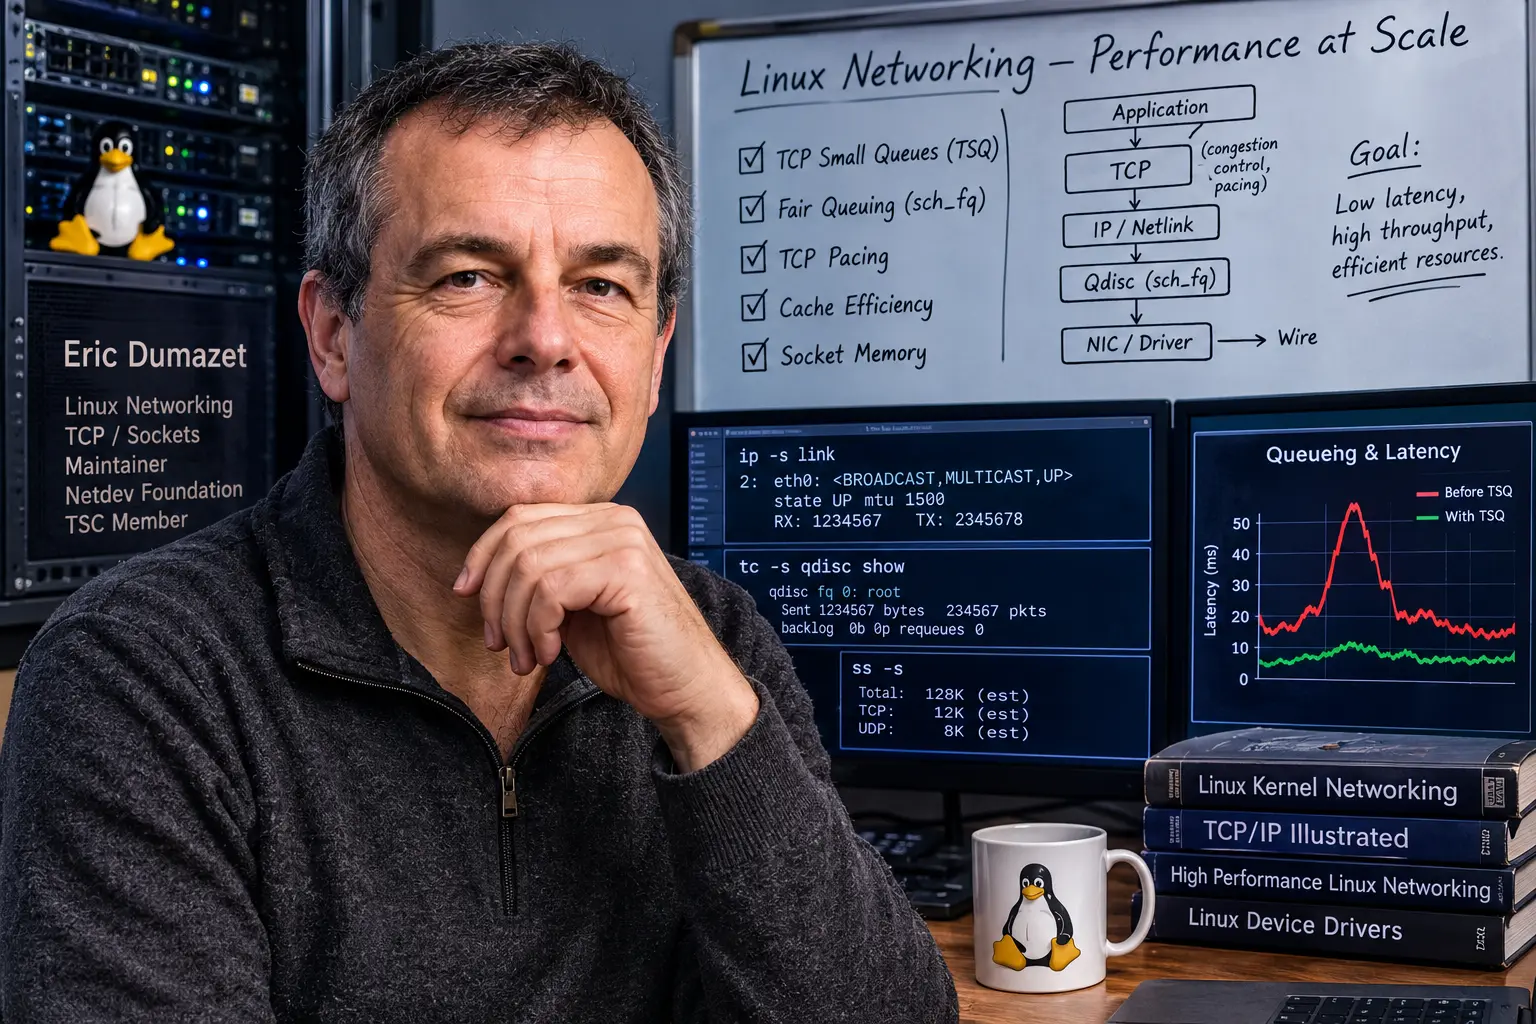
- Eric Dumazet figura atualmente como mantenedor do Linux para rede em geral, TCP e sockets, e faz parte do comitê técnico da Netdev Foundation. Essas funções são compartilhadas com outros mantenedores e revisores: implicam grande responsabilidade de integração, não controle individual sobre a pilha de rede.
- Sua contribuição nominal mais clara é o TCP Small Queues, introduzido em 2012 para impedir que um único fluxo TCP depositasse uma quantidade excessiva de dados em filas situadas abaixo do transporte. Ao vincular o crédito local do socket à conclusão de pacotes, o TSQ reduziu latência e pressão de memória no emissor sem eliminar todas as filas do percurso.
- Seus trabalhos posteriores sobre
sch_fqe pacing interno transformaram o momento de envio em um controle explícito. Fair queueing separa fluxos e pacing distribui os pacotes no tempo. Essas peças servem a vários algoritmos de congestionamento, incluindo ambientes com BBR, mas o BBR tem autoria e história próprias. - Sua atuação mais recente conecta o design de estruturas, o tráfego de linhas de cache e o estado por socket com a eficiência de grandes frotas. A conclusão é que networking no Linux também é contabilidade de CPU, memória, profundidade de fila e tempo. O efeito econômico pode ser material, embora a evidência pública não permita atribuir-lhe um valor monetário nem prometer o mesmo resultado em todos os sistemas.
Um servidor rápido ainda pode perder tempo atrás dos próprios pacotes
A história começa dentro de uma fila de transmissão. A aplicação gravou dados, o TCP considera que pode enviar mais e o kernel os entregou às camadas inferiores. De cima, parecem enviados, mas podem continuar esperando na mesma máquina.
O enlace permanece ocupado e o problema fica oculto. Uma solicitação interativa espera atrás de uma transferência massiva, os buffers retêm memória e a noção de “dados em voo” deixa de coincidir com o que simplesmente está acumulado localmente. O TCP Small Queues mudou essa relação ao limitar quanto um socket podia colocar abaixo do TCP e ao devolver-lhe permissão de envio quando o hardware concluía trabalho real.
O registro público explica a engenharia e evita inventar uma biografia
A melhor evidência vem do próprio kernel:MAINTAINERS, discussões de patches, documentação, conferências e revisão pública. Esses registros sustentam seu trabalho contínuo em networking, TCP e sockets, seu assento na Netdev Foundation e uma afiliação visível ao Google por meio do e-mail de mantenedor.
Não oferecem uma biografia completa, um título corporativo atual verificado, um censo total de patches ou a repartição exata do seu tempo. Preencher essas lacunas com detalhes plausíveis seria pouco rigoroso. O perfil se concentra, por isso, em mecanismos e decisões observáveis. Dumazet aparece como um engenheiro de responsabilidade técnica cujo trabalho só se converte em infraestrutura depois que outros o revisam, modificam, testam e implantam.
Ser mantenedor o coloca perto das decisões, não acima da comunidade
Em 4 de agosto de 2026, os registros do Linux o incluíam em networking geral, TCP e sockets. Um mantenedor pode pedir o redesenho de uma interface, rejeitar uma carga de manutenção injustificada, aplicar mudanças aceitas e representar o subsistema perante a mainline.
A mesma fonte mostra autoridade compartilhada. David S. Miller, Jakub Kicinski e Paolo Abeni aparecem em networking geral; Neal Cardwell compartilha TCP, e outros revisores intervêm conforme o tema. Os patches passam ainda por arquitetura, drivers, segurança, testes, ramos estáveis e o processo final do kernel. A influência de Dumazet é notável porque funciona dentro dessa rede de controles.
O Linux se tornou infraestrutura econômica quando as conexões cresceram
Em uma máquina pequena, alguns bytes adicionais por socket ou uma falha de cache quase não são notados. Em um servidor com centenas de milhares de conexões, o custo se multiplica até competir com a aplicação, a memória e a energia.
“Economia de servidores” não significa que exista um valor público de economia. Descreve consequências de frota: quantas conexões cabem, quanto de CPU resta para o serviço, quanta memória o networking consome e quantas vezes uma fila local quebra uma meta de latência. Distribuições e operadores escolhem versões, qdisc, controle de congestionamento e NIC. Dumazet não controla essas decisões; ele muda o ponto de partida comum.
O trabalho familiar do TCP oculta um sistema de contabilidade muito complexo
O TCP oferece um fluxo confiável, mas precisa decidir quantos bytes podem ficar pendentes, quando retransmitir, como cobrar memória, como ordenar pacotes e como compartilhar CPU e filas entre milhares de sockets.
Uma implementação pode estar correta e ter mau desempenho: backlog local demais, rajadas, locks compartilhados ou estruturas que desperdiçam cache. O fio condutor da obra de Dumazet é contábil. Os bytes são cobrados ao socket, as conclusões devolvem crédito, os tempos de envio são calculados e os campos quentes são separados dos frios. O objetivo é usar os recursos necessários sem construir uma segunda rede oculta dentro do host.
Antes do TCP Small Queues, o emissor podia construir um backlog que já não controlava
Antes do TSQ, o TCP podia entregar muito tráfego ao qdisc e ao driver. A janela de congestionamento podia ser razoável e, ainda assim, uma longa fila local manter pacotes abaixo do transporte. A aplicação já não conseguia retirá-los quando aparecia um fluxo urgente.
Essa acumulação enfraquecia o feedback: o TCP via acknowledgements do caminho, mas parte dos dados nem sequer havia saído do host. Também consumia memória, especialmente quando muitos fluxos repetiam o padrão. Era necessário manter o desempenho sem permitir que cada socket usasse as camadas inferiores como armazenamento ilimitado.
A série TSQ de 2012 devolveu ao socket um orçamento de fila local
Os patches de 2012 limitaram por socket a quantidade de dados enfileirados abaixo do TCP. Quando o crédito local se esgotava, o socket parava; ao concluir pacotes, recuperava capacidade para enviar.
A ideia era simples: contar bytes locais e tomar a conclusão como prova de progresso. O controle voltou ao transporte que conhecia o fluxo. Já não era necessário depositar um grande lote antecipadamente para manter o enlace ocupado. A importância do TSQ reside justamente em que aplicações alheias ao mecanismo receberam um comportamento mais disciplinado sem modificar o próprio código.
A conclusão de pacotes se tornou um sinal útil dentro do host
A conclusão poderia parecer simples limpeza. O TSQ a converteu em informação: uma parte do caminho inferior avançou e o socket pode emitir mais.
Esse feedback local complementa os acknowledgements remotos. Uns descrevem progresso através da rede; o outro, progresso abaixo do TCP. Estatísticas do qdisc, do driver e da NIC contam outras partes. Nenhum sinal basta sozinho. O TSQ usou uma delas para controlar o excesso local sem substituir o controle de congestionamento ponta a ponta.
O TSQ reduziu uma fonte de bufferbloat, não todas as filas do caminho
O TSQ não eliminou o bufferbloat. Atua sobre o backlog do emissor abaixo do TCP. Continuam existindo filas no qdisc, no driver, na NIC, no acesso, em roteadores, switches e no receptor.
A afirmação útil é mais precisa: o TSQ reduz a capacidade de um socket criar uma fila oculta grande demais. Pode diminuir latência e memória e aproximar o estado do TCP do progresso do dispositivo. Não substitui active queue management, configuração sensata nem congestionamento ponta a ponta.
Limiares, offloads e cargas determinam o quanto o TSQ ajuda
O resultado depende do limite, tamanho do pacote, qdisc, filas de hardware, TSO e mistura de fluxos. Um serviço interativo e uma replicação massiva não respondem da mesma forma.
A implementação também mudou depois de 2012. Outros desenvolvedores ajustaram limites e corrigiram interações. A autoria do conceito pode ser atribuída a Dumazet sem apresentar o mecanismo atual como uma peça congelada e exclusivamente sua.
sch_fqseparou fluxos e incorporou o tempo ao scheduler
Em 2013, Dumazet publicou o schedulersch_fq. Ele mantém estado por fluxo e uma estrutura ordenada no tempo para liberar pacotes conforme sua data-alvo. Fluxos novos podem receber serviço em breve, enquanto os fluxos com pacing esperam sua vez.
Resolve dois problemas: evita que uma transferência grande monopolize a fila local e oferece um lugar onde o kernel pode respeitar tempos de envio. Não garante igualdade entre aplicações; oferece uma política mais disciplinada e um suporte prático para pacing.
Fair queueing é uma política, não uma promessa de resultados iguais
“Fair” pode soar mais absoluto do que é. Separar fluxos em uma fila não iguala o desempenho das aplicações. Tamanho de pacotes, rota, receptor, controle de congestionamento, offloads e número de conexões continuam importando.
Até a identidade de um fluxo é uma decisão: uma aplicação pode abrir muitas conexões e outra, uma. Osch_fqlimita a dominação local, mas não resolve a justiça entre usuários ou empresas. Para o operador, é uma ferramenta de arbitragem, não uma garantia universal.
Pacing converte uma estimativa de taxa em uma sequência de instantes de envio
Um algoritmo pode decidir a taxa correta e ainda assim soltá-la em uma rajada. A média se mantém, mas a fila sofre um pico.
O pacing distribui os pacotes no tempo. Pode estabilizar filas, melhorar a convivência e expressar melhor o modelo de congestionamento. A implementação exige timestamps, timers, qdisc, segmentação e NIC coerentes. A taxa de software só importa se for convertida em tempos reais sobre o enlace.
Pacing e controle de congestionamento resolvem partes distintas
O controle de congestionamento decide quanto usar do caminho; o pacing decide quando saem os dados permitidos. Um bom modelo pode ser arruinado por rajadas, e um pacing perfeito pode executar uma taxa errada.
A infraestrutura de Dumazet permite que vários algoritmos expressem uma taxa no tempo. A autoria de cada modelo cabe aos seus projetistas, ainda que dependa dessa infraestrutura.
O BBR usa pacing, mas tem autoria e evolução próprias
O BBR costuma ser associado a Dumazet por sua dependência do pacing e pelo ambiente Google. Isso não o torna inventor único. O BBR possui autores, modelo e versões próprias.
A contribuição de Dumazet é de base: filas, pacing, instrumentação e sockets tornam implementáveis algoritmos posteriores. Essa descrição reconhece sua importância e preserva o crédito de Neal Cardwell e outros autores de congestionamento.
O TSO economiza CPU e pode reconstruir a rajada que o pacing tentou evitar
TCP Segmentation Offload permite entregar um segmento grande à NIC para que ela o divida depois. Reduz muito o custo por pacote, mas interpõe o hardware entre a decisão temporal e a emissão.
Se o segmento sai como uma unidade, a NIC pode produzir uma rajada. TSQ, qdisc, TSO, driver e hardware devem ser tratados como um sistema. Uma economia de CPU pode piorar a latência se não for coordenada com a forma do tráfego.
Quantum, timestamps e comportamento da NIC devem descrever a mesma realidade
O kernel trabalha com quanta, resolução de timer, timestamps, unidades de offload e filas físicas. Um quantum grande cria rajadas; um pequeno gasta CPU; uma NIC que interpreta outra granularidade altera a saída.
Por isso, o qdisc faz parte do planejamento de capacidade. Os desenvolvedores precisam medir o percurso completo, e benchmarks que citam apenas o controle de congestionamento ou a velocidade do enlace omitem grande parte do sistema.
O pacing interno do TCP reduziu a dependência de um qdisc específico
Em 2017, Dumazet publicou pacing interno no TCP. O transporte ganhou mais capacidade para reter tráfego conforme sua taxa e timers, sem depender por completo de uma disciplina específica.
O qdisc continuou relevante para ordem e política. A lógica se aproximou do subsistema dono da intenção, mas a saída final continuou repartida entre TCP, scheduler, driver e NIC. É evolução por camadas, não substituição limpa.
A disciplina de fila continua sendo uma decisão operacional com consequências reais
O Linux oferece qdiscs para objetivos diferentes. Osch_fqfavorece pacing; FQ-CoDel combina separação de fluxos com active queue management. Não são a mesma coisa.
Os padrões variam por distribuição e ambiente. Imagens de nuvem, appliances e hosts de contêineres podem escolher configurações diferentes, e o hardware pode mover a execução. O upstream oferece mecanismos; o operador decide se eles se tornam comportamento real do serviço.
Alguns bytes por socket se tornam uma limitação de frota
Cada conexão mantém sequências, timers, estado de congestionamento, filas e contadores. Em grande escala, cada byte se multiplica e cada campo frequente ocupa cache.
Reduzir memória por socket pode aumentar densidade; melhorar o layout pode diminuir misses e coerência entre CPUs. Essa é a ponte mais sólida para a economia de servidores, mas não permite calcular uma economia universal nem uma valoração pessoal do trabalho.
Uma linha de cache se torna infraestrutura quando é tocada em cada pacote
O processador move linhas completas, não campos individuais. Dados quentes junto a campos frios fazem circular bytes inúteis; duas CPUs modificando a mesma linha geram tráfego de coerência mesmo que toquem valores diferentes.
A obra recente de Dumazet adota essa visão física. Separar campos quentes e frios reduz o tráfego de memória que cresce com pacotes e sockets. O benefício depende de processador e carga, de modo que o perfil de uma frota não pode virar lei universal sem mais.
O trabalho de 2024 sobre estruturas mostra uma fase madura de engenharia de performance
A apresentação de 2024 começou com perfis: quais campos estão quentes, quais linhas se movem e quais estruturas dominam a memória. Ferramentas podem sugerir reorganizações, mas não substituem a revisão sobre alinhamento, locking, compatibilidade e manutenção.
Em infraestrutura madura, grandes ganhos podem vir de evitar um miss ou mover um campo, não de um novo algoritmo. É menos visível do que uma marca de congestionamento, mas determina o desempenho real.
Perfis hyperscale são evidência potente e ciência pública incompleta
Grandes operadores veem populações e hardware difíceis de reproduzir. Podem descobrir custos que não aparecem em laboratório. A afiliação de Dumazet ao Google o coloca nesse ambiente.
Parte das cargas e dados permanece privada. Uma palestra pode mostrar método e resultado sem entregar todos os insumos. A solução não é descartar a evidência, mas limitar seu alcance e converter mais casos reais em provas públicas e CI.
Locks e filas de recepção pertencem à mesma história de recursos
Embora o eixo do perfil esteja na transmissão, a trajetória de Dumazet inclui sockets e recepção. Pacotes de entrada precisam de polling, memória, classificação, filas e entrega entre CPUs. Em alta taxa, locks e estado compartilhado viram custo.
O Linux reduz esse custo movendo trabalho, agrupando operações e reduzindo contenção. O princípio é o mesmo: usar a coordenação necessária para a correção sem permitir que a contabilidade consuma o serviço.
Batching eleva throughput e muda latência e compartilhamento justo
Agrupar pacotes ou conclusões amortiza locks, chamadas e cache. NAPI, drivers e offloads dependem disso.
O lote, porém, espera e pode chegar como rajada. Lotes grandes melhoram a amortização e aumentam a espera ou a dominação. TSQ, fair queueing e pacing não rejeitam batching; o delimitam para conservar feedback e latência.
O desempenho do TCP emerge de camadas que podem se anular mutuamente
O algoritmo define a intenção; o TCP cria pacotes; o TSQ limita o backlog; o qdisc ordena; o TSO agrupa; o driver mapeia; a NIC emite; a rede adiciona filas e perdas.
Um pacing preciso pode ser anulado por uma segmentação grossa; um qdisc de baixa latência, por excesso de enqueue; um layout compacto, por um novo lock. A importância de Dumazet está em trabalhar nessas costuras e melhorar o caminho instalado em vez de se separar dele.
A revisão pública converte uma otimização local em infraestrutura compartilhada
Uma melhoria começa como uma afirmação: menos latência, memória ou CPU. Para entrar no Linux, precisa sobreviver ao netdev: metodologia, interface genérica, arquiteturas raras, testes e custo futuro.
Um mantenedor pode dividir a série, rejeitar uma abstração de fornecedor ou adiar uma mudança. É mais lento do que um patch privado e mais durável. A autoridade de Dumazet inclui julgar não apenas se algo funciona hoje, mas se o Linux poderá sustentá-lo por anos.
netenet-nextseparam reparo urgente e desenvolvimento futuro
Os fixes vão normalmente paranet; as funcionalidades, paranet-next. A separação evita misturar manutenção urgente com refatorações de uma versão futura.
A classificação exige julgamento. Um fix pode mudar comportamento e uma funcionalidade revelar um defeito antigo. Os mantenedores dividem séries para que o risco fique explícito e para impedir que uma data comercial substitua a prontidão técnica.
Revisão, rejeição e redesenho não aparecem no contador de commits
Commits medem autoria visível, mas não a frase que obriga a redesenhar uma interface nem a rejeição que evita uma carga de anos. Aplicar um patch significa assumir a integração, não inventar a ideia.
O perfil combina mecanismos atribuídos com stewardship. TSQ,sch_fq, pacing e layouts são claros, mas não esgotam décadas de revisão nem transformam em obras pessoais todas as mudanças integradas.
Testes reduzem risco sem representar todas as máquinas que o Linux verá
Builds, selftests, KUnit, syzbot, laboratórios de drivers e implantações downstream encontram falhas, mas não cobrem todas as CPUs, NICs, qdisc e cargas.
Uma mudança útil para hyperscale pode prejudicar um dispositivo raro. Os mantenedores continuam precisando de experiência, compatibilidade e rollback. Testes fortalecem a governança; não eliminam o julgamento.
Backports estáveis exigem outra decisão depois da mainline
Um patch da mainline não entra automaticamente em todos os ramos. A stable exige um fix real, delimitado e de baixo risco. As distribuições tomam ainda outra decisão.
Mudanças de performance podem depender de código circundante ausente em um ramo antigo. O impacto chega por etapas: upstream, stable, distribuição, nuvem e configuração. Ninguém controla a cadeia completa.
A responsabilidade atual sobre TCP e sockets está distribuída de forma deliberada
OMAINTAINERSdistribui a carga entre Dumazet, Neal Cardwell e outros mantenedores e revisores. Isso reduz a dependência de uma pessoa e combina conhecimentos de congestionamento, sockets, drivers e testes.
A pluralidade exige ownership claro. Sobreposições podem deixar lacunas se todos esperarem pelo outro. Uma sucessão saudável reparte autoridade e preserva as razões por trás das decisões, não apenas os nomes em um arquivo.
A Netdev Foundation pode financiar sem se tornar autoridade de merge
A fundação, sob a Linux Foundation, apoia CI, ferramentas, viagens e pesquisa. Dumazet faz parte do seu TSC. Uma subvenção não garante que um patch seja aceito.
A distinção é saudável: manter networking custa dinheiro e tempo, mas a legitimidade upstream continua vindo de evidência pública. O financiamento deve aumentar a capacidade de decidir, não comprar exceções.
A afiliação ao Google traz capacidade sem propriedade sobre o TCP do Linux
O e-mail do Google prova afiliação, não um título completo. Um hyperscaler pode financiar perfis, hardware e revisão que depois beneficiam todo o Linux.
A assimetria é que suas cargas e dados não são plenamente públicos. A revisão aberta compensa: o patch precisa ser genérico e aceitável fora do Google. A empresa contribui com tempo e evidência; não possui a pilha.
Operadores downstream decidem se a melhoria muda o serviço deles
Distribuições escolhem kernels; nuvens, qdisc e congestionamento; appliances, versões; fabricantes de NIC, capacidades; aplicações, tráfego. Não existe censo completo do uso de TSQ ousch_fq.
Um mecanismo pode estar compilado e não ativo, ou ativo por padrão sem visibilidade do usuário. O impacto de Dumazet é amplo, mas indireto: muda as opções comuns; cada operador as converte em experiência.
Pilhas userspace competem por cargas especializadas, não por todas as funções do Linux
DPDK, VPP e stacks próprias podem evitar partes do kernel para alcançar taxas altas, em troca de cores dedicados, huge pages e outro modelo operacional.
O Linux integra sockets, segurança, namespaces, observabilidade e drivers. O trabalho de Dumazet reduz o custo do caminho geral sem afirmar que ele é perfeito para tudo. O bypass fica para usos específicos; o Linux continua sendo a base da maioria.
O Linux continua sendo o padrão porque a integração vale mais do que a velocidade bruta
Uma pilha precisa ser rápida, compatível, segura, observável e sustentável. Um caminho isolado pode dar mais pacotes por segundo e criar custos de operação e suporte.
Uma aplicação Linux herda TSQ, pacing e contabilidade por meio de sockets comuns. Essa invisibilidade é parte da força: o benefício continua mesmo que o usuário não conheça o nome do autor.
Um host mais rápido não prova que a rota de rede é melhor
Melhorar a fila local não conserta acesso congestionado, receptor lento nem roteadores que perdem pacotes. TSQ e pacing governam o emissor, não toda a rota.
Eles podem reduzir uma fonte de atraso e tornar o fluxo mais regular. Não garantem resultado de aplicação. O desempenho ponta a ponta continua dependendo de aplicação, receptor, caminho e configuração.
Um benchmark não representa cada servidor, NIC e workload
Tamanho de pacote, conexões, CPU, cache, NIC, offloads, qdisc, timers, kernel e carga mudam o resultado. Um perfil do Google pode descobrir um custo real sem prever a porcentagem em outra frota.
A boa informação conserva condições. As palestras de Dumazet são evidência operacional atribuída; provas públicas e medições independentes são necessárias para generalizar.
A sucessão é um problema técnico porque grande parte do design vive na memória
Limites estranhos podem existir por causa de uma NIC antiga, uma API ainda usada ou uma regressão esquecida. O código nem sempre explica o porquê.
Mantenedores veteranos carregam esse contexto. Documentação, testes, arquivos e novos revisores convertem memória privada em conhecimento institucional. A sucessão deve preservar princípios e permitir revisá-los para hardware futuro.
Hardware pacing e memória de dispositivo podem mover novamente a fronteira
NICs modernas programam pacotes, gerenciam mais filas e expõem telemetria ou memória local. Reduzem CPU e deslocam comportamento para o firmware.
O Linux precisa expressar intenção, observar o que ocorreu e se recuperar quando hardware e software divergem. APIs de driver, timestamps e erros serão tão importantes quanto a taxa. Os princípios continuam: feedback, limites a filas ocultas e observabilidade.
A economia de cache pode oferecer mais ganhos do que novas fórmulas de transporte
Continuarão surgindo algoritmos de congestionamento, mas a próxima melhoria material pode ser um layout, lock ou batch aprimorado. Não tem marca atraente e beneficia múltiplos algoritmos.
O trabalho de 2024 mostra uma pilha madura avaliada por custos físicos. A pergunta passa de “qual protocolo vence” para “quanta máquina cada conexão consome”.
A contribuição duradoura de Dumazet é disciplina de recursos, não uma lenda heroica
Uma versão exagerada o tornaria inventor do TCP moderno e do BBR; outra apagaria o indivíduo na comunidade. A evidência permite uma posição precisa.
Ele introduziu o TSQ, assinou trabalho fundacional nosch_fq, impulsionou pacing interno e mostrou a relevância do layout. Também mantém áreas críticas dentro de um sistema compartilhado. Sua contribuição é tratar pacotes e sockets como demandas de tempo, memória, fila e localidade de CPU.
O impacto final se dispersa entre design, revisão, integração e operação. Um commit é atribuído; uma frota mais densa ou uma queda evitada não. Essa dificuldade não autoriza exagero nem apagamento: mostra que o valor de infraestrutura nasce de uma cadeia coletiva com decisões individuais identificáveis.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance