Résumé
- Le premier projet public « HTML Templates » du W3C, daté du 14 février 2013, proposait de conserver des sous-arbres DOM inertes pour en créer ensuite des exemplaires.
- Les textes HTML de 2014 ont installé
templatedans le langage. Aujourd'hui,template.contentdonne accès à unDocumentFragmentque le programme peut copier, garnir puis insérer.
Onze heures cinquante-huit. La rédaction publie un fait divers, une décision de justice et le portrait d'un marin; il faut trois fiches avant midi. Chacune aura son titre et son image, mais les mêmes emplacements et le même lien de lecture. Refaire vingt fois ce montage sans perdre une balise ressemble vite à un concours de maladresse. Pendant longtemps, les pages dynamiques ont caché des morceaux de HTML ou composé des chaînes de caractères avant de les faire avaler par le navigateur.
Drôle de cuisine : le navigateur possédait déjà un excellent analyseur HTML, mais aucun placard bien défini pour ranger un fragment en attendant le service.
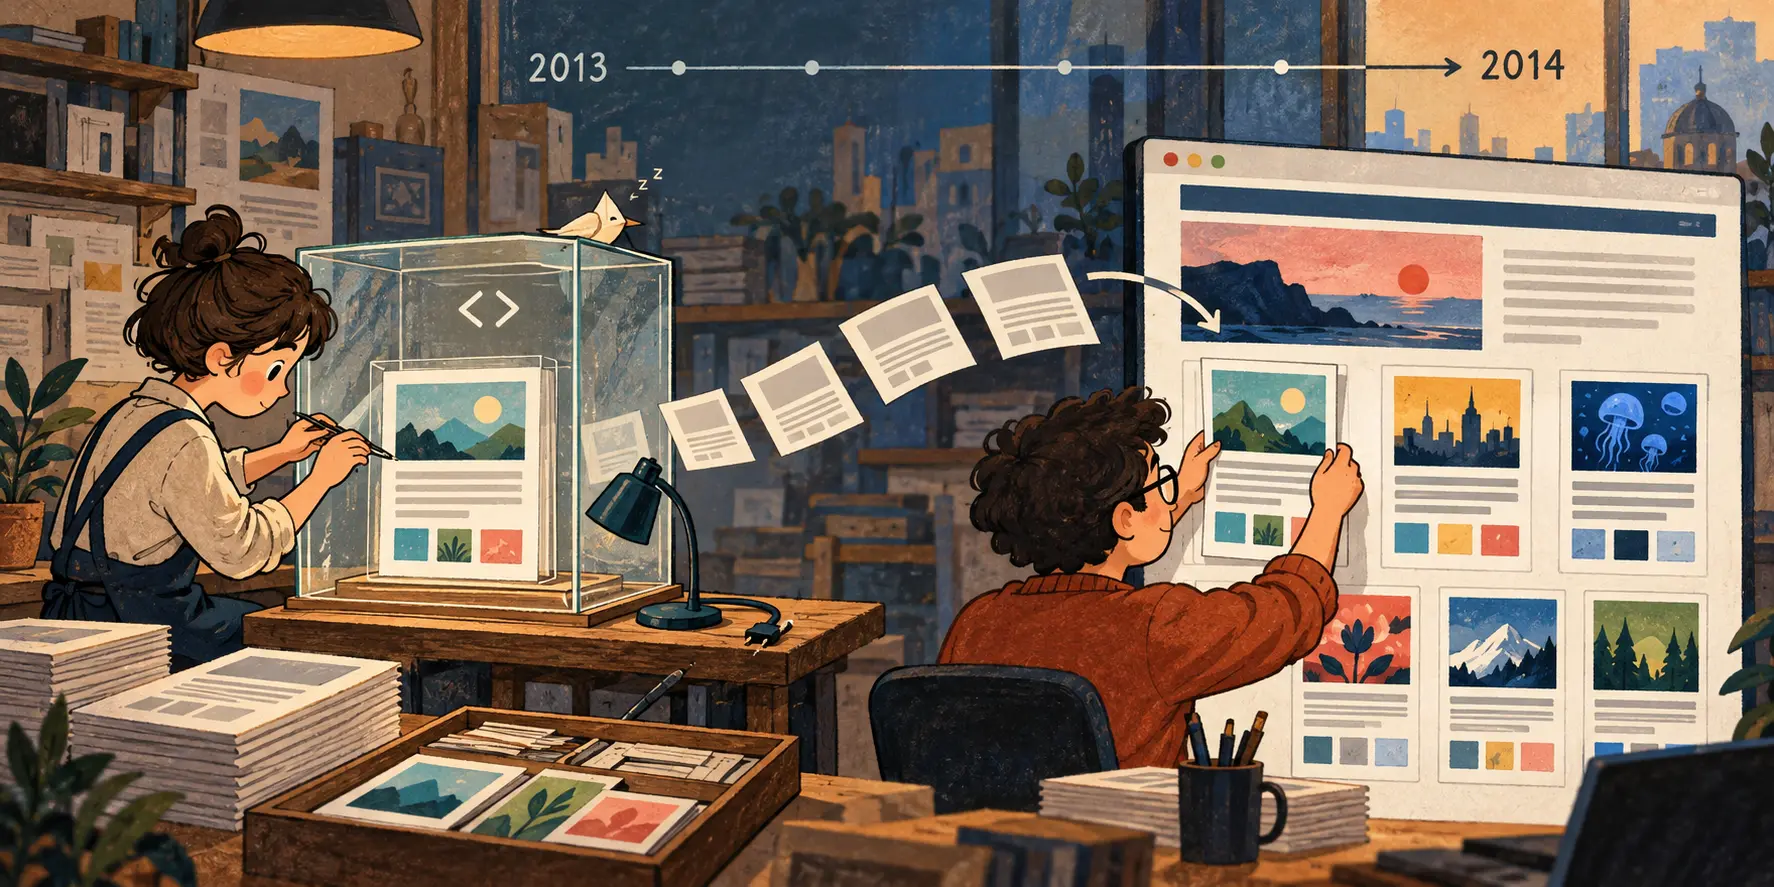
Le projet public du W3C du 14 février 2013 dessine ce placard. Une balise <template> reçoit du HTML que le navigateur analyse tout de suite. Le contenu reste inerte. Un programme peut ensuite en tirer des exemplaires. La nouveauté tient au calendrier : préparer une structure maintenant, la faire entrer dans la page plus tard, à l'instant choisi par l'auteur.
Le tour de passe-passe se voit dans l'arbre DOM. Les balises écrites entre l'ouverture et la fermeture de template ne résident pas parmi ses enfants ordinaires. Elles habitent le fragment accessible par template.content. Le projet HTML 5.1 de février 2014 décrit un document propriétaire séparé, dépourvu de contexte de navigation. Les scripts y restent muets, les contrôles ne participent pas aux formulaires de la page, et la balise ne dessine rien à l'écran. Le navigateur a construit le décor sans lever le rideau.
L'exemple choisi par cette ébauche est une table de chats. La structure d'une ligne dort dans le modèle; un script en copie le fragment, remplit les cellules avec les renseignements d'un animal, puis ajoute la ligne au tableau. Une rédaction ferait pareil avec ses fiches : même ossature, titres et images propres à chaque récit. Elle peut inspecter la copie, corriger un lien et ne publier cette copie qu'une fois prête. Le modèle reste disponible pour la suivante.
La recommandation HTML5 du 28 octobre 2014 intègre la balise au texte principal. L'historique officiel du W3C retrace le petit dossier autonome, du projet de 2013 à la note de 2014. La place administrative du mécanisme a changé; son geste quotidien, lui, tient toujours en trois verbes : copier, remplir, insérer.
Le standard HTML actuel définit encore le modèle comme une déclaration de fragments que le script peut cloner et insérer. Le fragment possède ses propres règles de copie, et template ne représente rien dans le rendu. Ces précisions ont une conséquence très terre à terre. Chercher directement des enfants sous la balise, c'est souvent fouiller l'étagère au lieu d'ouvrir la caisse marquée content.
L'heure du bouclage donne tout son intérêt à ce petit mécanisme. Le rédacteur peut remplacer l'image du marin et corriger le lien du fait divers dans leurs copies respectives; le patron de la fiche attend la prochaine nouvelle, intact. Vingt fiches sortent d'une seule structure proprement analysée. Le magasinier du navigateur sait où sont les pièces; la rédaction garde la main sur ce qu'elle publie.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance