
Resumen
- El Netlib descrito por sus creadores en 1987 entregaba software matemático en respuesta a solicitudes por correo electrónico. Junto a una rutina podía enviar las otras que esta llamaba.
- La respuesta automática dependía de una colección seleccionada, descrita y organizada. En septiembre de 1995, algunas opciones detalladas del correo seguían pendientes de incorporación a la interfaz web.
Una biblioteca de software puede conceder exactamente lo pedido y dejar al solicitante con otro problema. Llega el archivo, pero ese archivo llama a otros. Hay que encontrarlos. Después aparecen los que necesitan esos otros. El investigador quería resolver una ecuación; el ordenador le ha asignado una excursión por el catálogo.
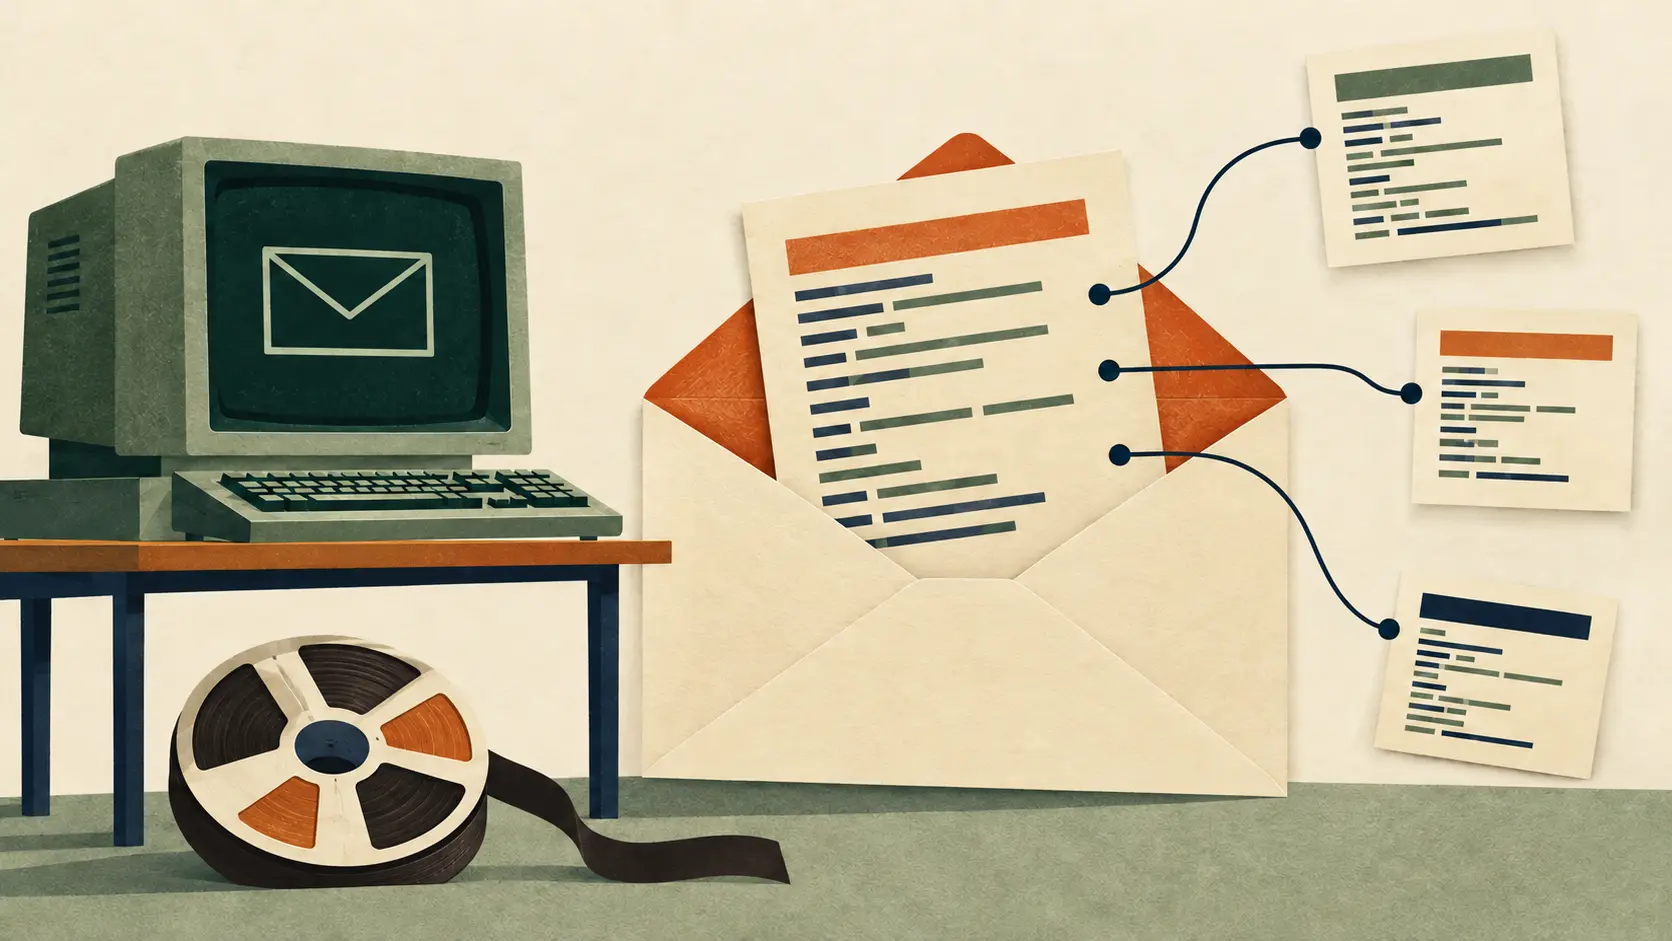
Netlib asumía parte de esa búsqueda. En el artículo que Jack J. Dongarra y Eric Grosse publicaron en mayo de 1987, una petición por correo electrónico podía traer la rutina elegida junto con las rutinas auxiliares que llamaba. El servicio reunía las piezas antes de contestar.
La necesidad era pequeña y concreta. Un investigador podía requerir solo una parte de un paquete de software matemático. Las grandes colecciones distribuidas en cinta magnética obligaban a conseguir el soporte y a lidiar, en ocasiones, con formatos escritos por otro sistema. Entre localizar al autor y leer la cinta, obtener unas pocas líneas útiles podía exigir una operación desproporcionada.
Netlib ofrecía dos destinos de correo, en Argonne National Laboratory y AT&T Bell Labs. Las pasarelas permitían que llegaran mensajes desde otras redes. Se podía pedir un índice general, el de una biblioteca determinada, rutinas por su nombre o una búsqueda por palabra clave. El ordenador devolvía el material. La petición podía tener el tamaño del trabajo que el usuario quería hacer.
La parte interesante sucedía al preparar la respuesta. Una rutina realiza una tarea dentro de un programa y puede recurrir a otras para completarla. El servidor interpretaba los nombres de bibliotecas como una lista donde buscar y utilizaba el cargador del sistema para resolver los nombres de las rutinas necesarias. Convertía el mapa resultante en una lista de archivos que debía devolver. El cálculo del investigador se realizaría después, en su propia máquina.
Había margen para quien conociera bien la colección. Podía solicitar únicamente el archivo nombrado, excluir una rama de rutinas subordinadas o pedir solo los nombres de los archivos. Si ya tenía parte del código, podía ajustar el envío. La orden expresaba cuánto del conjunto quería recibir.
No todos escribían como si estuvieran dando órdenes a una máquina. Los autores cuentan que algunos usuarios pedían las cosas con cortesía, sin saber que un programa leía el mensaje. El sistema toleraba pequeñas desviaciones, aceptaba solicitudes en el asunto e incluso entendía el número 4 como sustituto de determinadas palabras inglesas. Podía soportar una petición amable sin convertirse por ello en un conversador. El agradecimiento era opcional; indicar bien la rutina resultaba bastante más útil.
La introducción a los servicios Netlib de agosto de 1994 mantenía esa descripción del correo: rutinas, auxiliares y los documentos o programas de prueba solicitados que hubieran proporcionado sus autores. Para entonces había accesos gráficos, como Xnetlib, y navegadores. Las nuevas puertas daban entrada a una colección que seguía necesitando mantenimiento.
Encontrar una rutina adecuada exigía otra clase de trabajo. Las directrices de los índices, iniciadas en 1992, pedían explicar qué problema resolvía cada entrada. La descripción debía entenderse fuera de su página, porque una búsqueda podía mostrarla aislada. Alguien tenía que convertir un nombre de archivo en una pista útil para otra persona.
También había una selección editorial. El informe del proyecto de septiembre de 1995 encargaba a los editores valorar el ámbito, la novedad y la calidad de las aportaciones. La máquina contestaba apoyándose en ese trabajo y en la información sobre las relaciones entre archivos.
El mismo informe recoge una diferencia curiosa entre las interfaces. En el sitio de Tennessee, la web ofrecía un enlace para un archivo y otro para el archivo con su árbol de dependencias. Todavía le faltaban opciones que el correo ya permitía: excluir una rama o elegir los directorios donde buscar código auxiliar. La novedad visual no había agotado las habilidades de la vieja correspondencia.
La utilidad de Netlib estaba en la respuesta completa. El investigador pedía una pieza y el servicio reunía las que esa pieza necesitaba llamar. Recibir software dejaba de exigir que cada destinatario repitiera toda la búsqueda. La ecuación podía volver a ocupar el centro de la mesa.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance