
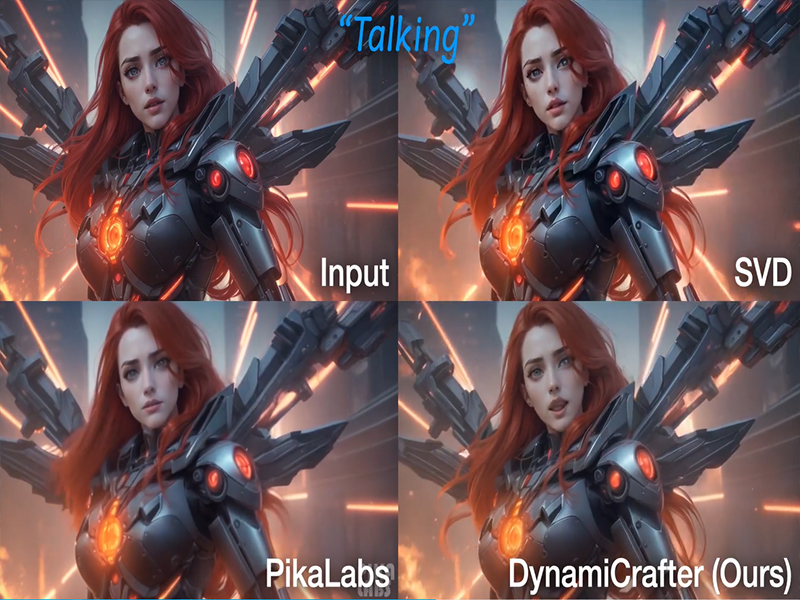
- Tencent hat eine neue Version seines Open-Source-Videogenerierungsmodells DynamiCrafter auf GitHub veröffentlicht.
- Dieses Update konzentriert sich hauptsächlich auf die Animation von Naturszenen mit stochastischen Dynamiken (wie Wolken und Flüssigkeiten) oder domänenspezifischen Bewegungen.
- Nach der Text- und Bildgenerierung wird die Videogenerierung die nächste Herausforderung im Wettlauf um künstliche Intelligenz sein.
Einige der größten chinesischen Technologieunternehmen verstärken leise ihre Bemühungen, im Bereich Text-zu-Video und Bild-zu-Video Fuß zu fassen. Am 5. Februar veröffentlichte der chinesische Internetriese Tencent, vor allem bekannt für sein Videospiel-Imperium und seinen Messaging-Dienst WeChat,veröffentlichte eine neue Versionseines Open-Source-Videogenerierungsmodells DynamiCrafter auf GitHub.
Wie es funktioniert
Wie andere Videogenerierungswerkzeuge auf dem Markt verwendet DynamiCrafter eine Diffusionsmethode, um Bildunterschriften und Standbilder in einige Sekunden lange Videos umzuwandeln. Inspiriert von natürlichen Diffusionsphänomenen in der Physik können Diffusionsmodelle im maschinellen Lernen einfache Daten in komplexere und realistischere Daten umwandeln, ähnlich wie sich Partikel von einem Bereich hoher Konzentration in einen Bereich niedriger Konzentration bewegen.
Lesen Sie auch: Die KI-gestützte Suche von Google generiert jetzt Bilder
Die zweite Generation von DynamiCrafter erzeugt Videos mit einer Auflösung von 640 x 1024 Pixeln, eine Verbesserung gegenüber den erstmals im Oktober veröffentlichten Videos mit 320 x 512 Pixeln. In einer von dem Team hinter DynamiCrafter veröffentlichten wissenschaftlichen Arbeit wird darauf hingewiesen, dass sich seine Technik von der Konkurrenz dadurch unterscheidet, dass sie die Anwendbarkeit von Bildanimationstechniken auf „allgemeinere visuelle Inhalte“ erweitert.
„Die Kernidee besteht darin, die Bewegungspriore von Text-zu-Video-Diffusionsmodellen zu nutzen, indem Bilder als Leitfaden in den Generierungsprozess integriert werden“, heißt es in dem Artikel. Im Gegensatz dazu konzentrieren sich „traditionelle“ Techniken hauptsächlich auf die Animation vonNaturszenen mit zufälligen Dynamiken(z. B. Wolken und Flüssigkeiten) oder domänenspezifischen Bewegungen (z. B. Haare oder Bewegungen des menschlichen Körpers).
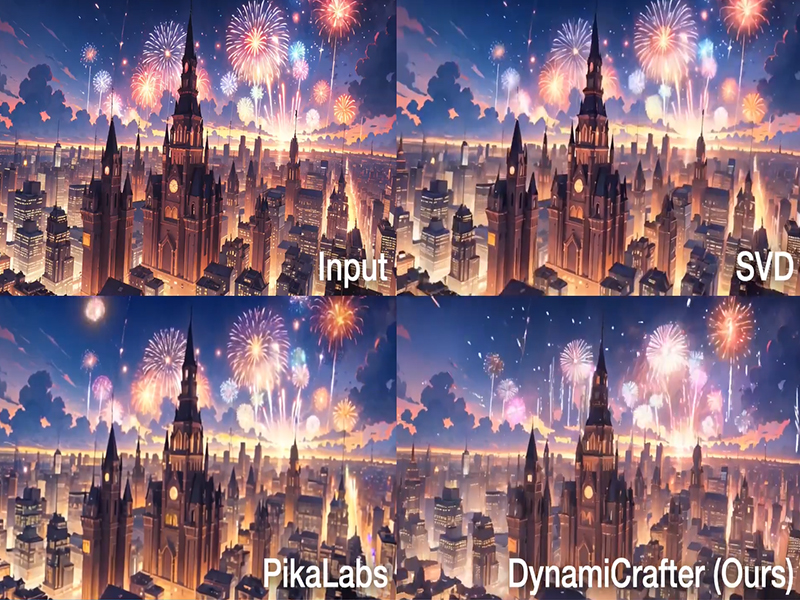
In einer Demonstration, bei der DynamiCrafter, Stable Video Diffusion (im November veröffentlicht) und das kürzlich erschienene Pika Labs verglichen wurden, scheinen die Ergebnisse des Tencent-Modells robuster zu sein als die anderen. Unvermeidlich wird die ausgewählte Stichprobe zugunsten von DynamiCrafter ausfallen.
Ein neuer waffenloser Wettbewerb zwischen Unternehmen
Es ist unbestreitbar, dass nach der Text- und Bildgenerierung die Videogenerierung die nächste Herausforderung im Wettlauf um künstliche Intelligenz sein wird. Folglich werden Startups und Technologieunternehmen voraussichtlich erhebliche Ressourcen in diesen Bereich investieren. China ist keine Ausnahme. Neben Tencent und der Muttergesellschaft von TikTok, ByteDance, haben auch Baidu und Alibaba ihre eigenen Videodiffusionsmodelle veröffentlicht.
MagicVideo von ByteDance und UniVG von Baidu haben beide Demos auf GitHub veröffentlicht, aber keine scheint öffentlich zugänglich zu sein. Wie Tencent hat Alibaba den Quellcode seines Videogenerierungsmodells VGen geöffnet, eine Strategie, die bei chinesischen Technologieunternehmen, die eine globale Entwickler-Community erreichen wollen, immer beliebter wird.