
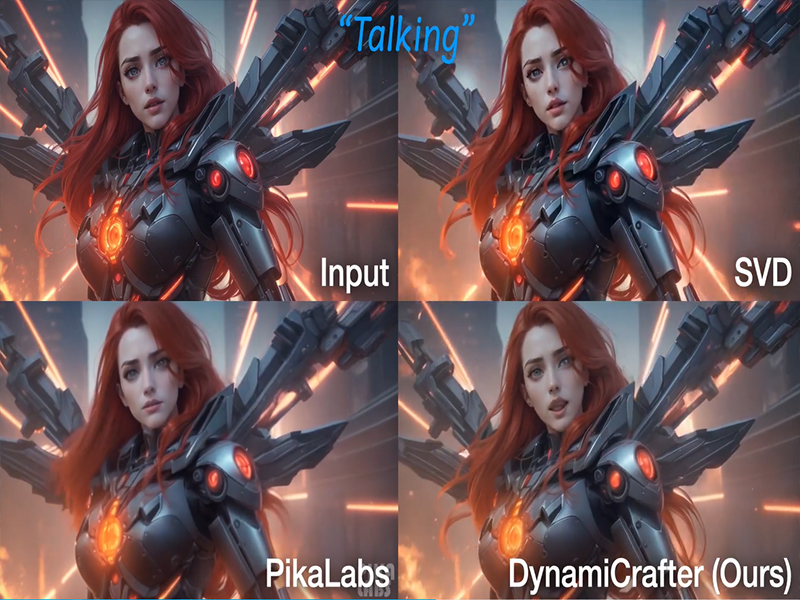
- Tencent は、オープンソースの動画生成モデル DynamiCrafter の新バージョンを GitHub で公開しました。
- この更新は、主に確率的な動き(雲や流体など)を持つ自然風景や、特定の分野の動きのアニメーションに焦点を当てています。
- テキスト生成や画像生成に続き、動画生成が人工知能競争の次の争点になると予想されています。
中国の大手テクノロジー企業の一部は、テキスト・画像から動画の分野に足場を築くため、水面下で取り組みを強化しています。2 月 5 日、ゲーム帝国とメッセージアプリ WeChat で広く知られる中国のインターネット大手 Tencent は、オープンソースの動画生成モデル DynamiCrafter の新バージョンを GitHub で公開しました。
仕組み
市場にある他の動画生成ツールと同様、DynamiCrafter は拡散法を用いて、キャプションと静止画を数秒の動画に変換します。物理学の自然拡散現象に着想を得て、機械学習の拡散モデルは、粒子が高濃度領域から低濃度領域へ移動するのと同じように、単純なデータをより複雑でリアルなデータへと変換できます。
第 2 世代の DynamiCrafter は、640×1024 ピクセルの解像度の動画を生成し、これは 10 月に初めて公開された 320×512 の動画からの改善です。DynamiCrafter の開発チームが発表した学術論文によると、この技術は競合他社と異なり、画像アニメーション技術の適用範囲を「より一般的なビジュアルコンテンツ」に拡大しています。
「重要なアイデアは、画像をガイドとして生成プロセスに組み込むことで、テキストから動画への拡散モデルの動きの事前知識を活用することです」と論文は述べています。一方、「伝統的な」技術は、主にランダムな動きを持つ自然風景(例:雲や流体)や、特定分野の動き(例:髪や人体の動き)のアニメーションに焦点を当てています。
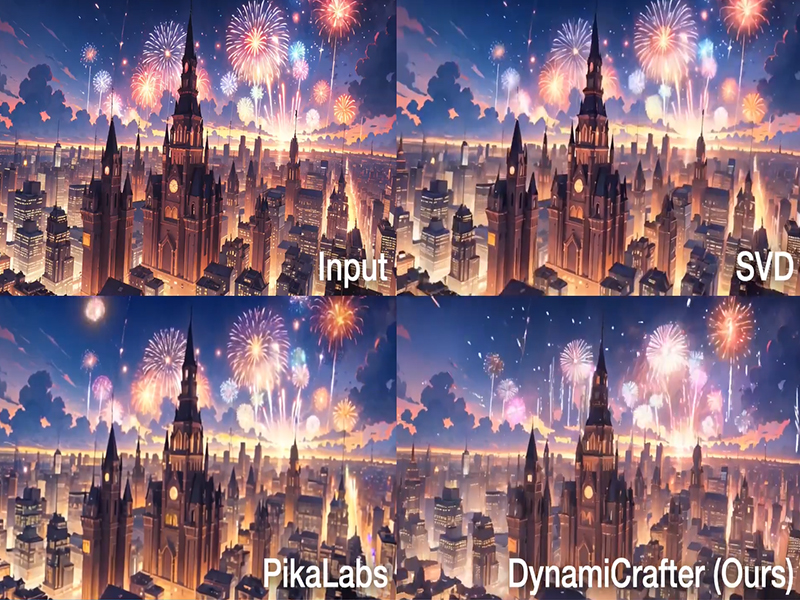
DynamiCrafter、Stable Video Diffusion(11 月公開)、最近の Pika Labs を比較したデモでは、Tencent のモデルの結果が他よりも堅牢に見えます。当然ながら、選ばれたサンプルは DynamiCrafter に有利に傾いているでしょう。
企業間の新たな静かなる戦い
テキスト生成や画像生成に続き、動画生成が人工知能競争の次の課題になることは間違いありません。その結果、スタートアップやテクノロジー企業はこの分野に大量のリソースを投入すると予想されます。中国も例外ではありません。Tencent や TikTok の親会社 ByteDance に加え、Baidu や Alibaba も独自の動画拡散モデルを公開しています。
ByteDance の MagicVideo と Baidu の UniVG はともに GitHub でデモを公開していますが、どちらも一般公開されているようには見えません。Tencent と同様に、Alibaba も動画生成モデル VGen のソースコードを公開しており、これはグローバルな開発者コミュニティにリーチしようとする中国のテクノロジー企業の間でますます人気が高まっている戦略です。