
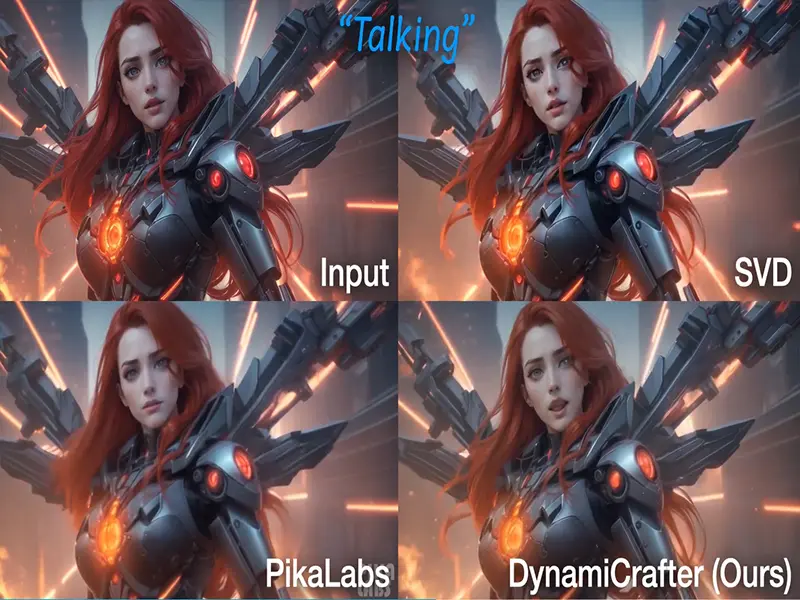
- Tencent опубликовал новую версию своей модели генерации видео с открытым исходным кодом DynamiCrafter на GitHub.
- Это обновление в основном сосредоточено на анимации природных сцен со стохастической динамикой (например, облаков и жидкостей) или движений, специфичных для конкретной области.
- После генерации текста и изображений генерация видео, как ожидается, станет следующим этапом гонки в сфере искусственного интеллекта.
Некоторые из крупнейших китайских технологических компаний незаметно активизируют усилия, чтобы закрепиться в области преобразования текста и изображений в видео. 5 февраля китайский интернет-гигант Tencent, известный прежде всего своей игровой империей и мессенджером WeChat,опубликовал новую версиюсвоей модели генерации видео с открытым исходным кодом DynamiCrafter на GitHub.
Как это работает
Как и другие инструменты генерации видео на рынке, DynamiCrafter использует диффузионный метод для преобразования подписей и неподвижных изображений в видеоролики продолжительностью несколько секунд. Вдохновлённые природными диффузионными явлениями в физике, диффузионные модели машинного обучения могут превращать простые данные в более сложные и реалистичные, подобно тому как частицы перемещаются из области высокой концентрации в область низкой концентрации.
Читайте также: Поиск Google на базе ИИ теперь генерирует изображения
Второе поколение DynamiCrafter создаёт видео с разрешением 640 × 1024 пикселя — это улучшение по сравнению с видео 320 × 512, впервые опубликованным в октябре. В научной статье, опубликованной командой, стоящей за DynamiCrafter, отмечается, что её метод отличается от конкурентов тем, что расширяет применимость методов анимации изображений на «более общий визуальный контент».
«Ключевая идея состоит в том, чтобы использовать априорные представления о движении в диффузионных моделях преобразования текста в видео, включая изображения в процесс генерации в качестве ориентира», — говорится в статье. В отличие от этого, «традиционные» методы в основном сосредоточены на анимацииприродных сцен со случайной динамикой(например, облаков и жидкостей) или движений, специфичных для конкретной области (например, волос или движений человеческого тела).
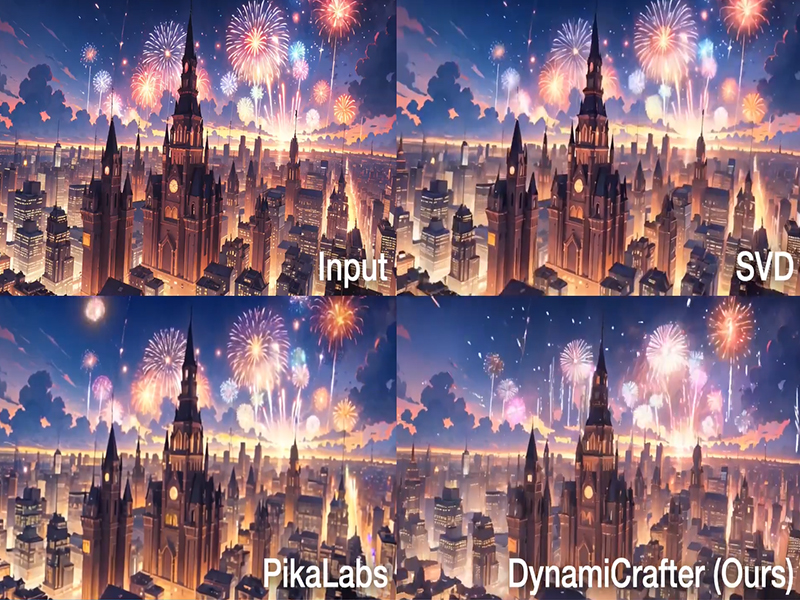
В демонстрации, сравнивающей DynamiCrafter, Stable Video Diffusion (выпущенную в ноябре) и недавнюю Pika Labs, результаты модели Tencent выглядят более надёжными, чем у других. Неизбежно выбранный образец будет в пользу DynamiCrafter.
Новая бескровная война между компаниями
Нельзя отрицать, что после генерации текста и изображений генерация видео, как ожидается, станет следующим этапом гонки в сфере искусственного интеллекта. В результате стартапы и технологические компании, вероятно, вложат в эту область значительные ресурсы. Китай не исключение. Помимо Tencent и материнской компании TikTok ByteDance, собственные модели диффузии видео выпустили также Baidu и Alibaba.
MagicVideo от ByteDance и UniVG от Baidu опубликовали демонстрации на GitHub, но ни одна из них, судя по всему, не находится в открытом доступе. Как и Tencent, Alibaba открыла исходный код своей модели генерации видео VGen — стратегия, которая становится всё более популярной среди китайских технологических компаний, стремящихся охватить мировое сообщество разработчиков.