
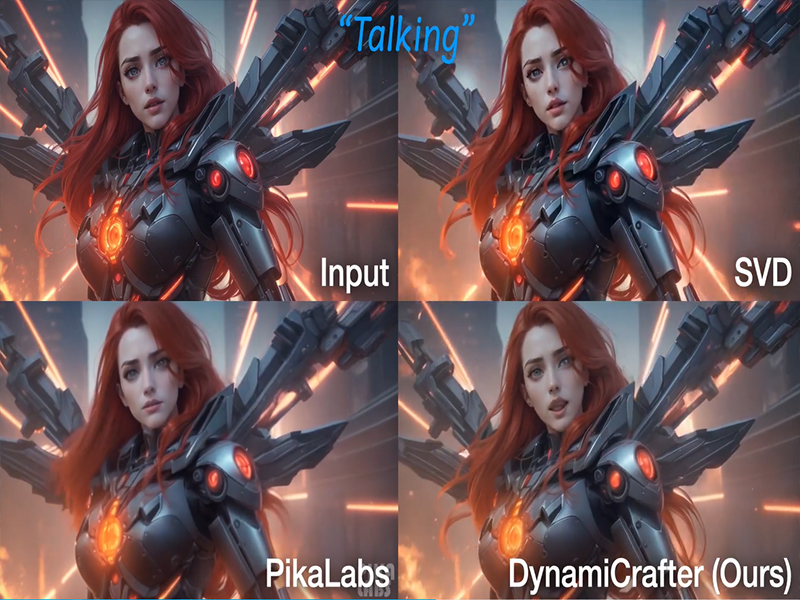
- A Tencent publicou uma nova versão de seu modelo de geração de vídeo open source, DynamiCrafter, no GitHub.
- Esta atualização se concentra principalmente na animação de cenas naturais com dinâmicas estocásticas (como nuvens e fluidos) ou movimentos específicos de domínio.
- Após a geração de texto e imagens, a geração de vídeos deve ser o próximo desafio na corrida pela inteligência artificial.
Algumas das maiores empresas de tecnologia chinesas estão intensificando discretamente seus esforços para ganhar espaço no segmento de texto e imagem para vídeo. Em 5 de fevereiro, a gigante chinesa de internet Tencent, conhecida principalmente por seu império de jogos e pelo aplicativo de mensagens WeChat,publicou uma nova versãode seu modelo de geração de vídeo open source DynamiCrafter no GitHub.
Como funciona
Como outras ferramentas de geração de vídeo no mercado, o DynamiCrafter utiliza um método de difusão para converter legendas e imagens fixas em vídeos de alguns segundos. Inspirados pelos fenômenos de difusão natural na física, os modelos de difusão em aprendizado de máquina podem transformar dados simples em dados mais complexos e realistas, da mesma forma que as partículas se movem de uma região de alta concentração para uma região de baixa concentração.
Leia também: A pesquisa com IA do Google agora gera imagens
A segunda geração do DynamiCrafter produz vídeos com resolução de 640 x 1024 pixels, uma melhoria em relação ao vídeo de 320 x 512 publicado pela primeira vez em outubro. Um artigo acadêmico publicado pela equipe por trás do DynamiCrafter observa que sua técnica difere dos concorrentes por ampliar a aplicabilidade das técnicas de animação de imagens para "conteúdo visual mais geral".
"A ideia chave é explorar os priores de movimento dos modelos de difusão de texto para vídeo, incorporando imagens no processo de geração como guia", diz o artigo. Em contraste, as técnicas "tradicionais" se concentram principalmente na animação de cenas naturais com dinâmicas aleatórias (por exemplo, nuvens e fluidos) ou movimentos específicos de domínio (por exemplo, cabelos ou movimentos do corpo humano).
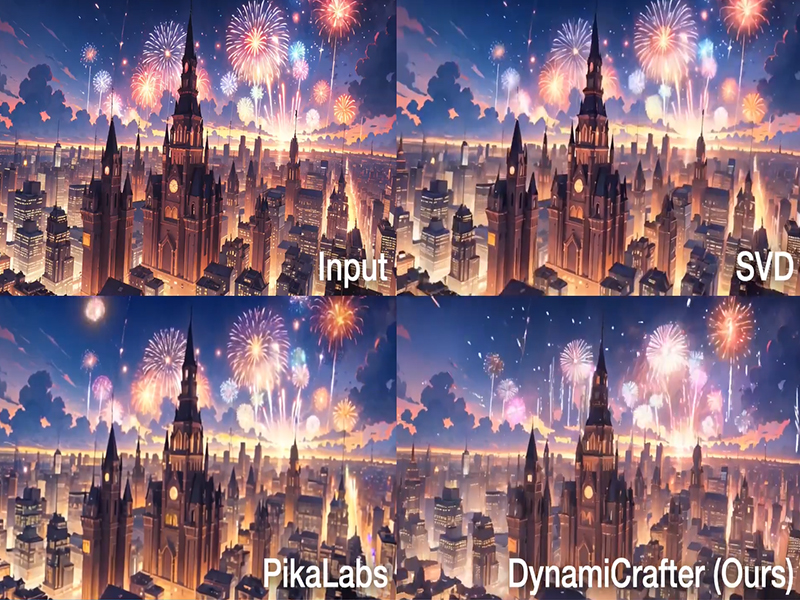
Em uma demonstração comparando DynamiCrafter, Stable Video Diffusion (publicado em novembro) e o recente Pika Labs, os resultados do modelo da Tencent parecem mais robustos que os demais. Inevitavelmente, a amostra escolhida favorece o DynamiCrafter.
Uma nova guerra sem armas entre empresas
É inegável que, após a geração de texto e imagens, a geração de vídeos deve ser o próximo desafio na corrida pela inteligência artificial. Consequentemente, startups e empresas de tecnologia devem investir recursos significativos nessa área. A China não é exceção. Além da Tencent e da controladora do TikTok, ByteDance, Baidu e Alibaba também publicaram seus próprios modelos de difusão de vídeo.
O MagicVideo da ByteDance e o UniVG da Baidu publicaram demonstrações no GitHub, mas nenhuma parece estar acessível ao público. Assim como a Tencent, a Alibaba abriu o código-fonte de seu modelo de geração de vídeo, VGen, uma estratégia cada vez mais popular entre as empresas de tecnologia chinesas que buscam alcançar uma comunidade global de desenvolvedores.