Zusammenfassung
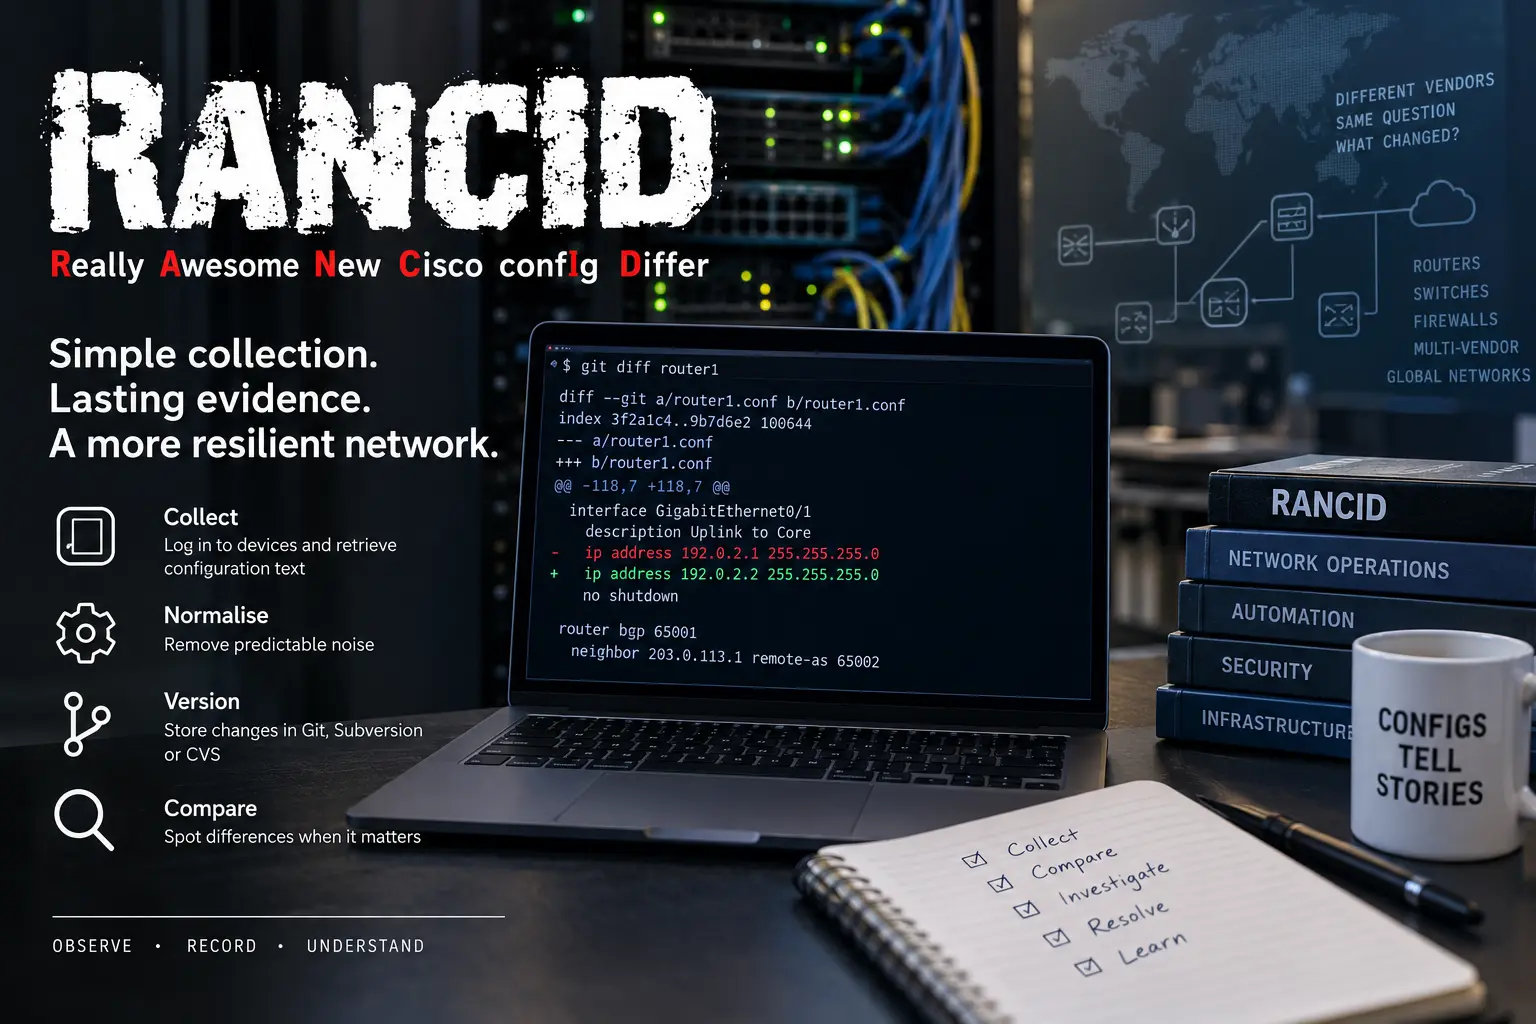
- RANCID—Really Awesome New Cisco confIg Differ—sammelt periodisch Gerätekonfigurationen über herstellerspezifische Anmelde- und Befehlsmodule, normalisiert die Ausgabe und speichert Änderungen in CVS, Subversion oder Git.
- Seine Evidenz ist beobachteter Text, nicht der Sollzustand: Ein Snapshot kann Drift oder eine Notfalländerung aufdecken und dennoch Zwischenbearbeitungen, Laufzeitzustand und die Identität der Person verfehlen, die das Gerät geändert hat.
- Derselbe Host, der die Rekonstruktion von Vorfällen verbessert, kann zu einem hochwertigen Sicherheitsziel werden, weil er Verwaltungsanmeldedaten, Topologie und Konfigurationsgeheimnisse über eine ganze Geräteflotte hinweg speichert.
- RANCID bleibt neben GitOps, Automatisierung und Source-of-Truth-Plattformen nützlich, weil ein unabhängiger Sammler zeigen kann, was ein Gerät gemeldet hat, nachdem der vorgesehene Workflow umgangen oder nur teilweise angewendet wurde.
Nach einem Ausfall ist die kleinste nützliche Frage oft: „Was hat sich geändert?“
Ein Netzwerk kann durch eine komplexe Wechselwirkung aus Routing-Politik, Schnittstellenzustand, Softwarefehlern und Traffic ausfallen. Der erste verwertbare Hinweis kann trotzdem eine einzige Konfigurationszeile sein. Eine Nachbaradresse hat sich geändert. Eine Access-Liste wurde verschoben. Eine Route-Map hat ein zusätzliches Match erhalten. Ein Trunk hat ein VLAN verloren. Das Gerät hat den Befehl akzeptiert, und die betriebliche Wirkung trat später auf, möglicherweise weit vom Punkt der Änderung entfernt.
RANCID wurde um die Notwendigkeit gebaut, genau diese Evidenz zu erhalten. Es verbindet sich mit Routern, Switches und anderen unterstützten Geräten, führt Befehle aus, filtert deren Ausgabe und übergibt den resultierenden Text an die Versionskontrolle. Wenn sich eine Datei ändert, liefert das Repository ein Diff und kann eine E-Mail oder einen anderen Workflow auslösen. Das System muss nicht jede geschäftliche Absicht hinter dem Befehl verstehen, um zu zeigen, dass sich die vom Gerät gemeldete Konfiguration unterscheidet.
Die Bescheidenheit dieses Modells ist eine Stärke. RANCID beansprucht nicht, die vollständige Control Plane zu sein. Es plant keine genehmigte Änderung, erzeugt keine herstellerspezifischen Konfigurationen und garantiert keine Policy-Compliance. Es zeichnet periodische Beobachtungen auf. Das macht es nützlich in gemischten Umgebungen, in denen einige Geräte automatisiert, andere manuell verwaltet und wieder andere zu alt für eine moderne API sind.
Das Modell ist auch bewusst unvollständig. Eine Änderung kann zwischen zwei Abfragen angewendet und zurückgenommen werden. Ein fehlgeschlagener Login kann eine alte Datei aktuell aussehen lassen. Ein Herstellermodul kann den entscheidenden Befehl auslassen. Normalisierung kann ein sich änderndes Feld entfernen, das sich später als wichtig erweist. Ein Diff zeigt, dass der Sammler unterschiedlichen Text beobachtet hat; es beweist nicht, wer das Gerät geändert hat, warum, oder ob die Änderung den Vorfall verursacht hat.
Diese Einschränkungen mindern den Wert der Evidenz nicht – sie definieren ihn. RANCID gibt Betreibern eine dauerhafte, einfach strukturierte Antwort auf eine Frage zu einem Zeitpunkt. Während eines Ausfalls kann diese Antwort nützlicher sein als ein breites Dashboard, das Symptome meldet, ohne den Konfigurationskontext zu bewahren.
Das Projekt gab Routern ein externes Gedächtnis, bevor Controller Mode wurden
RANCID entstand zu einer Zeit, in der Netzwerkgeräte primär über Kommandozeilen verwaltet wurden. Die Konfiguration lag auf Routern und Switches, und das operative Wissen lebte oft in den Erinnerungen, Terminal-Historien oder persönlichen Verzeichnissen der Ingenieure. Ein Gerätetausch oder eine verunglückte Bearbeitung konnte offenlegen, dass die Organisation keinen aktuellen, unabhängigen Datensatz besaß.
Der Name des Projekts begann mit Cisco, aber sein Umfang wuchs durch herstellerspezifische Module. Die Architektur akzeptierte eine unbequeme Tatsache: Netzwerkbetriebssysteme stellen unterschiedliche Prompts, Anmeldesequenzen, Paging-Verhalten und Befehle bereit. Statt auf ein universelles Managementmodell zu warten, automatisierte RANCID die Schnittstellen, die tatsächlich existierten.
Das machte das System über Gerätegenerationen hinweg praktikabel. Ein Sammler konnte ein Login-Skript wiecloginverwenden, getrieben durch Expect, um Prompts und Sitzungen zu handhaben. Ein Herstellermodul konnte Befehle ausführen, die die laufende Konfiguration, Hardwareinventar oder anderen relevanten Zustand zurückgaben. Die Ausgabe ließ sich dann normalisieren und als Text speichern.
Der Ansatz ist spröde auf genau die Weise, wie Kommandozeilenautomatisierung spröde ist. Ein geänderter Prompt kann ein Skript brechen. Eine neue Firmware-Version kann die Befehlsausgabe verändern. Paging, Banner, Authentifizierungsherausforderungen und Timing variieren. Manche Geräte benötigen veraltete Chiffren oder bieten weiterhin Telnet an. Lokale Module können vom Upstream abweichen. Jede unterstützte Plattform trägt Wissen, das gepflegt werden muss.
Doch die Langlebigkeit der Architektur ist ein Beleg dafür, dass Interoperabilität oft durch Anpassung statt durch einen sauberen Standard entsteht. RANCID macht Hersteller-CLIs nicht konsistent. Es schafft einen gemeinsamen Workflow um ihre Inkonsistenz herum. Das Repository wird zur stabilen Schnittstelle, selbst wenn die Sammlung dahinter unterschiedliche Befehle verwendet.
Diese Entscheidung trennte auch das Gedächtnis vom Gerät. Ein Router konnte vollständig ausfallen, und die Organisation besaß dennoch seine zuletzt gesammelte Konfiguration und Änderungshistorie. Das Archiv konnte Ersatz, Audit und Vorfallanalyse unterstützen. Das Gerät blieb die Quelle des beobachteten Textes, aber nicht mehr der einzige Ort, an dem die Organisation sich daran erinnerte.
router.dbmacht aus einer Geräteflotte einen geplanten Sammellauf
Der klassische RANCID-Workflow beginnt mitrouter.db, einem Geräteinventar, das Hostnamen mit Typen und Zuständen verknüpft. Aktive Einträge werden Sammelziele. Gruppen definieren organisatorische Grenzen, Zeitpläne und Repositories. Die Datei ist einfach genug, um sie zu inspizieren und zu versionieren, und doch wichtig genug, um zu bestimmen, welche Geräte im Gedächtnis bleiben und welche unsichtbar sind.
Einfachheit macht Fehler lesbar. Ein falsch geschriebener Hostname, ein falscher Gerätetyp oder ein deaktivierter Zustand lässt sich im Text finden. Das bedeutet aber auch, dass das Inventar nur so vollständig ist wie der Prozess, der es pflegt. Ein Router, der inrouter.dbfehlt, wird nicht durch magische Entdeckung überwacht. Ein stillgelegtes Gerät kann im Archiv verbleiben. Ein Hostname kann zu einer unerwarteten Adresse auflösen. Das Inventar muss mit der tatsächlichen zentralen Quelle der Organisation abgeglichen werden.
Wennrancid-runausgeführt wird, wählt es aktive Geräte aus, ruft die passende Anmelde- und Herstellerlogik auf, holt die Ausgabe ab, vergleicht sie mit der vorherigen Version und committet aussagekräftige Änderungen. Fehler und Wiederholungen sind Teil des Workflows. Ein Gerät kann unerreichbar sein, die Authentifizierung kann fehlschlagen oder ein Befehl kann unvollständige Daten liefern. Das Ergebnis sollte als Sammelereignis mit Status behandelt werden, nicht bloß als Vorhandensein einer Datei.
Diese Unterscheidung ist wichtig, weil verstaunter Erfolg gefährlich sein kann. Ist die neueste Repository-Version Monate alt, kann sie dennoch sauber und lesbar aussehen. Betreiber müssen das Alter der letzten erfolgreichen Sammlung, die Zahl aufeinanderfolgender Fehler und wissen, ob alle erwarteten Befehle abgeschlossen wurden. Ein Konfigurationsarchiv ohne Frische-Überwachung kann falsches Vertrauen erzeugen.
Das Gruppenmodell kann den Schadensradius begrenzen und Zuständigkeit klären. Verschiedene Teams oder Umgebungen können separate Zugangsdaten, Zeitpläne und Repositories verwenden. Hochkritische Geräte können häufiger oder über isolierte Sammler abgefragt werden. Entwicklungs- und Produktionsumgebungen können unterschiedliche Richtlinien behalten. Die Architektur bietet die Möglichkeit; lokale Administratoren entscheiden, ob sie sie nutzen.
RANCIDs Inventar ist keine Netzwerk-Source-of-Truth im modernen Intent-Modellierungssinn. Es ist ein Sammelplan. Diese enge Rolle ist wertvoll, weil sie mit dem vorgesehenen Inventar abgeglichen werden kann. Ein Gerät, das in NetBox vorhanden ist, aber in RANCID fehlt, kann historische Evidenz vermissen lassen. Ein RANCID-Ziel, das im genehmigten Inventar fehlt, kann vergessene Infrastruktur sein. Die Diskrepanz ist oft nützlicher als jede der beiden Listen allein.
Expect-basiertes Login machte Automatisierung möglich und konzentrierte Zugangsdaten
Interaktive Netzwerk-CLIs wurden für Menschen entworfen, nicht für deterministische Software. Sie zeigen Banner, fragen nach Benutzernamen und Passwort, verhandeln Terminalverhalten, pausieren die Ausgabe und ändern den Prompt, wenn Privilegienstufen oder Konfigurationsmodi wechseln. Expect lässt Skripte auf Muster warten und antworten und verwandelt ein Gespräch in eine automatisierte Sequenz.
RANCIDs Anmelde-Werkzeuge wenden diese Methode auf Netzwerkgeräte an. Sie können je nach lokaler Konfiguration und Gerätefähigkeit Telnet oder SSH verwenden, Prompts handhaben, privilegierte Modi betreten und Befehle ausführen. Dadurch konnten Betreiber Geräte lange automatisieren, bevor APIs und modellgetriebenes Management verbreitet waren.
Der Anmeldemechanismus erzeugt eine gravierende Sicherheitskonzentration. Ein Sammler braucht möglicherweise Lesezugriff auf Hunderte oder Tausende Geräte. Zugangsdaten werden üblicherweise in.cloginrcbeschrieben und über Dateisystemrechte und lokale Kontrollen geschützt. Wird der Host oder die Datei kompromittiert, kann ein Angreifer sowohl eine Karte der Flotte als auch Authentifizierungsmaterial für deren Management-Plane erhalten. Wo privilegierte oder geteilte Zugangsdaten verwendet werden, wächst der Schadensradius weiter.
Nur-Lese-Zugriff kann die Fähigkeit reduzieren, Geräte zu ändern, doch die praktische Berechtigung hängt von jeder Plattform ab. Manche Geräte trennen die Anzeige der Konfiguration nicht sauber vom breiteren Befehlszugriff. Das Archiv selbst kann Community-Strings, Passwort-Hashes, Schlüssel, Schnittstellenbeschreibungen, Kundennamen und interne Adressierung offenlegen. Geheimnisfilterung hilft, ist aber keine vollständige Garantie.
Eine sichere Bereitstellung behandelt den RANCID-Host daher als privilegiertes Control-Plane-System. Er sollte segmentiert, gepatcht, gesichert und überwacht werden. Zugangsdaten sollten beschränkt, rotiert und auditiert werden. SSH sollte Telnet ersetzen, wo Geräte es unterstützen. Veraltete Algorithmen sollten isoliert statt auf einem allgemeinen Managementhost breit aktiviert werden. Repository-Zugriff sollte dem Least-Privilege-Prinzip folgen.
Die Verwendung von Expect erzeugt auch betriebliche Abhängigkeiten. Eine strenge Authentifizierungsänderung, eine Mehrfaktor-Anforderung oder eine Prompt-Modifikation kann die Automatisierung brechen. Betreiber brauchen einen unterstützten nicht-interaktiven Pfad, der die Sicherheit nicht einfach schwächt, um die Sammlung am Laufen zu halten. Testgeräte und gestufte Änderungen von Zugangsdaten können einen flottenweiten Verlust der Sichtbarkeit verhindern.
RANCIDs Sicherheitskompromiss ist unmittelbar: Die Zentralisierung der Sammlung verbessert Evidenz und Wiederherstellung und schafft zugleich ein hochwertiges Ziel. Die richtige Antwort ist nicht, die Konzentration zu leugnen, sondern sie konstruktiv zu bewältigen.
Herstellermodule übersetzen instabile Befehlsausgabe in vergleichbaren Text
Ein Cisco-Router, ein Juniper-Gerät und der Switch eines anderen Herstellers stellen nicht dieselben Befehle oder Ausgaben bereit. RANCID behandelt diese Vielfalt über gerätespezifische Module und Anmelde-Logik. Jedes Modul weiß, welche Befehle auszuführen sind und wie die Antwort verarbeitet wird. Die gemeinsame Ausgabe ist kein universelles Datenmodell; es ist eine Menge von Textdateien, die sich vergleichen lassen.
Diese Anordnung erlaubt inkrementelle Unterstützung. Ein Beitragender kann eine Plattform hinzufügen oder aktualisieren, ohne den gesamten Sammler neu zu entwerfen. Langlebige Umgebungen profitieren, weil ein Modul Geräte weiter bedienen kann, die keine neuen Management-APIs mehr erhalten. Betreiber können lokale Module für Spezialausrüstung schreiben.
Der Preis ist fortwährende Parsing-Arbeit. Menschlich lesbare CLI-Ausgabe ist kein stabiler Vertrag. Hersteller ergänzen Überschriften, ordnen Abschnitte um und ändern Leerraum. Firmware-Zweige divergieren. Ein Prompt oder eine Fehlermeldung kann der erwarteten Ausgabe ähneln. Ein Modul kann stillschweigend nur einen Teil der Konfiguration sammeln, wenn ein Befehl umbenannt wird oder Berechtigungen sich ändern.
Testen ist schwierig, weil Maintainer nicht jedes Modell und jede Softwareversion besitzen. Beispielausgaben können Regressions-Tests unterstützen, aber sie können Timing, Authentifizierung oder alle Plattformzustände nicht reproduzieren. Lokale Patches können ein unmittelbares Problem lösen und zugleich einen Zweig schaffen, der Upstream-Korrekturen nicht mehr folgt. Geräteunterstützung sollte daher mit exaktem Typ, Befehlssatz und getesteter Version beschrieben werden, nicht mit einer breiten Markenbehauptung.
Die Module entscheiden auch darüber, was als Konfiguration zählt. Manche Befehle legen Hardwareinventar, Softwareversionen oder Betriebszustand neben der Konfiguration offen. Mehr Daten einzubeziehen kann der Vorfallanalyse helfen, während Diffs verrauschter werden und Repositories wachsen. Sie auszuschließen kann das Archiv sauberer machen, während eine relevante Änderung verborgen bleibt. Es gibt keine kontextfreie korrekte Grenze.
RANCIDs Multi-Hersteller-Leistung ist nicht, dass es proprietäre Schnittstellen beseitigt hätte. Es bewahrte einen konsistenten Evidenz-Workflow trotz ihrer Existenz. Das ist weniger elegant als ein gemeinsames und in Legacy-Betrieb oft unmittelbar nützlicher. Das Repository wird der Vergleichspunkt, während das Modul die Kompromisse dokumentiert, die nötig waren, um ihn zu erreichen.
Normalisierung trennt bedeutsame Änderung von Ausgabe, die bei jedem Lauf wechselt
Ausgabe von Netzwerkgeräten enthält Werte, die in einem Konfigurationsdiff nutzlos sind, weil sie sich fortwährend ändern. Uptime, Zeitstempel, Zähler, Sitzungsbezeichner und erzeugtes kryptografisches Material können jede Sammlung anders erscheinen lassen. RANCID filtert oder maskiert ausgewählte Felder, damit das Repository Änderungen aufzeichnet, die ein Betreiber interpretieren kann.
Normalisierung ist das, was Rohausgabe zu betrieblicher Evidenz macht. Ohne sie könnte eine tägliche E-Mail Hunderte Zeilen enthalten, die sich nur änderten, weil Zeit verging. Ingenieure würden aufhören zu lesen. Durch das Entfernen flüchtiger Felder und die Standardisierung der Ausgabe erlaubt das System, dass eine Ein-Zeilen-Änderung der Richtlinie auffällt.
Die Filterentscheidung ist auch eine Form redaktioneller Macht. Ein als Rauschen entferntes Feld kann später nicht bei der Analyse helfen. Ein Passwort-Hash wird vielleicht aus Sicherheitsgründen maskiert, aber eine Änderung des Hashes kann Beweis dafür sein, dass Zugangsdaten rotiert wurden. Ein Zeitstempel kann irrelevant sein, bis er einen Neustart aufdeckt. Ein dynamischer Bezeichner kann einen routinemäßigen Prozess von einem unerwarteten unterscheiden.
Der richtige Filter hängt vom Zweck des Archivs ab. Ein Compliance-Repository priorisiert vielleicht stabilen Richtlinientext und aggressive Geheimnisentfernung. Ein Forensiksystem für Vorfälle kann mehr Kontext an einem geschützten Ort bewahren. Manche Organisationen pflegen separate Ausgaben oder ergänzen RANCID durch Logs und Telemetrie.
Normalisierung kann brechen, wenn sich die Hersteller-Syntax ändert. Ein für ein Format geschriebener regulärer Ausdruck kann zu viel entfernen oder ein Geheimnis nicht entfernen. Reviews sollten daher das gefilterte Ergebnis einbeziehen und, wo sicher, Tests gegen repräsentative Rohausgabe umfassen. Ein sauberes Diff ist kein Beweis, dass keine wichtigen Daten verworfen wurden.
Diese Spannung ist zentral für jedes Observability-System. Nützliche Evidenz ist selten roh. Sie ist ausgewählt, transformiert und beschriftet. RANCID macht diese Transformation im Code und in den Modulen sichtbar. Der verantwortungsbewusste Betreiber weiß, was entfernt wurde, und verwechselt ein ruhiges Repository nicht mit einer vollständigen Darstellung des Gerätezustands.
Versionskontrolle gibt Konfigurationstext eine Zeitleiste, aber keine Transaktionshistorie
RANCID verwendete ursprünglich CVS und unterstützte später Subversion und Git. Versionskontrolle liefert dauerhafte Historie, Diffs, Zeitstempel und einen bekannten Mechanismus für Replikation oder Backup. Sie verwandelt ein Verzeichnis aktueller Dateien in eine Folge beobachteter Zustände.
Ein Commit kann zeigen, dass der Sammler am Montag eine Konfiguration sah und am Dienstag eine andere. Er kann die abweichenden Zeilen identifizieren und den Vergleich mit einem Ausfallzeitfenster unterstützen. Branching und verteilte Kopien in Git können Belastbarkeit und Integration verbessern. Repository-Werkzeuge können Zugriffs- und Aufbewahrungsrichtlinien erzwingen.
Der Commit ist nicht die Gerätetransaktion. Sein Autor kann das RANCID-Dienstkonto sein und nicht der Ingenieur, der die Netzwerkänderung vornahm. Sein Zeitstempel erfasst Sammel- oder Commitzeit, nicht notwendigerweise die Befehlsausführung. Mehrere Gerätebearbeitungen können in einem Diff zusammengefasst werden. Eine Änderung, die zwischen Abfragen angewendet und zurückgenommen wird, erscheint möglicherweise nie.
Das Repository kann auch sensible Daten auf unbestimmte Zeit bewahren. Ein Geheimnis aus der neuesten Datei zu entfernen, entfernt es nicht aus der Historie. Das Umschreiben der Historie ist störend und kann Kopien anderswo hinterlassen. Geheimnis-Scanning, Zugriffskontrollen und sorgfältige Modulfilterung sind notwendig, bevor die Konfiguration einer großen Flotte committet wird.
Repository-Integrität ist wichtig. Ein Angreifer, der den Sammler kompromittiert, kann aktuelle Dateien oder die Historie verändern, Diffs unterdrücken oder irreführende Evidenz einfügen. Remote-Spiegel, signierte Commits oder unveränderliche Backups können Vertrauen verbessern, doch jedes braucht ein Bedrohungsmodell. Gewöhnliche Versionskontrolle zeichnet Änderungen auf; sie beweist nicht automatisch, dass der Datensatz authentisch ist.
Aufbewahrung sollte betrieblichen und rechtlichen Anforderungen entsprechen. Lange Historie kann wiederkehrende Drift aufdecken und Audit-Evidenz liefern. Sie erhöht auch Exposition und Speicherbedarf. Ein Unternehmen sollte entscheiden, wie viel Historie es braucht und wie es sie schützen oder entsorgen wird.
RANCIDs Nutzung der Versionskontrolle war strategisch dauerhaft, weil es ein allgemeines Werkzeug wiederverwendete statt ein proprietäres Archiv zu erfinden. Dasselbe Repository kann mit Standardbefehlen inspiziert und in andere Workflows integriert werden. Seine Bedeutung bleibt begrenzt: Es ist eine Zeitleiste gesammelter Texte, kein garantiertes Register jeder Netzwerkaktion.
Periodische Sammlung lässt eine Lücke, in der die wichtigste Änderung geschehen kann
RANCIDs zentrale Begrenzung ist die Zeit. Es sieht Snapshots. Wird ein Gerät stündlich abgefragt, können zwischen den Beobachtungen neunundfünfzig Minuten Aktivität stattfinden. Eine schädliche Änderung kann eingeführt, Störungen verursachen und entfernt werden, bevor der Sammler läuft. Das Repository zeigt keinen Unterschied, obwohl das Netzwerk ein reales Ereignis erlebte.
Höhere Frequenz verengt die Lücke, erhöht aber die Last. Sich bei vielen Geräten anzumelden, Befehle auszuführen und Ausgaben zu verarbeiten, verbraucht CPU, Management-Bandbreite und Geräte-Ressourcen. Manche Plattformen behandeln gleichzeitige Sitzungen schlecht. Ein Sammler muss Aktualität mit Stabilität abwägen.
Sammelfehler weiten die Lücke unvorhersehbar aus. Ein Routing-Vorfall kann den Management-Pfad gerade in dem Moment isolieren, in dem Konfigurationsevidenz am wertvollsten ist. Authentifizierungsänderungen können den Zugriff blockieren. Ein langsamer Befehl kann ein Timeout überschreiten. Ein Gerät unter Belastung kann unvollständige Ausgabe liefern. Das Fehlen eines neuen Commits muss von der Bestätigung unterschieden werden, dass nichts geändert wurde.
Ereignisgesteuerte oder Streaming-Systeme können periodische Snapshots ergänzen. Geräte-Audit-Logs können Befehle und Benutzer aufzeichnen. Automatisierungsplattformen können beabsichtigte Änderungen aufzeichnen. Telemetrie kann den Laufzeitzustand zeigen. Controller können Transaktionsergebnisse bereitstellen. Keines ersetzt automatisch den unabhängigen Snapshot. Jedes sieht eine andere Schicht und kann auf einem anderen Weg versagen.
Die Lücke betrifft auch Rollbacks. Eine frühere RANCID-Datei kann Referenztext liefern, aber sie blind zu pushen kann unsicher sein. Das Gerät kann Software, Hardware oder umgebende Abhängigkeiten gewechselt haben. Der Snapshot kann generierte Werte oder Geheimnisse enthalten. Die Organisation sollte ihn als Evidenz für einen überprüften Wiederherstellungsprozess nutzen, nicht als automatisch ausführbare Wahrheit – es sei denn, sie hat diesen Workflow aufgebaut und getestet.
Der Wert von RANCID steigt, wenn seine blinden Flecken gemessen werden. Betreiber können Zeit des letzten Erfolgs, Abfrageintervall, Befehlsabschluss und Repository-Commit-Status aufzeichnen. Sie können Snapshots mit Change-Tickets und Geräte-Audit-Logs vergleichen. Ein fehlendes erwartetes Diff wird zum Signal, dass der Sammelprozess oder der Änderungsnachweis unvollständig ist.
Periodische Beobachtung ist nicht umfassend, aber sie ist unabhängig. Diese Unabhängigkeit ist der Grund, warum das Werkzeug neben Systemen nützlich bleibt, die Echtzeitkontrolle versprechen.
Der RANCID-Host kann eine ganze Management-Plane offenlegen
Konfigurationsarchive sind attraktive Ziele, weil sie Zugriff und Aufschluss vereinen. Der Sammler kennt Gerätenamen, Adressen, Typen und Zugangsdaten. Dateien legen Schnittstellen, Routing-Beziehungen, Access-Listen, Community-Strings, Hashes, Schlüssel und Kommentare offen. Eine Kompromittierung kann Reconnaissance beschleunigen und einen Weg zu aktiver Kontrolle liefern.
Der Host sollte daher in einer eingeschränkten Managementumgebung mit minimalen Diensten stehen. Administratoren sollten Sammelkonten von schreibberechtigten operativen Konten trennen, wo Plattformen es erlauben. Repository-Leser sollten nicht automatisch Zugangsdaten für die Geräteanmeldung erhalten. Backups und Spiegel sollten verschlüsselt und zugriffskontrolliert sein.
Geheimnisse verdienen besondere Aufmerksamkeit. Maskierung in gesammelter Ausgabe ist nützlich, kann aber nicht als vollständig über jedes Herstellermodul angenommen werden. Neue Befehlsausgabe kann Felder einführen, die der Filter nicht kennt. Lokale Anpassungen können Upstream-Schutzmechanismen umgehen. Automatisiertes Geheimnis-Scanning kann helfen, kann aber auch falsche Positive erzeugen und ersetzt kein Design-Review.
Zugangsdateien wie.cloginrcstützen sich stark auf Dateisystemschutz. Lokale Benutzer, Backup-Agenten und Support-Werkzeuge können unbeabsichtigten Zugang erhalten. Zugangsdaten in ein dediziertes Secret-Management-System zu verlagern kann die Kontrolle verbessern, sofern die Integration zuverlässig bleibt. Welcher Mechanismus auch gewählt wird: Die Organisation braucht Rotation, Besitz und Nachweis der Verwendung.
Netzwerksicherheit kann mit Kompatibilität kollidieren. Alte Geräte unterstützen möglicherweise nur schwache SSH-Algorithmen oder Telnet. Diese Protokolle auf einem allgemeinen Sammler zu aktivieren erweitert das Risiko. Isolierte Kompatibilitätshosts, Jump-Systeme oder beschleunigter Gerätetausch können sicherer sein, als eine zentrale Plattform zu schwächen. Der Geschäftswert historischer Evidenz sollte gegen die Kosten der Erhaltung unsicherer Managementpfade abgewogen werden.
Repository-Integrität und Verfügbarkeit gehören ebenfalls in das Bedrohungsmodell. Ransomware oder zerstörerische Administration kann die für die Wiederherstellung nötige Historie auslöschen. Eine Offline- oder unveränderliche Kopie kann Evidenz schützen. Audit-Logs sollten Zugriff und ungewöhnliche Repository-Operationen aufzeichnen. Die eigene Konfiguration des Sammlers sollte versioniert und getrennt von den gesammelten Gerätedaten gesichert werden.
RANCIDs Einfachheit kann es leichter zu sichern machen als eine große Management-Suite, aber Einfachheit ist nicht Isolation. Sein schmaler Dienst sitzt an einer privilegierten Schnittstelle. Ihn wie einen gewöhnlichen Utility-Server zu behandeln ignoriert den Wert, der in ihm konzentriert ist.
LibreNMS liefert das Symptom; RANCID liefert den Konfigurationskontext
LibreNMS und RANCID treten oft gemeinsam auf, weil sie komplementäre Fragen beantworten. LibreNMS fragt Zähler, Zustand und Sensoren über Zeit ab. RANCID sammelt Konfigurationstext und zeichnet Unterschiede auf. Eine Monitoring-Warnung kann identifizieren, wann Erreichbarkeit, Fehler oder Traffic sich änderten; das Konfigurationsrepository kann zeigen, ob sich der Gerätetext in der Nähe änderte.
Die Integration verschmilzt die Evidenz nicht zu einer Wahrheit. Die Abfrageintervalle unterscheiden sich. Eine LibreNMS-Warnung kann einer RANCID-Sammlung vorausgehen. RANCID kann sich nicht anmelden können, während SNMP weiter funktioniert, oder umgekehrt. Eine Konfigurationsänderung kann legitim und mit dem Symptom unverbunden sein. Korrelation verengt die Untersuchung; sie beweist keine Kausalität.
Das gemeinsame Geräteinventar kann auch abdriften. Ein Gerät kann in LibreNMS existieren, aber nicht inrouter.db. Namen und Adressen können abweichen. Zugangsdaten und Berechtigungen können getrennt gepflegt werden. Eine Integration sollte fehlende oder verstaute Konfiguration melden, statt stillschweigend die letzte Datei anzuzeigen.
Sicherheitsgrenzen brauchen Sorgfalt. Konfiguration über eine Monitoring-Oberfläche zu zeigen kann sensiblen Text Benutzern offenlegen, die zuvor nur Grafikzugang hatten. Rollendesign sollte betriebliche Sichtbarkeit von Konfigurationszugriff unterscheiden. Links zu einem Repository können sicherer sein als jede Datei in eine andere Datenbank zu kopieren – je nach Zugriffsmodell.
Der kombinierte Workflow ist nach einer Änderung am stärksten. Eine Schnittstelle geht down; LibreNMS zeichnet das Ereignis und die Historie auf; RANCID zeigt eine veränderte Konfiguration; ein Source-of-Truth-System zeigt, was beabsichtigt war; eine Change-Plattform zeigt Freigabe und Akteur. Kein einzelnes Werkzeug liefert alle vier Nachweise.
Dieses Schichtmodell veranschaulicht, warum spezialisierte Open-Source-Werkzeuge bestehen bleiben. Eine breite Plattform kann Daten integrieren, aber ein unabhängiger Sammler kann Evidenz bewahren, wenn der eigene Change-Workflow der Plattform umgangen wird. RANCIDs Wert neben LibreNMS kommt daher, dass es ein eigener Beobachtungspfad bleibt.
GitOps und Source-of-Truth-Systeme lösen Intent; RANCID zeichnet die Antwort des Geräts auf
Moderne Netzwerkautomatisierung speichert beabsichtigte Konfiguration in der Versionskontrolle, modelliert Inventar und Richtlinien in Systemen wie NetBox oder Nautobot und nutzt Werkzeuge wie Ansible oder NAPALM, um Änderungen zu rendern, zu validieren und bereitzustellen. In dieser Welt kann RANCID redundant erscheinen. Wenn Git die Konfiguration bereits enthält, warum sie wieder vom Gerät sammeln?
Weil beabsichtigter und beobachteter Zustand auseinanderlaufen können. Ein Notfallbefehl kann die Automatisierung umgehen. Eine teilweise Bereitstellung kann auf einem Gerät scheitern. Ein Hersteller kann Konfiguration anders normalisieren oder generieren. Ein Mensch kann während der Fehlersuche eine Änderung vornehmen und vergessen, sie abzugleichen. Das Quell-Repository kann makellos bleiben, während das Netzwerk es nicht ist.
RANCID bietet einen unabhängigen Rückpfad. Es fragt das Gerät, was es jetzt meldet, und zeichnet die Antwort auf. Der Vergleich dieser Antwort mit gerendertem Intent kann Drift identifizieren. Der Prozess kann Schwächen in Automatisierung, Inventar oder Änderungskontrolle aufdecken, statt das Gerät bloß als nicht konform zu markieren.
Der Snapshot hat weiterhin keine Semantik. Textvergleich kann harmlose Sortierung oder generierte Werte anmarkern. Er kann eine Verhaltensdifferenz verfehlen, die außerhalb der gesammelten Befehle ausgedrückt wird. Strukturierte APIs und modellgetriebene Daten können den Vergleich verbessern, wo sie unterstützt werden. RANCID bleibt in heterogenen Umgebungen nützlich, gerade weil es Text akzeptiert, wenn Struktur nicht verfügbar ist.
GitOps trägt auch eigene Autoritätsfragen. Ein Git-Commit zeichnet beabsichtigte Änderung auf, aber das Produktionsverhalten hängt von Pipelines, Zugangsdaten, Geräteantworten und menschlichen Overrides ab. RANCIDs Repository zeichnet eine weitere Stufe in dieser Kette auf. Die beiden Historien sollten nicht zusammenfallen oder einander überschreiben.
Ein ausgereifter Workflow kann RANCID als detektive Kontrolle behandeln. Genehmigte Änderungen fließen vom Intent zu den Geräten. Gesammelte Konfigurationen fließen zurück und werden verglichen. Unerwartete Differenzen lösen ein Review aus. Der Sammler wird nicht zur Bereitstellungs-Engine, was die Unabhängigkeit bewahrt.
Der strategische Punkt ist, dass Automatisierung den Bedarf an Evidenz erhöht statt ihn zu beseitigen. Je schneller sich Änderungen bewegen, desto wichtiger wird zu wissen, was tatsächlich jedes Gerät erreichte. RANCIDs altes Text-Diff-Modell kann diese Rolle weiter erfüllen, wenn seine Grenzen verstanden sind.
Oxidized und kommerzielle Manager modernisieren den Workflow, ohne das ursprüngliche Problem auszulöschen
Oxidized ist eine prominente Open-Source-Alternative, die ebenfalls Netzwerkgerätekonfigurationen über modellspezifische Logik sammelt und Versionen, üblicherweise in Git, speichert. Seine Architektur und Integrationen können sich für moderne Umgebungen anders eignen, und viele Betreiber nutzen es mit LibreNMS. RANCID bleibt der historische Referenzpunkt der Kategorie.
Kommerzielle Netzwerkkonfigurations-Manager ergänzen Entdeckung, Compliance-Regeln, Freigabe-Workflows, Änderungsautomatisierung, Herstellerunterstützung und Berichterstattung. Sie können Verträge und ein integrierteres Benutzererlebnis bieten. Sie führen auch Lizenzkosten, proprietäre Datenmodelle und Abhängigkeit von der Geräteabdeckung und Roadmap eines Herstellers ein.
Automatisierungs-Frameworks können strukturierten Zustand abrufen oder Änderungen pushen. Controller können beabsichtigte Richtlinien pflegen. Geräteeigene Systeme können Befehlshistorie aufzeichnen. Diese Fähigkeiten überschneiden sich mit Teilen von RANCID, aber sie beseitigen die Kernfrage nicht: Gibt es einen unabhängigen, dauerhaften Datensatz dessen, was das Gerät über Zeit gemeldet hat?
Die Wahl ist nicht binär. Eine Organisation kann einen kommerziellen Manager für Workflows, Git für beabsichtigten Zustand, Streaming-Telemetrie für Laufzeit-Evidenz und RANCID oder Oxidized für unabhängige Snapshots verwenden. Die Architektur sollte unnötige Duplikation von Zugangsdaten vermeiden und festlegen, welcher Nachweis welche Frage beantwortet.
RANCIDs Vorteile sind Reife, Transparenz, bescheidene Ressourceanforderungen und Kompatibilität mit Text und Standardversionskontrolle. Seine Nachteile sind CLI-Sprüdigkeit, manuelles Inventar, begrenzte formale Governance, Sicherheitskonzentration und eine Benutzererfahrung, geprägt von Skripten statt von einem modernen Produkt. Diese Kompromisse sind ehrlich und oft akzeptabel in den Teilen eines Netzwerks, die neuere Plattformen nicht gut abdecken.
Das Fortbestehen des Projekts ist kein Beleg, dass Netzwerkautomatisierung scheiterte. Es ist ein Beleg, dass Automatisierungssysteme weiterhin ein externes Gedächtnis brauchen. Je ausgereifter die Intent-Pipeline wird, desto wertvoller kann eine einfache unabhängige Beobachtung sein, wenn die eigenen Annahmen der Pipeline fraglich sind.
E-Mail-Diffs verwandeln Repository-Änderung in einen menschlichen Workflow
RANCIDs traditionelles Betriebsmodell endet nicht mit einem Commit. Eine Änderung kann eine E-Mail mit dem Diff erzeugen und Konfigurationsevidenz direkt in den Workflow der Netzwerkingenieure platzieren. Der Mechanismus ist einfach genug, um Änderungen in Ticket- und Dashboard-Systemen zu überleben. Er legt auch den Unterschied zwischen Benachrichtigung und Reaktion offen.
Ein nützliches Diff ist knapp, einem Gerät zurechenbar und wird an Menschen geliefert, die seine Konsequenz verstehen. Normalisierung unterstützt dieses Ziel, indem sie routinemäßiges Rauschen entfernt. Gruppierung kann Änderungen an das passende Team leiten. Repository-Links können breiteren Kontext liefern. Eine geplante Änderung kann schnell erkannt werden; eine unerwartete Zeile kann eine Untersuchung auslösen, bevor der nächste Vorfall kommt.
Derselbe Kanal kann durch Volumen unwirksam werden. Große geplante Änderungen erzeugen lange Nachrichten. Flüchtige Felder, die die Filterung entgangen sind, erzeugen wiederkehrendes Rauschen. Ein instabiles Gerät kann bei jedem Zyklus dieselben Variationen senden. Ingenieure erstellen Mail-Regeln, hören auf zu lesen und verpassen schließlich die eine Änderung, die das System aufdecken sollte. Warnmüdigkeit ist nicht auf Monitoring-Plattformen beschränkt; ein Diff-Strom kann dasselbe Versagen erleiden.
Benachrichtigungspolitik braucht daher Gestaltung. Geplante Wartung kann mit erwarteten Änderungen korreliert werden. Sehr große Diffs können mit einem Link zum Repository zusammengefasst werden, während der vollständige Datensatz bewahrt wird. Wiederholte Sammelfehler sollten von Konfigurationsänderungen unterschieden werden. Teams können ungelesene oder unbestätigte Ereignisse messen, statt anzunehmen, dass Zustellung gleich Review ist.
E-Mail schafft auch Datenleckrisiko. Ein Konfigurationsdiff kann interne Adressierung, Kundenreferenzen oder ein Geheimnis enthalten, das die Filterung nicht entfernte. Mailinglisten und Archive können breiteren Zugang haben als das Repository. Weiterleiten kann Evidenz aus der Managementumgebung hinausbewegen. Manche Organisationen werden Ticket- oder Chat-Integrationen mit stärkerer Zugriffskontrolle bevorzugen, doch diese Systeme führen ihre eigenen Token und Aufbewahrungsrichtlinien ein.
Die wichtige Eigenschaft ist nicht die E-Mail selbst. Es ist die Übersetzung eines Repository-Ereignisses in einen verantwortlichen operativen Schritt. Wer soll das Diff prüfen? Wie schnell? Was macht eine Änderung autorisiert? Wo wird die Entscheidung festgehalten? RANCID liefert einen Auslöser; die Organisation muss ihn in eine Kontrolle verwandeln.
Ein ausgereifter Workflow erkennt auch, dass keine Nachricht ein Beweis für Gesundheit ist. Wenn der Sammler oder das Mailsystem versagt, kann Stille wie Stabilität aussehen. Synthetische Änderungen, Testbenachrichtigungen und Frische-Dashboards können den vollständigen Pfad vom Gerät zum Menschen verifizieren. Das Ein-Zeilen-Diff zählt nur, wenn jemand darauf vertrauen kann, dass wichtige Zeilen ankommen würden.
Die Looking-Glass-Funktion zeigt, warum Lesezugriff trotzdem Grenzen braucht
RANCID hat historisch eine Looking-Glass-Fähigkeit enthalten, die ausgewählten Benutzern erlaubt, begrenzte Diagnosebefehle über eine Weboberfläche auszuführen. Die Idee ist betrieblich attraktiv: Support-Mitarbeiter oder externe Nutzer können Routen und Erreichbarkeit inspizieren, ohne uneingeschränkten Gerätezugriff zu erhalten. Die Funktion verwandelt bestehende Anmeldeautomatisierung in einen kontrollierten Diagnosedienst.
Die Sicherheitsgrenze ist heikel. Ein Befehl, der nur lesend erscheint, kann Routing-Tabellen, Nachbarn, Schnittstellen, Adressen und Richtlinien offenlegen. Benutzereingaben müssen eingeschränkt werden, damit sie nicht in beliebige CLI-Ausführung entweichen können. Die Webanwendung, die Befehls-Whitelist, die Gerätezugangsdaten und die Ausgabeverarbeitung werden zu einer Vertrauenskette. Ein Fehler an irgendeinem Punkt kann eine diagnostische Annehmlichkeit in Zugang zur Management-Plane verwandeln.
Selbst korrekt eingeschränkte Ausgabe kann sensibel sein. Eine öffentliche Routenansicht ist etwas anderes als interne Topologie oder kundenspezifische Informationen. Betreiber müssen entscheiden, welche Geräte und Befehle zu welcher Zielgruppe gehören. Ratenbegrenzungen und Logging können Missbrauch reduzieren. Trennung vom primären Sammler kann die Folgen einer Web-Kompromittierung begrenzen.
Das Looking Glass veranschaulicht auch einen breiteren Punkt zu RANCID: Sammelzugangsdaten können Dienste jenseits der Archivierung unterstützen, was Nutzen und Risiko gleichermaßen erhöht. Denselben privilegierten Pfad für zu viele Funktionen zu nutzen macht den Sammler zu einem größeren Ziel. Ein schmales Dienstkonto und ein separates Diagnosekonto können sicherer sein, selbst wenn sie mehr Administration erzeugen.
Moderne Route-Server und Observability-Plattformen können ähnliche Ansichten über APIs und eigens gebaute Schnittstellen liefern. Das macht die historische Funktion nicht irrelevant; es klärt die Designfrage. Lesezugriff ist eine Befugnis, die abgegrenzt, überwacht und begründet werden sollte. Das Fehlen von Konfigurationsbefehlen macht die Information nicht harmlos.
Ein Profil von RANCID sollte das Looking Glass nicht als Hauptidentität des Projekts behandeln, aber es hilft, die Betriebskultur des Projekts zu erklären. Das System wuchs aus pragmatischen Netzbetrieben, in denen Ingenieure Wege brauchten, Gerätezustand mit den verfügbaren Schnittstellen zu inspizieren und zu bewahren. Jede Annehmlichkeit trug eine Managementgrenze, die lokale Betreiber durchsetzen mussten.
Nachhaltigkeit ruht auf einem kleinen kanonischen Projekt und vielen unsichtbaren Bereitstellungen
RANCID ist Open-Source-Software und kein herkömmliches Unternehmen mit offengelegtem Umsatz, Beschäftigten und Kundensupport-Organisation. Das kanonische Projekt wird durch Shrubbery Networks und Beitragende gepflegt. Der öffentliche Datensatz bietet keine vollständige aktuelle Maintainer-Übersicht, kein Budget und keinen Nachfolgeplan.
Diese Form erzeugt sowohl Belastbarkeit als auch Sprödigkeit. Der Code kann heruntergeladen, inspiziert, modifiziert und ohne Lizenzverlängerung am Laufen gehalten werden. Betreiber können lokale Module weiter pflegen, nachdem ein Hersteller oder Berater das Interesse an einem Gerät verloren hat. Das Projekt ist nicht einem einzelnen unternehmerischen Beschluss ausgesetzt, ein Abo-Produkt einzustellen.
Gleichzeitig schafft offene Verfügbarkeit keine Review-Kapazität. Gerätemodule brauchen Aktualisierungen. Sicherheitsprobleme erfordern Diagnose und Releases. Dokumentation und Build-Systeme altern. Ein paar Menschen können Wissen tragen, auf das Tausende Installationen angewiesen sind, ohne dass diese Installationen sichtbar sind oder Ressourcen nach Upstream beitragen.
Downstream-Paketing kann helfen, indem es RANCID an Betriebssysteme anpasst und Korrekturen verteilt. Es kann auch Verzögerung oder Divergenz erzeugen. Eine Paketversion kann dem kanonischen Release hinterherhinken. Lokale Patches kehren möglicherweise nie nach Upstream zurück. Eine Organisation kann glauben, „RANCID zu verwenden“, während sie einen Zweig mit wesentlich anderem Verhalten betreibt.
Die Ökonomie liegt überwiegend außerhalb des Projekts. Nutzer zahlen für Sammlerhosts, Speicher, Backups und Ingenieurszeit. Berater können Einnahmen aus Bereitstellung oder Support erzielen. Das Projekt schafft Wert durch schnellere Untersuchung und bewahrte Konfiguration, aber dieser Wert erscheint nicht als geprüfte Projekteinnahme. Eine kleine Wartungslast kann große Downstream-Assets stützen, ohne einen passenden Finanzierungsmechanismus.
Nachhaltigkeit sollte daher durch Releases, Sicherheitsreaktion, Beitragsaktivität, Dokumentation und die Gesundheit der kanonischen Distribution überwacht werden. Große Nutzer können Risiko reduzieren, indem sie Korrekturen, Testausgaben, Finanzierung oder Maintainerschaft beitragen, statt das Projekt als statische Utility zu behandeln. Sie sollten auch einen Ausstiegsplan pflegen: Das Repository-Format ist portabel, aber lokale Sammellogik und Zugangsdaten sind es möglicherweise nicht.
Das Fehlen einer formalen Stiftung oder eines dominanten Herstellers ist nicht notwendigerweise ein Mangel. Es bedeutet, dass kein zentrales Gremium eine Roadmap garantieren kann. Organisationen, die auf RANCID angewiesen sind, müssen entscheiden, wie viel Verantwortung sie internalisieren und welche externen Beziehungen verlässlich genug sind, es zu stützen.
Migration sollte Evidenz bewahren, nicht bloß den Sammler ersetzen
Wenn Organisationen von RANCID zu Oxidized, einem kommerziellen Manager oder einer Controller-Plattform wechseln, liegt die naheliegende Aufgabe darin, aktuelle Konfigurationen im neuen System zu sammeln. Die schwerere Aufgabe ist die Bewahrung der Bedeutung des historischen Archivs. Jahre von Diffs können während Audit, Rechtsstreit, Vorfallreview oder Rekonstruktion wertvoll sein, warum ein altes Design existiert.
Ein Migrationsplan sollte Repository-Historie, Zeitstempel, Geräteidentität und Zugriffskontrollen bewahren. Wenn sich Dateinamen oder Hostnamen ändern, braucht es eine Zuordnung, damit alte und neue Datensätze vergleichbar bleiben. Die Geheimnisaufbewahrungs-Politik sollte geprüft werden, bevor Historie in eine neue Plattform kopiert wird. Daten, die in einem lokalen Git-Repository geschützt waren, können nach dem Import in eine Webanwendung breiter sichtbar werden.
Sammelparität braucht ebenfalls Tests. Das neue Werkzeug kann andere Befehle ausführen oder die Ausgabe anders normalisieren. Eine saubere Migration kann erscheinen, jede Zeile zu ändern, weil sich die Formatierung änderte. Umgekehrt kann ein vermeintlich äquivalentes Modell Befehle auslassen, die RANCID sammelte. Parallele Läufe liefern Evidenz über Abdeckung, Frische und Fehlerverhalten, bevor der alte Sammler stillgelegt wird.
Zugangsdaten sollten nicht automatisch kopiert werden. Die Migration ist eine Gelegenheit, Privilegien zu reduzieren, geteilte Geheimnisse zu ersetzen, stärkere SSH-Algorithmen zu übernehmen und Geräte zu segmentieren. Legacy-Ausrüstung, die die neue Richtlinie nicht erfüllen kann, kann einen isolierten Sammler oder einen beschleunigten Stilllegungsplan erfordern.
Das alte Repository sollte nicht auf unbestimmte Zeit ohne Besitzer online bleiben. Wird es aufbewahrt, braucht es Backups, Sicherheitsaktualisierungen und Zugriffsreview. Wird es archiviert, muss die Organisation wissen, wie es zu lesen und zu verifizieren ist. Ein komprimiertes Verzeichnis, das niemand interpretieren kann, ist keine bewahrte Evidenz.
Diese Migrationsdisziplin verstärkt RANCIDs größere Lehre. Das dauerhafte Asset ist nicht das Skript oder die Schnittstelle allein. Es ist eine vertrauenswürdige Folge von Beobachtungen und das Wissen, wie diese Beobachtungen erzeugt wurden. Den Sammler zu ersetzen und dabei Provenienz zu verwerfen, kann ein modernes System weniger nützlich machen als das ältere, das es verdrängte.
RANCIDs Verwendung von gewöhnlichem Text und Versionskontrolle hilft, weil die Daten nicht an eine proprietäre Datenbank gebunden sind. Portabilität ist jedoch nur Potenzial. Sie wird real, wenn die Organisation Module, Filter, Zeitpläne, Gerätezuordnungen und die Grenzen des Datensatzes dokumentiert.
Konfigurationstext ist nicht dasselbe wie Netzwerkverhalten
Ein Router kann eine Konfiguration haben, die korrekt aussieht, und sich dennoch unerwartet verhalten. Routen hängen von Nachbarzustand, empfangenen Ankündigungen, Timern, Hardware-Ressourcen, Softwarefehlern und anderswo angewendeten Richtlinien ab. Eine Access-Liste kann als Text existieren, aber an der falschen Schnittstelle hängen. Eine Route-Map kann isoliert korrekt sein, während sie auf Daten passt, die sich außerhalb des Geräts änderten. RANCID bewahrt eine wichtige Schicht, nicht das vollständige Weiterleitungssystem.
Diese Grenze zählt während der Diagnose. Ein Diff nahe am Vorfall ist Evidenz, die es zu untersuchen lohnt, aber zeitliche Nähe beweist keine Ursache. Ingenieure sollten den Betriebszustand vergleichen: Routing-Tabellen, Adjazenzstatus, Schnittstellenzähler, Logs und Telemetrie. Sie sollten fragen, ob der geänderte Befehl aktiv war, ob er sich verbreitete und ob ein anderes System dasselbe Symptom erzeugte.
Der umgekehrte Fall tritt ebenfalls auf. Verhalten kann sich ohne ein Konfigurationsdiff ändern. Ein Link fällt aus. Ein Nachbar kündigt eine andere Route an. Ein Zertifikat läuft ab. Eine Hardware-Tabelle füllt sich. Ein Prozess startet neu und wählt einen neuen Pfad aus unveränderter Richtlinie. Ein Monitoring- oder Telemetriesystem ist nötig, um diese Ereignisse zu sehen. RANCID sollte nicht dafür gerügt werden, dass es Zustand nicht aufzeichnet, für den es nicht entworfen wurde.
Manche Herstellermodule enthalten operative Befehle zusätzlich zur Konfiguration, was helfen kann. Diese Wahl sollte dokumentiert werden, weil sie Bedeutung und Rauschprofil des Archivs verändert. Ein Routentabellen-Snapshot kann groß und flüchtig sein. Ihn periodisch zu speichern kann Vergleiche unterstützen, während er Platz verbraucht und Diffs erzeugt, die Konfigurationsänderungen verdecken.
Strukturierte Zustandsmodelle können das Schließen von Schlüssen verbessern, aber sie erfordern auch Herstellerunterstützung und sorgfältige Semantik. Text bleibt nützlich, weil er nahe an dem ist, was Ingenieure sehen, und mit gewöhnlichen Werkzeugen inspiziert werden kann. Die stärkste Architektur nutzt beides, wo möglich: strukturierte Telemetrie für aktuelles Verhalten, Konfigurations-Snapshots für die vom Gerät gemeldete Richtlinie und Intent-Systeme für genehmigtes Design.
Diese Trennung schützt vor einem häufigen analytischen Fehler. Ein Konfigurationsarchiv beweist Compliance nicht bloß, weil Dateien existieren, und ein lebendes Netzwerk beweist Konfigurationsqualität nicht bloß, weil Traffic fließt. Evidenz aus verschiedenen Schichten muss verglichen werden. RANCID verdient seinen Platz, indem es eine Schicht dauerhaft genug macht, um an diesem Vergleich teilzunehmen.
Auditwert hängt von Provenienz, Aufbewahrung und der Fähigkeit ab, den Sammler zu erklären
Konfigurationshistorie kann interne Kontrolle, externe Audits und Vorfallreview unterstützen, aber ein Repository ist nicht automatisch ein Audit-System. Prüfer und Ermittler müssen wissen, welche Geräte im Geltungsbereich waren, wie oft sie gesammelt wurden, welche Befehle ausgeführt wurden, welche Felder gefiltert wurden und wie der Zugang zum Archiv kontrolliert wurde.
Provenienz beginnt mit der Sammlerkonfiguration.router.db, Gruppendefinitionen, Login-Regeln und Herstellermodule bestimmen die Evidenz. Diese Dateien sollten versioniert und geprüft werden. Eine Änderung an einem Filter kann jeden künftigen Snapshot verändern. Eine Änderung am Zeitplan kann Beobachtungslücken vergrößern. Eine Änderung der Zugangsdaten kann stillschweigend einen Teil der Flotte entfernen.
Zeit ist eine weitere Abhängigkeit. Repository-Zeitstempel, Geräteuhren, Ticket-Datensätze und Identitätslogs müssen gut genug ausgerichtet sein, um eine Sequenz zu rekonstruieren. Die Commit-Zeit ist nicht notwendigerweise die Zeit der Netzwerkänderung. Ermittler sollten diese Unterscheidung bewahren, statt falsche Präzision zu erzeugen.
Aufbewahrung braucht eine explizite Regel. Jede Konfiguration für immer zu behalten kann veraltete Geheimnisse und persönliche oder Kundeninformationen offenlegen. Historie zu aggressiv zu löschen kann den einzigen Datensatz entfernen, der nötig ist, um eine langjährige Routenrichtlinie zu erklären. Verschiedene Klassen von Geräten oder Daten können verschiedene Zeiträume erfordern. Rechtliche und regulatorische Pflichten variieren nach Organisation und Rechtsraum.
Integritätskontrollen können den Datensatz stärken. Remote-Spiegel, eingeschränkte Append-only-Backups, signierte Commits oder externe Zeitstempel können unbefugte Veränderung erschweren. Nichts davon nützt, wenn Schlüssel, Spiegel und Sammler einen einzigen kompromittierten Administrator oder ein Speichersystem teilen. Unabhängigkeit sollte der bekämpften Bedrohung entsprechen.
Ein Audit braucht auch negative Evidenz. Die Organisation sollte fehlgeschlagene Sammlungen, fehlende Geräte und Zeiträume berichten, in denen das Archiv nicht vertrauenswürdig war. Diese Lücken zu verbergen verwandelt einen Teildatensatz in einen irreführenden. Eine saubere Commit-Kette kann ein Gerät nicht abdecken, das der Sammler nicht erreichen konnte.
Die zentrale Frage ist, ob eine andere qualifizierte Person nach dem Weggang des ursprünglichen Administrators die Bedeutung des Datensatzes reproduzieren kann. Sind Module, Filter und Zeitpläne undokumentiert, kann das Repository Text behalten und Interpretation verlieren. RANCIDs Einfachheit hilft, aber Governance verwandelt Einfachheit in verlässliche Evidenz.
Legacy-Geräte machen schmale Kompatibilität zu einem dauerhaften Infrastrukturbedarf
Netzwerkhardware bleibt oft länger im Dienst als die Managementmode, unter der sie gekauft wurde. Ein Switch kann zuverlässig weiterleiten, nachdem sein Hersteller zu einem anderen Controller, Lizenzmodell oder einer anderen API übergegangen ist. Ersatz kann Kapital, Ausfallfenster und Änderungen an Downstream-Systemen erfordern. Betreiber pflegen daher gemischte Flotten, in denen neue Geräte strukturierte Telemetrie unterstützen, während ältere Ausrüstung nur eine Kommandozeile und SNMP bietet.
RANCID passt zu dieser Realität, weil seine Kernanforderung bescheiden ist: eine erreichbare Managementsitzung und ein Modul, das nützlichen Text abrufen kann. Es kann Historie für Geräte bewahren, die von neueren Plattformen keine Aufmerksamkeit mehr erhalten. Diese Fähigkeit ist wertvoll in Campussen, Versorgungsbetrieben, Service-Provider-Edges und anderen Umgebungen, in denen Infrastruktur ungleich altert.
Der Vorteil sollte nicht zum Vorwand für unbegrenzte technische Schulden werden. Legacy-Zugriff kann veraltete Chiffren, geteilte Passwörter oder Telnet erfordern. Herstellersoftware kann ungepatchte Schwachstellen enthalten. Ersatzteile und Dokumentation verschwinden. Ein Sammler kann das Gerät managbar genug machen, um die Stilllegung zu verzögern, und zugleich Evidenz aufzeichnen, die eine sicherere Migration stützt.
Organisationen sollten Kompatibilitätsausnahmen klassifizieren. Ein Legacy-Gerät kann hinter einem dedizierten Sammler und Managementpfad isoliert werden. Zugangsdaten können beschränkt werden. Das Repository kann zeigen, ob sich seine Konfiguration überhaupt ändert. Ersatzpriorität kann Exposition und geschäftliche Wichtigkeit widerspiegeln, nicht bloß Alter.
Dieser Ansatz trennt Bewahrung von Billigung. RANCIDs Fähigkeit, eine alte Plattform zu sammeln, bedeutet nicht, dass die Plattform sicher oder strategisch erstrebenswert bleibt. Es bedeutet, dass die Organisation Sichtbarkeit behalten kann, während sie entscheidet, wie und wann sie sie entfernt.
Die globale Reichweite von RANCID ist daher unmöglich durch eine einzelne Dienstkarte zu messen. Die Software läuft in unabhängig kontrollierten Netzwerken, oft gerade weil diese Netzwerke Ausrüstung enthalten, die nicht an eine zentrale verwaltete Plattform übergeben werden kann. Ihre Reichweite ist in lokalen Repositories, Paketinstallationen und Skripten kodiert, die Upstream möglicherweise nie sieht.
Diese Unsichtbarkeit erschwert Nachhaltigkeit, aber sie bekräftigt den Zweck des Projekts. Netzwerkinfrastruktur ist voll von Assets, deren betriebliches Leben das kommerzielle Leben ihrer Managementwerkzeuge übersteigt. Ein einfacher Sammler kann diese Lücke überbrücken, sofern er als temporäre Kontrolle um bekannte Grenzen herum genutzt wird, nicht als Erlaubnis, sie zu vergessen.
Ein schmales Werkzeug kann mehrere Managementmoden überleben
RANCIDs kanonische Projektheimat ist Shrubbery Networks, und die aktuelle Website zum Recherche-Stichtag listete Version 3.14, wobei das öffentliche Release-Archiv die 3.14-Linie auf 2025 datierte. Spiegel und Downstream-Pakete existieren, aber die kanonische Website sollte für Release- und Governance-Aussagen verwendet werden, sofern das Projekt nichts anderes angibt.
Das Projekt veröffentlicht keinen geprüften Installationszähler, kein Budget, keine vollständige Maintainer-Übersicht und keine universelle Geräteunterstützungsmatrix. Seine Größe ist daher schwer zu messen. Langlebigkeit und Paketverfügbarkeit zeigen fortbestehende Relevanz, begründen aber keinen Marktanteil. Viele Bereitstellungen können alt, lokal modifiziert oder für Upstream-Maintainer unsichtbar sein.
Diese Opazität ist bei kleinen Infrastrukturprojekten verbreitet. Die Software kann tief verankert sein, ohne einen klaren kommerziellen Datensatz zu erzeugen. Maintainer-Arbeit kann freiwillig, arbeitgeberfinanziert oder über Beratung gestützt sein. Nutzer profitieren von vermiedener Vorfallzeit und bewahrter Evidenz, aber dieser Wert erfasst sich nicht in Projekteinnahmen.
Nachhaltigkeit hängt von Nachfolge und Kompatibilitätsarbeit ab. Neue Gerätesoftware ändert Prompts und Ausgabe. Alte Geräte brauchen Legacy-Unterstützung. Sicherheitserwartungen wandern. Versionskontrollsysteme und Betriebssystemabhängigkeiten entwickeln sich. Ein schmales Werkzeug kann stabil bleiben, aber Stabilität erfordert dennoch Review- und Release-Arbeit.
RANCIDs Umfang schützt es vor manchem Marktdruck. Es muss nicht zu einer vollständigen Observability-Plattform werden. Es kann Text weiter sammeln, solange Geräte Text offenlegen, der sammelnswert ist. Das Risiko ist, dass das Projekt leicht ignoriert wird, bis ein Sicherheits- oder Kompatibilitätsproblem erscheint.
Der stärkste Grund für fortgesetzte Nutzung ist nicht Nostalgie. Es ist das Vorhandensein von Netzwerken, die heterogen, langlebig und unvollständig automatisiert sind. Diese Bedingungen werden nicht schnell verschwinden. Ein Werkzeug, das über sie hinweg Evidenz aufzeichnet, kann nützlich bleiben, selbst wenn seine Oberfläche alt wirkt.
Ein Text-Diff zählt, weil es begrenzte, inspizierbare Evidenz ist
RANCIDs zentrale Idee hat überlebt, weil Konfigurationstext dem betrieblichen Mechanismus vieler Netzwerke nahe bleibt. Ein Diff kann von einem Ingenieur gelesen, mit Standardwerkzeugen durchsucht und ohne proprietäre Datenbank aufbewahrt werden. Die Evidenz ist portabel und verständlich, nachdem sich die ursprüngliche Monitoring-Plattform geändert hat.
Ihre Grenzen sollten mit gleicher Kraft benannt werden. Das Archiv ist periodisch, nicht kontinuierlich. Es zeichnet ausgewählte Befehle auf, nicht das gesamte Gerät. Normalisierung kann Kontext entfernen. Ein Commit identifiziert Sammlung, nicht den menschlichen Akteur. Zugangsdaten und Repositories erzeugen ein Management-Plane-Risiko. Eine Datei ist kein Sollzustand, und sie blind wiederherzustellen kann unsicher sein.
Diese Grenzen halten das Werkzeug ehrlich. RANCID muss nicht behaupten, dass Snapshots ausführbarer Intent sind. Es kann GitOps ergänzen, weil es die Antwort des Geräts nach der Automatisierung aufzeichnet. Es kann LibreNMS ergänzen, weil es Symptomen Konfigurationskontext hinzufügt. Es kann kommerzielle Manager ergänzen, weil es ein unabhängiges Repository bewahrt.
Der beobachtbare Test ist, ob das Archiv eine reale Untersuchung verbessert. Kann das Team die letzte erfolgreiche Sammlung identifizieren, die relevanten Zeilen vergleichen, die Änderung zu einem anderen Datensatz zurückverfolgen und sich ohne Freigabe von Zugangsdaten oder Pushen von verstaustem Text wiederherstellen? Kann es beweisen, dass das Repository selbst nicht verändert wurde? Kann es erkennen, wenn das Fehlen eines Diffs durch Sammelfehler verursacht ist?
Sind diese Antworten ja, ist RANCID mehr als ein Legacy-Skript. Es ist ein kleines Evidenzsystem, das in den Netzbetrieb eingebettet ist. Sind sie nein, kann Versionskontrolle eine überzeugende Historie des Falschen liefern.
RANCIDs dauerhafte Lehre ist, dass Kontrolle und Evidenz nicht als dasselbe angenommen werden sollten. Ein Controller sagt, was geschehen soll. Ein Gerät meldet, was es als konfiguriert glaubt. Ein Monitoring-System zeigt, was ausgewählte Signale taten. Ein Text-Diff bewahrt einen Teil dieser Diskrepanz. Netzwerke werden leichter zu steuern, wenn diese Datensätze verglichen werden können, statt zu einer einzigen Geschichte gezwungen zu werden.
Die abschließende Disziplin ist, Unsicherheit im Datensatz zu bewahren. Ein sauberes Diff kann feststellen, dass ausgewählter Text zwischen erfolgreichen Sammlungen sich änderte. Es kann nicht die vollständige Befehlssequenz, die Absicht des Operators oder den kausalen Pfad zu einem Ausfall feststellen. Diese Schlüsse erfordern andere Logs, Interviews und Tests. RANCID ist am glaubwürdigsten, wenn Nutzer es nicht bitten, mehr zu beweisen, als es gesammelt hat.
Diese Zurückhaltung ist auch der Grund, warum das System nach Jahrzehnten noch lesbar bleibt. Seine Dateien können ohne proprietären Client geöffnet, seine Historie gespiegelt und seine Module betrachtet werden. Die Architektur macht Evidenz nicht neutral – Filter, Zeitpläne und Zugriff formen sie weiterhin –, aber sie lässt diese Entscheidungen nahe genug an der Oberfläche, damit ein Betreiber sie anfechten kann. In einem Infrastrukturmarkt, der zu immer größeren Managementplattformen hin geneigt ist, ist diese Inspektierbarkeit eine materielle Form von Kontrolle.
Sie liefert auch einen Ausstiegspfad. Wenn das Projekt, das Paket oder die bevorzugte Integration sich ändert, kann die Organisation gewöhnlichen Text und Versionshistorie behalten, sofern sie dokumentiert hat, wie die Daten gesammelt wurden. Diese Portabilität beseitigt Migrationsarbeit nicht, aber sie verhindert, dass die Evidenz mit einem Herstellerkonto oder einem Datenbankschema verschwindet. Für langlebige Netzwerke kann die Fähigkeit, den gestrigen Datensatz in das Werkzeug von morgen zu übertragen, so wertvoll sein wie jedes neue Automatisierungsfeature.
Das Archiv wird dann zu institutionellem Gedächtnis statt zu einem Anhang eines Sammlers. Sein Wert hängt von fortgesetztem Zugang, interpretierbarer Provenienz und Menschen ab, die wissen, wo seine Grenzen beginnen. Dies sind Governance-Entscheidungen, keine Software-Defaults, und sie müssen getestet werden, bevor ein Notfall das Netzwerk in der Praxis erreicht.
Mitgliederbriefing
Das vollständige Trend-Briefing lesen
Mitglieder lesen das vollständige Briefing mit den Quellennotizen hinter jeder Erkenntnis.
Strategischer Kreis
Ein tägliches Briefing in Ihrer Sprache, zusammengestellt aus Veränderungen, die wir verifiziert haben.
Für USD 20 pro Monat beitretenJederzeit kündbar.
Für Leadership Alliance bewerben
Mitglieder erhalten außerdem die vollständige Research-Bibliothek, ein tägliches Briefing zu den Netzen, denen sie folgen, und das private Forum.