
Resumo
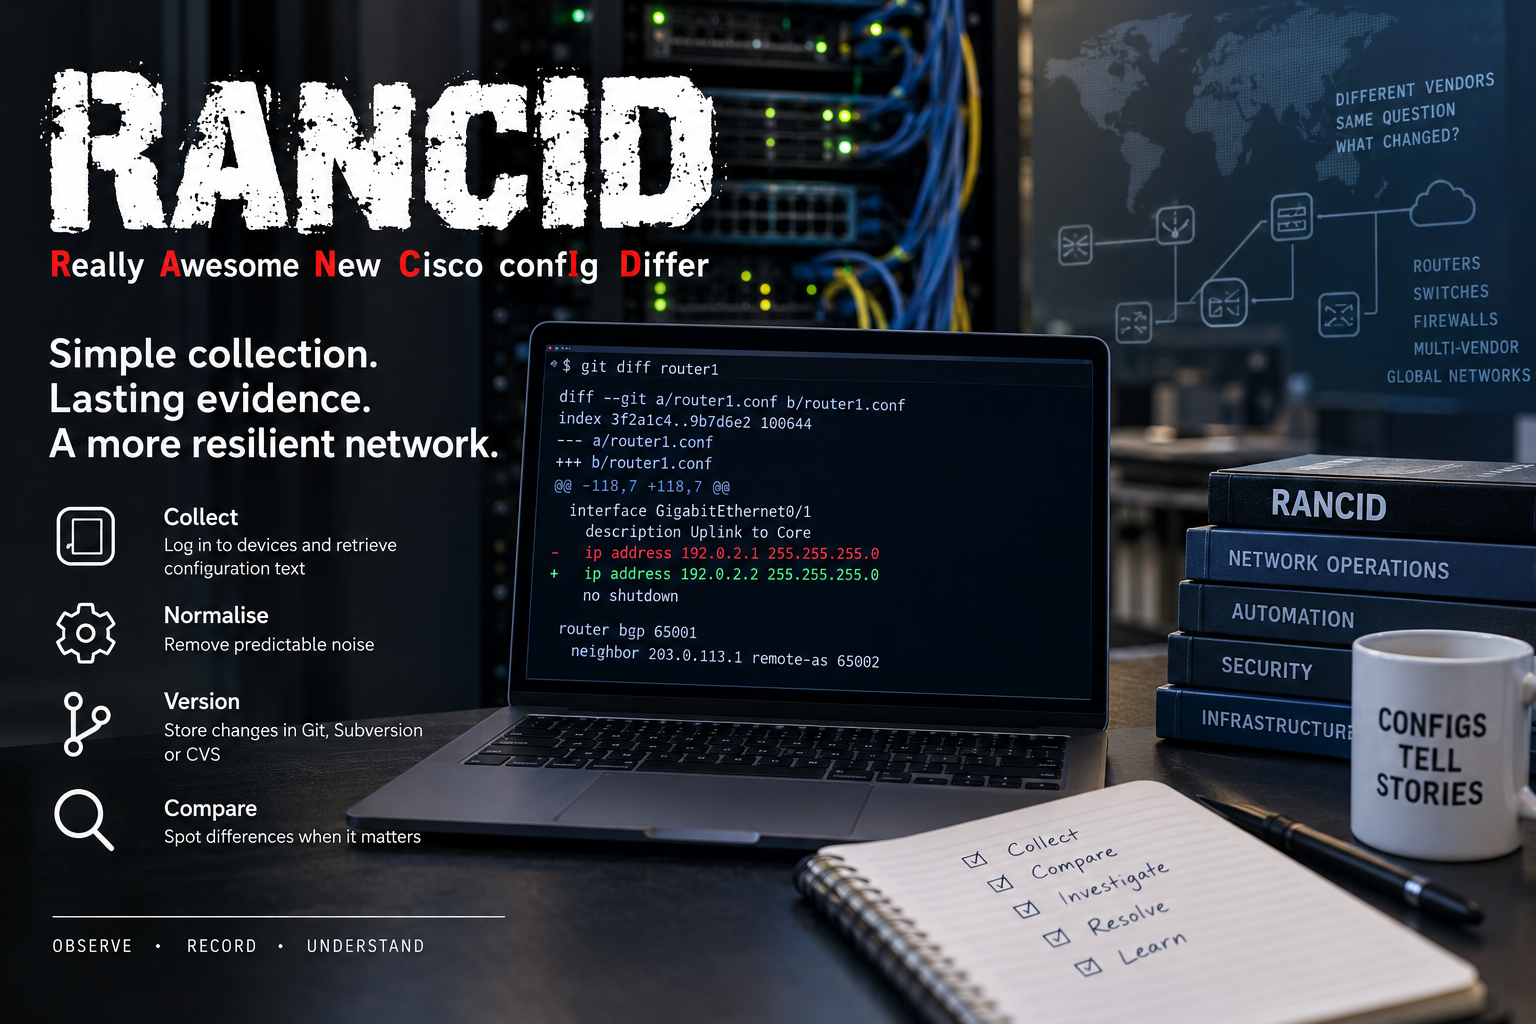
- RANCID—Really Awesome New Cisco confIg Differ—coleta periodicamente as configurações de dispositivos por meio de módulos de login e comandos específicos de cada fornecedor, normaliza a saída e armazena as alterações no CVS, Subversion ou Git.
- Suas evidências são texto observado, não o estado desejado: um instantâneo pode revelar desvio ou uma mudança emergencial e, ainda assim, deixar de registrar edições intermediárias, o estado em tempo de execução e a identidade da pessoa que alterou o dispositivo.
- O mesmo servidor que melhora a reconstrução de incidentes pode se tornar um alvo de segurança de alto valor, pois armazena credenciais de gerenciamento, topologia e segredos de configuração de toda uma frota.
- O RANCID continua útil ao lado de GitOps, automação e plataformas de fonte da verdade porque um coletor independente pode mostrar o que um dispositivo informou depois que o fluxo pretendido foi contornado ou aplicado apenas parcialmente.
Após uma interrupção, a menor pergunta útil costuma ser “o que mudou?”
Uma rede pode falhar devido a uma interação complexa entre política de roteamento, estado das interfaces, defeitos de software e tráfego. A primeira pista que permite agir ainda pode ser uma única linha de configuração. O endereço de um vizinho mudou. Uma lista de acesso foi movida. Um route map ganhou uma condição adicional de correspondência. Um trunk perdeu uma VLAN. O dispositivo aceitou o comando, e o efeito operacional apareceu depois, talvez longe do ponto da mudança.
O RANCID foi criado para atender à necessidade de preservar essa evidência. Ele se conecta a roteadores, switches e outros dispositivos compatíveis, executa comandos, filtra a saída e registra o texto resultante no controle de versão. Quando um arquivo muda, o repositório fornece um diff e pode disparar um e-mail ou outro fluxo de trabalho. O sistema não precisa compreender toda a intenção de negócio por trás do comando para mostrar que a configuração informada pelo dispositivo está diferente.
A modéstia desse modelo é uma força. O RANCID não afirma ser o plano de controle completo. Ele não agenda uma mudança aprovada, gera todas as configurações de todos os fornecedores nem garante conformidade com políticas. Ele registra observações periódicas. Isso o torna útil em ambientes heterogêneos, nos quais alguns dispositivos são automatizados, outros são gerenciados manualmente e alguns são antigos demais para oferecer uma API moderna.
O modelo também é incompleto por definição. Uma mudança pode ser aplicada e revertida entre as coletas. Uma falha de login pode deixar um arquivo antigo com aparência de atual. Um módulo de fornecedor pode omitir justamente o comando relevante. A normalização pode remover um campo variável que depois se revele importante. Um diff mostra que o coletor observou textos diferentes; ele não prova quem alterou o dispositivo, por que fez a mudança nem se ela causou o incidente.
Essas ressalvas não reduzem o valor da evidência. Elas o definem. O RANCID oferece aos operadores uma resposta durável e de baixa complexidade para uma pergunta específica em um momento determinado. Durante uma interrupção, essa resposta pode ser mais útil do que um painel abrangente que relata sintomas sem preservar o contexto da configuração.
O projeto deu memória externa aos roteadores antes que os controladores se tornassem populares
O RANCID surgiu quando os dispositivos de rede eram gerenciados principalmente por interfaces de linha de comando. A configuração ficava nos roteadores e switches, enquanto o conhecimento operacional muitas vezes permanecia na memória, nos históricos de terminal ou nos diretórios pessoais dos engenheiros. A substituição de um dispositivo ou uma edição equivocada podia revelar que a organização não possuía um registro independente e atualizado.
O nome do projeto começou com Cisco, mas seu escopo se expandiu por meio de módulos específicos de fornecedores. A arquitetura aceitava um fato incômodo: os sistemas operacionais de rede ofereciam prompts, sequências de login, comportamentos de paginação e comandos diferentes. Em vez de esperar por um modelo universal de gerenciamento, o RANCID automatizou as interfaces que realmente existiam.
Isso tornou o sistema prático entre diferentes gerações de equipamentos. Um coletor podia usar um script de login comoclogin, controlado pelo Expect, para processar prompts e sessões. Um módulo de fornecedor podia executar comandos que retornavam a configuração em execução, o inventário de hardware ou outro estado relevante. A saída podia então ser normalizada e armazenada como texto.
A abordagem é frágil exatamente das mesmas formas que a automação por linha de comando. Um prompt alterado pode interromper um script. Uma nova versão de firmware pode mudar a saída dos comandos. Paginação, banners, desafios de autenticação e temporização variam. Alguns dispositivos exigem cifras antigas ou ainda oferecem Telnet. Módulos locais podem divergir do projeto principal. Cada plataforma compatível carrega um conjunto de conhecimentos que precisa ser mantido.
Ainda assim, a longevidade da arquitetura evidencia que a interoperabilidade muitas vezes chega pela adaptação, e não por um padrão único e limpo. O RANCID não torna consistentes as CLIs dos fornecedores. Ele cria um fluxo de trabalho comum em torno dessa inconsistência. O repositório se torna a interface estável, mesmo quando a coleta por trás dele utiliza comandos diferentes.
Essa escolha também separou a memória do dispositivo. Um roteador podia falhar completamente, e a organização ainda teria sua última configuração coletada e o histórico de mudanças. O arquivo podia apoiar substituições, auditorias e análises de incidentes. O dispositivo continuava sendo a fonte do texto observado, mas já não era o único lugar em que a organização se lembrava dele.
router.dbtransforma uma frota em um plano de coleta agendada
O fluxo tradicional do RANCID começa comrouter.db, um inventário de dispositivos que associa nomes de host a tipos e estados. As entradas ativas tornam-se alvos de coleta. Os grupos definem limites organizacionais, agendas e repositórios. O arquivo é simples o suficiente para ser inspecionado e versionado, mas importante o bastante para determinar quais dispositivos são lembrados e quais permanecem invisíveis.
A simplicidade torna os erros legíveis. Um nome de host digitado incorretamente, um tipo de dispositivo errado ou um estado desativado podem ser encontrados no texto. Isso também significa que o inventário é apenas tão completo quanto o processo que o mantém. Um roteador ausente derouter.dbnão passa a ser monitorado por meio de uma descoberta automática milagrosa. Um dispositivo desativado pode permanecer no arquivo. Um nome de host pode ser resolvido para um endereço inesperado. O inventário precisa ser reconciliado com a fonte da verdade efetivamente usada pela organização.
Quandorancid-runé executado, ele seleciona dispositivos ativos, aciona a lógica apropriada de login e fornecedor, recupera a saída, compara-a com a versão anterior e registra mudanças relevantes. Falhas e novas tentativas fazem parte do fluxo de trabalho. Um dispositivo pode estar inacessível, a autenticação pode falhar ou um comando pode retornar dados incompletos. O resultado deve ser tratado como um evento de coleta com um status, não apenas como a presença de um arquivo.
Essa distinção é importante porque uma aparência de sucesso baseada em dados antigos pode ser perigosa. Se a versão mais recente do repositório tiver vários meses, ela ainda poderá parecer limpa e legível. Os operadores precisam saber a idade da última coleta bem-sucedida, o número de falhas consecutivas e se todos os comandos esperados foram concluídos. Um arquivo de configurações sem monitoramento de atualidade pode criar falsa confiança.
O modelo de grupos pode limitar o raio de impacto e esclarecer responsabilidades. Equipes ou ambientes diferentes podem usar credenciais, agendas e repositórios separados. Dispositivos de alto impacto podem ser consultados com maior frequência ou por coletores isolados. Ambientes de desenvolvimento e produção podem manter políticas distintas. A arquitetura oferece essa possibilidade; os administradores locais decidem se vão utilizá-la.
O inventário do RANCID não é uma fonte da verdade da rede no sentido moderno de modelagem de intenção. Ele é um plano de coleta. Essa função restrita é valiosa porque pode ser comparada com o inventário pretendido. Um dispositivo presente no NetBox, mas ausente do RANCID, pode não ter evidências históricas. Um alvo do RANCID ausente do inventário aprovado pode ser uma infraestrutura esquecida. A discrepância costuma ser mais útil do que qualquer uma das listas isoladamente.
O login baseado em Expect viabilizou a automação e concentrou credenciais
As CLIs interativas de rede foram projetadas para pessoas, não para software determinístico. Elas exibem banners, solicitam nomes de usuário e senhas, negociam o comportamento do terminal, pausam a saída e mudam os prompts quando os níveis de privilégio ou os modos de configuração são alterados. O Expect permite que scripts aguardem padrões e respondam, transformando uma conversa em uma sequência automatizada.
As ferramentas de login do RANCID aplicam esse método aos dispositivos de rede. Elas podem usar Telnet ou SSH, conforme a configuração local e a capacidade do dispositivo, processar prompts, entrar em modos privilegiados e executar comandos. Isso permitiu aos operadores automatizar dispositivos muito antes de APIs e do gerenciamento orientado por modelos se tornarem comuns.
O mecanismo de login cria uma concentração grave de risco de segurança. Um coletor pode precisar de acesso de leitura a centenas ou milhares de dispositivos. As credenciais são normalmente descritas em.cloginrc, protegido por permissões do sistema de arquivos e controles locais. Se o servidor ou o arquivo for comprometido, um invasor poderá obter tanto um mapa da frota quanto material de autenticação para seu plano de gerenciamento. Quando são usadas credenciais privilegiadas ou compartilhadas, o raio de impacto aumenta ainda mais.
O acesso somente de leitura pode reduzir a capacidade de alterar dispositivos, mas o privilégio efetivo depende de cada plataforma. Alguns dispositivos não separam de forma clara a exibição da configuração de um acesso mais amplo a comandos. O próprio arquivo pode revelar strings de comunidade, hashes de senhas, chaves, descrições de interfaces, nomes de clientes e endereçamento interno. A filtragem de segredos ajuda, mas não é uma garantia completa.
Uma implantação segura, portanto, trata o servidor do RANCID como um sistema privilegiado do plano de controle. Ele deve ser segmentado, atualizado com correções, copiado em backup e monitorado. As credenciais devem ter escopo limitado, ser rotacionadas e auditadas. O SSH deve substituir o Telnet quando houver suporte dos dispositivos. Algoritmos antigos devem ser isolados, em vez de habilitados amplamente em um servidor geral de gerenciamento. O acesso ao repositório deve seguir o princípio do menor privilégio.
O uso do Expect também cria dependências operacionais. Uma mudança para uma autenticação mais forte, uma exigência de autenticação multifator ou uma alteração no prompt pode interromper a automação. Os operadores precisam de um caminho não interativo compatível que não enfraqueça a segurança apenas para manter a coleta funcionando. Dispositivos de teste e mudanças graduais de credenciais podem evitar uma perda de visibilidade em toda a frota.
A troca entre segurança e utilidade no RANCID é direta: centralizar a coleta melhora as evidências e a recuperação, mas cria um alvo de alto valor. A resposta correta não é negar essa concentração, e sim projetar controles em torno dela.
Módulos de fornecedores traduzem saídas instáveis de comandos em texto comparável
Um roteador Cisco, um dispositivo Juniper e o switch de outro fornecedor não apresentam os mesmos comandos nem a mesma saída. O RANCID lida com essa diversidade por meio de módulos específicos de dispositivos e de lógica de login. Cada módulo sabe quais comandos executar e como processar a resposta. A saída comum não é um modelo de dados universal; é um conjunto de arquivos de texto adequado para comparação.
Essa organização permite suporte incremental. Um colaborador pode adicionar ou atualizar uma plataforma sem reformular todo o coletor. Ambientes com equipamentos de longa duração se beneficiam porque um módulo pode continuar atendendo dispositivos que já não recebem novas APIs de gerenciamento. Os operadores também podem escrever módulos locais para equipamentos especializados.
O custo é um trabalho contínuo de análise da saída. Uma CLI legível por humanos não é um contrato estável. Fornecedores adicionam títulos, reordenam seções e alteram espaços em branco. Ramos de firmware divergem. Um prompt ou uma mensagem de erro pode se parecer com a saída esperada. Um módulo pode coletar silenciosamente apenas parte da configuração caso um comando seja renomeado ou as permissões mudem.
Os testes são difíceis porque os responsáveis pela manutenção não possuem todos os modelos e versões de software. Amostras de saída podem apoiar testes de regressão, mas não reproduzem temporização, autenticação ou todos os estados das plataformas. Correções locais podem resolver um problema imediato e, ao mesmo tempo, criar uma ramificação que já não acompanha as correções do projeto principal. Por isso, o suporte a dispositivos deve ser descrito pelo tipo exato, pelo conjunto de comandos e pela versão testada, e não por uma alegação ampla sobre uma marca.
Os módulos também decidem o que conta como configuração. Alguns comandos exibem inventário de hardware, versões de software ou estado operacional junto com a configuração. Incluir mais dados pode ajudar na análise de incidentes, mas produz diffs mais ruidosos e repositórios maiores. Excluí-los pode deixar o arquivo mais limpo, mas ocultar uma mudança relevante. Não existe um limite correto independente do contexto.
A conquista multifornecedor do RANCID não foi eliminar interfaces proprietárias. Foi preservar um fluxo de evidências consistente apesar delas. Isso é menos elegante do que um modelo comum e, com frequência, mais útil de imediato em operações com sistemas antigos. O repositório se torna o ponto de comparação, enquanto o módulo registra as concessões necessárias para chegar até ele.
A normalização separa mudanças significativas da saída que muda a cada execução
A saída de dispositivos de rede contém valores inúteis em um diff de configuração porque mudam continuamente. Tempo de atividade, carimbos de data e hora, contadores, identificadores de sessão e material criptográfico gerado podem fazer cada coleta parecer diferente. O RANCID filtra ou mascara campos selecionados para que o repositório registre mudanças que um operador consiga interpretar.
A normalização transforma a saída bruta dos comandos em evidência operacional. Sem ela, um e-mail diário poderia conter centenas de linhas alteradas apenas porque o tempo passou. Os engenheiros deixariam de ler. Ao remover campos voláteis e padronizar a saída, o sistema permite que uma mudança de política em uma única linha se destaque.
A decisão de filtragem também é uma forma de poder editorial. Um campo removido como ruído não poderá ajudar em uma análise posterior. Um hash de senha pode ser mascarado por segurança, mas uma mudança nesse hash pode evidenciar a rotação de credenciais. Um carimbo de data e hora pode parecer irrelevante até revelar uma reinicialização. Um identificador dinâmico pode distinguir um processo rotineiro de outro inesperado.
O filtro correto depende da finalidade do arquivo. Um repositório de conformidade pode priorizar textos estáveis de políticas e uma remoção agressiva de segredos. Um sistema de investigação de incidentes pode manter mais contexto em um local protegido. Algumas organizações podem conservar saídas separadas ou complementar o RANCID com logs e telemetria.
A normalização pode falhar quando a sintaxe do fornecedor muda. Uma expressão regular escrita para um formato pode remover dados demais ou deixar de ocultar um segredo. A revisão deve, portanto, incluir o resultado filtrado e, quando for seguro, testes com saídas brutas representativas. Um diff limpo não prova que nenhum dado importante foi descartado.
Essa tensão é central em todo sistema de observabilidade. Evidências úteis raramente são brutas. Elas são selecionadas, transformadas e rotuladas. O RANCID torna essa transformação visível em código e módulos. O operador responsável sabe o que foi removido e não confunde um repositório silencioso com um relato completo do estado do dispositivo.
O controle de versão dá uma linha do tempo ao texto de configuração, mas não um histórico de transações
O RANCID usava originalmente o CVS e depois passou a oferecer suporte ao Subversion e ao Git. O controle de versão fornece histórico durável, diffs, carimbos de data e hora e um mecanismo conhecido de replicação ou backup. Ele transforma um diretório de arquivos atuais em uma sequência de estados observados.
Um commit pode mostrar que o coletor viu uma configuração na segunda-feira e outra na terça-feira. Ele pode identificar as linhas diferentes e permitir uma comparação com o período de uma interrupção. Ramificações e cópias distribuídas no Git podem melhorar a resiliência e a integração. As ferramentas do repositório podem aplicar políticas de acesso e retenção.
O commit não é a transação do dispositivo. Seu autor pode ser a conta de serviço do RANCID, e não o engenheiro que realizou a mudança na rede. O carimbo de data e hora registra o momento da coleta ou do commit, não necessariamente a execução do comando. Várias edições no dispositivo podem ser reunidas em um único diff. Uma mudança aplicada e revertida entre as coletas pode nunca aparecer.
O repositório também pode preservar dados sensíveis indefinidamente. Remover um segredo do arquivo mais recente não o exclui do histórico. Reescrever o histórico causa interrupções e pode deixar cópias em outros lugares. Verificação de segredos, controles de acesso e filtragem cuidadosa nos módulos são necessários antes de registrar as configurações de uma grande frota.
A integridade do repositório é importante. Um invasor que comprometa o coletor pode alterar arquivos atuais ou o histórico, suprimir diffs ou inserir evidências enganosas. Espelhos remotos, commits assinados ou backups imutáveis podem aumentar a confiança, mas cada medida precisa de um modelo de ameaças. O controle de versão comum registra mudanças; ele não prova automaticamente que o registro é autêntico.
A retenção deve refletir os requisitos operacionais e jurídicos. Um histórico longo pode revelar desvios recorrentes e oferecer evidências para auditoria. Também aumenta a exposição e o armazenamento. Uma empresa deve decidir quanto histórico precisa e como irá protegê-lo ou descartá-lo.
O uso do controle de versão pelo RANCID foi estrategicamente duradouro porque reutilizou uma ferramenta geral em vez de criar um arquivo proprietário. O mesmo repositório pode ser inspecionado com comandos comuns e integrado a outros fluxos de trabalho. Seu significado continua delimitado: ele é uma linha do tempo do texto coletado, não um registro garantido de todas as ações na rede.
A coleta periódica deixa uma lacuna na qual a mudança mais importante pode ter ocorrido
A principal limitação do RANCID é o tempo. Ele vê instantâneos. Se um dispositivo for consultado a cada hora, 59 minutos de atividade poderão ocorrer entre as observações. Uma mudança prejudicial pode ser introduzida, causar uma interrupção e ser removida antes da execução do coletor. O repositório não mostrará diferença, embora a rede tenha passado por um evento real.
Aumentar a frequência reduz a lacuna, mas adiciona carga. Entrar em muitos dispositivos, executar comandos e processar a saída consome CPU, largura de banda de gerenciamento e recursos dos dispositivos. Algumas plataformas lidam mal com sessões simultâneas. Um coletor precisa equilibrar rapidez e estabilidade.
Falhas de coleta ampliam a lacuna de forma imprevisível. Um incidente de roteamento pode isolar o caminho de gerenciamento justamente quando as evidências de configuração são mais valiosas. Mudanças de autenticação podem bloquear o acesso. Um comando lento pode ultrapassar o tempo limite. Um dispositivo sob pressão pode retornar uma saída parcial. A ausência de um novo commit precisa ser distinguida da confirmação de que nada mudou.
Sistemas orientados a eventos ou de transmissão contínua podem complementar os instantâneos periódicos. Logs de auditoria dos dispositivos podem registrar comandos e usuários. Plataformas de automação podem registrar as mudanças pretendidas. A telemetria pode mostrar o estado em tempo de execução. Controladores podem expor os resultados das transações. Nenhum desses recursos substitui automaticamente o instantâneo independente. Cada um enxerga uma camada diferente e pode falhar por um caminho distinto.
A lacuna também afeta a reversão. Um arquivo anterior do RANCID pode fornecer um texto de referência, mas aplicá-lo sem revisão pode ser inseguro. O software, o hardware ou as dependências ao redor do dispositivo podem ter mudado. O instantâneo pode conter valores gerados ou segredos. A organização deve utilizá-lo como evidência em um processo de recuperação revisado, não como uma verdade executável automática, a menos que tenha criado e testado esse fluxo de trabalho.
O valor do RANCID aumenta quando seus pontos cegos são medidos. Os operadores podem registrar o horário da última coleta bem-sucedida, o intervalo das consultas, a conclusão dos comandos e o status do commit no repositório. Podem comparar instantâneos com chamados de mudança e logs de auditoria dos dispositivos. A ausência de um diff esperado se torna um sinal de que o processo de coleta ou o registro da mudança está incompleto.
A observação periódica não é abrangente, mas é independente. É essa independência que mantém a utilidade da ferramenta ao lado de sistemas que prometem controle em tempo real.
O servidor do RANCID pode expor todo um plano de gerenciamento
Arquivos de configuração são alvos atraentes porque combinam acesso e inteligência. O coletor conhece nomes, endereços, tipos e credenciais dos dispositivos. Os arquivos revelam interfaces, relações de roteamento, listas de acesso, strings de comunidade, hashes, chaves e comentários. Um comprometimento pode acelerar o reconhecimento e abrir um caminho para o controle ativo.
O servidor deve, portanto, ser colocado em um ambiente restrito de gerenciamento, com o mínimo de serviços. Quando as plataformas permitirem, os administradores devem separar as contas de coleta das contas operacionais capazes de realizar alterações. Leitores do repositório não devem receber automaticamente as credenciais de login dos dispositivos. Backups e espelhos devem ser criptografados e ter acesso controlado.
Os segredos merecem atenção especial. O mascaramento da saída coletada é útil, mas não se pode presumir que seja completo em todos os módulos de fornecedores. Novas saídas de comandos podem introduzir campos que o filtro não reconhece. Personalizações locais podem contornar proteções do projeto principal. A verificação automatizada de segredos pode ajudar, embora também produza falsos positivos e não substitua uma revisão de projeto.
Arquivos de credenciais como.cloginrcdependem muito da proteção do sistema de arquivos. Usuários locais, agentes de backup e ferramentas de suporte podem obter acesso não pretendido. Mover as credenciais para um sistema dedicado de gerenciamento de segredos pode melhorar o controle, desde que a integração continue confiável. Qualquer que seja o mecanismo escolhido, a organização precisa de rotação, responsabilidades definidas e evidências de uso.
A segurança da rede pode entrar em conflito com a compatibilidade. Dispositivos antigos podem oferecer apenas algoritmos SSH fracos ou Telnet. Habilitar esses protocolos em um coletor geral amplia o risco. Servidores isolados de compatibilidade, sistemas intermediários ou uma substituição acelerada dos dispositivos podem ser mais seguros do que enfraquecer uma plataforma central. O valor comercial das evidências históricas deve ser comparado ao custo de preservar caminhos inseguros de gerenciamento.
A integridade e a disponibilidade do repositório também pertencem ao modelo de ameaças. Ransomware ou administração destrutiva podem apagar o histórico necessário para a recuperação. Uma cópia offline ou imutável pode proteger as evidências. Logs de auditoria devem registrar acessos e operações incomuns no repositório. A configuração do próprio coletor deve ser versionada e copiada em backup separadamente dos dados dos dispositivos que ele reúne.
A simplicidade do RANCID pode torná-lo mais fácil de proteger do que uma grande suíte de gerenciamento, mas simplicidade não significa isolamento. Seu serviço restrito fica em uma junção privilegiada. Tratá-lo como um servidor utilitário comum ignora o valor concentrado dentro dele.
O LibreNMS acrescenta o sintoma; o RANCID acrescenta o contexto da configuração
LibreNMS e RANCID aparecem juntos com frequência porque respondem a perguntas complementares. O LibreNMS consulta contadores, estados e sensores ao longo do tempo. O RANCID coleta texto de configuração e registra as diferenças. Um alerta de monitoramento pode identificar quando a acessibilidade, os erros ou o tráfego mudaram; o repositório de configurações pode mostrar se o texto do dispositivo foi alterado no mesmo período.
A integração não reúne as evidências em uma única verdade. Os intervalos de consulta são diferentes. Um alerta do LibreNMS pode ocorrer antes de uma coleta do RANCID. O RANCID pode não conseguir entrar no dispositivo enquanto o SNMP continua funcionando, ou o contrário. Uma mudança de configuração pode ser legítima e não ter relação com o sintoma. A correlação restringe a investigação; ela não prova causalidade.
O inventário compartilhado de dispositivos também pode divergir. Um dispositivo pode existir no LibreNMS, mas não emrouter.db. Nomes e endereços podem ser diferentes. Credenciais e permissões podem ser mantidas separadamente. Uma integração deve informar configurações ausentes ou antigas em vez de exibir silenciosamente o último arquivo.
Os limites de segurança exigem cuidado. Exibir configurações por uma interface de monitoramento pode expor texto sensível a usuários que antes tinham acesso apenas a gráficos. A definição de funções deve distinguir a visibilidade operacional do acesso à configuração. Dependendo do modelo de acesso, links para um repositório podem ser mais seguros do que copiar todos os arquivos para outro banco de dados.
O fluxo combinado é mais forte depois de uma mudança. Uma interface cai; o LibreNMS registra o evento e o histórico; o RANCID mostra uma configuração alterada; um sistema de fonte da verdade mostra o que era pretendido; uma plataforma de mudanças mostra a aprovação e o responsável. Nenhuma ferramenta fornece sozinha os quatro registros.
Esse modelo em camadas ilustra por que ferramentas especializadas de código aberto persistem. Uma plataforma abrangente pode integrar dados, mas um coletor independente pode preservar evidências quando o próprio fluxo de mudanças da plataforma é contornado. O valor do RANCID ao lado do LibreNMS vem do fato de continuar sendo um caminho distinto de observação.
GitOps e sistemas de fonte da verdade resolvem a intenção; o RANCID registra a resposta do dispositivo
A automação de redes moderna armazena a configuração pretendida no controle de versão, modela inventário e políticas em sistemas como NetBox ou Nautobot e usa ferramentas como Ansible ou NAPALM para renderizar, validar e implantar mudanças. Nesse mundo, o RANCID pode parecer redundante. Se o Git já contém a configuração, por que coletá-la novamente no dispositivo?
Porque o estado pretendido e o estado observado podem divergir. Um comando emergencial pode contornar a automação. Uma implantação parcial pode falhar em um dispositivo. Um fornecedor pode normalizar ou gerar a configuração de outra maneira. Uma pessoa pode fazer uma mudança durante a solução de um problema e esquecer de reconciliá-la. O repositório de origem pode continuar perfeito enquanto a rede não está.
O RANCID oferece um caminho independente de retorno. Ele pergunta ao dispositivo o que este informa naquele momento e registra a resposta. Comparar essa resposta com a intenção renderizada pode identificar desvios. O processo pode expor falhas na automação, no inventário ou no controle de mudanças, em vez de apenas rotular o dispositivo como não conforme.
O instantâneo ainda não tem semântica. A comparação de texto pode sinalizar uma ordenação inofensiva ou valores gerados. Também pode deixar de detectar uma diferença de comportamento expressa fora dos comandos coletados. APIs estruturadas e dados orientados por modelos podem melhorar a comparação quando houver suporte. O RANCID continua útil em ambientes heterogêneos justamente porque aceita texto quando uma estrutura não está disponível.
O GitOps também apresenta suas próprias questões de autoridade. Um commit no Git registra a mudança pretendida, mas o comportamento em produção depende dos fluxos de automação, das credenciais, das respostas dos dispositivos e de intervenções humanas. O repositório do RANCID registra outro estágio dessa cadeia. Os dois históricos não devem ser fundidos nem autorizados a sobrescrever um ao outro.
Um fluxo maduro pode tratar o RANCID como um controle de detecção. Mudanças aprovadas fluem da intenção para os dispositivos. As configurações coletadas retornam e são comparadas. Diferenças inesperadas geram uma revisão. O coletor não se torna o mecanismo de implantação, o que preserva sua independência.
O ponto estratégico é que a automação aumenta, em vez de eliminar, a necessidade de evidências. Quanto mais rapidamente as mudanças avançam, mais importante é saber o que realmente chegou a cada dispositivo. O antigo modelo de diff de texto do RANCID ainda pode cumprir essa função quando seus limites são compreendidos.
Oxidized e gerenciadores comerciais modernizam o fluxo sem eliminar o problema original
Oxidized é uma alternativa de código aberto de destaque que também coleta configurações de dispositivos de rede por meio de lógica específica para cada modelo e armazena versões, normalmente no Git. Sua arquitetura e suas integrações podem se ajustar de outra forma aos ambientes modernos, e muitos operadores o utilizam com o LibreNMS. O RANCID continua sendo a referência histórica da categoria.
Gerenciadores comerciais de configuração de rede acrescentam descoberta, regras de conformidade, fluxos de aprovação, automação de mudanças, suporte a fornecedores e relatórios. Eles podem oferecer contratos e uma experiência de usuário mais integrada. Também introduzem custos de licença, modelos de dados proprietários e dependência da cobertura de dispositivos e do roteiro de um fornecedor.
Estruturas de automação podem recuperar estados estruturados ou aplicar mudanças. Controladores podem manter a política pretendida. Sistemas nativos dos dispositivos podem registrar o histórico de comandos. Esses recursos se sobrepõem a partes do RANCID, mas não eliminam a pergunta central: existe um registro independente e durável do que o dispositivo informou ao longo do tempo?
A escolha não é binária. Uma organização pode usar um gerenciador comercial para o fluxo de trabalho, Git para o estado pretendido, telemetria contínua para evidências em tempo de execução e RANCID ou Oxidized para instantâneos independentes. A arquitetura deve evitar a duplicação desnecessária de credenciais e definir qual registro responde a cada pergunta.
As vantagens do RANCID são maturidade, transparência, requisitos modestos de recursos e compatibilidade com texto e controle de versão padrão. Suas desvantagens são a fragilidade da CLI, o inventário manual, a governança formal limitada, a concentração de riscos de segurança e uma experiência de usuário moldada por scripts, não por um produto moderno. Essas trocas são claras e frequentemente aceitáveis nas partes de uma rede que as plataformas mais novas não cobrem bem.
A presença contínua do projeto não significa que a automação de redes falhou. Significa que os sistemas de automação ainda precisam de uma memória externa. Quanto mais sofisticado se torna o fluxo de estado pretendido, mais valiosa pode ser uma observação simples e independente quando as próprias premissas desse fluxo são questionadas.
Diffs por e-mail transformam mudanças no repositório em um fluxo humano
O modelo operacional tradicional do RANCID não termina em um commit. Uma mudança pode produzir um e-mail com o diff, colocando a evidência de configuração diretamente no fluxo de trabalho dos engenheiros de rede. O mecanismo é simples o suficiente para sobreviver a mudanças em sistemas de chamados e painéis. Ele também expõe a diferença entre notificação e resposta.
Um diff útil é conciso, atribuível a um dispositivo e entregue a pessoas que compreendem suas consequências. A normalização apoia esse objetivo ao remover o ruído rotineiro. Os grupos podem encaminhar mudanças à equipe apropriada. Links para o repositório podem oferecer um contexto mais amplo. Uma mudança agendada pode ser reconhecida rapidamente; uma linha inesperada pode provocar uma investigação antes do incidente seguinte.
O mesmo canal pode se tornar ineficaz devido ao volume. Grandes mudanças planejadas produzem mensagens longas. Campos voláteis que escaparam da filtragem criam ruído repetitivo. Um dispositivo instável pode enviar as mesmas variações em todos os ciclos. Os engenheiros criam filtros de e-mail, deixam de ler e acabam perdendo justamente a mudança que o sistema deveria revelar. A fadiga de alertas não se limita às plataformas de monitoramento; um fluxo de diffs pode sofrer a mesma falha.
A política de notificações, portanto, precisa ser projetada. Manutenções planejadas podem ser correlacionadas com as mudanças esperadas. Diffs muito grandes podem ser resumidos com um link para o repositório, preservando o registro completo. Falhas de coleta repetidas devem ser diferenciadas de mudanças de configuração. As equipes podem medir eventos não lidos ou não confirmados, em vez de presumir que a entrega equivale à revisão.
O e-mail também cria risco de vazamento de dados. Um diff de configuração pode conter endereçamento interno, referências a clientes ou um segredo que a filtragem não removeu. Listas de distribuição e arquivos de mensagens podem ter acesso mais amplo do que o repositório. Encaminhamentos podem levar as evidências para fora do ambiente de gerenciamento. Algumas organizações preferirão integrações com sistemas de chamados ou chat que tenham controles de acesso mais fortes, embora esses sistemas introduzam seus próprios tokens e políticas de retenção.
O recurso importante não é o e-mail em si. É a transformação de um evento do repositório em uma etapa operacional com responsabilidades. Quem deve revisar o diff? Em quanto tempo? O que torna uma mudança autorizada? Onde a decisão é registrada? O RANCID fornece um gatilho; a organização precisa transformá-lo em um controle.
Um fluxo maduro também reconhece que a ausência de mensagens não é evidência de normalidade. Se o coletor ou o sistema de e-mail falhar, o silêncio pode parecer estabilidade. Mudanças sintéticas, notificações de teste e painéis de atualidade podem verificar todo o caminho entre o dispositivo e a pessoa. O diff de uma linha só é relevante se alguém puder confiar que as linhas importantes chegariam.
A função de looking glass mostra por que o acesso de leitura ainda precisa de limites
Historicamente, o RANCID inclui um recurso de looking glass que permite a usuários selecionados executar comandos de diagnóstico limitados por meio de uma interface web. A ideia é atraente para as operações: equipes de suporte ou usuários externos podem examinar rotas e acessibilidade sem receber acesso irrestrito ao dispositivo. A função transforma a automação existente de login em um serviço controlado de diagnóstico.
O limite de segurança é delicado. Um comando aparentemente somente de leitura pode revelar tabelas de roteamento, vizinhos, interfaces, endereços e políticas. A entrada do usuário deve ser restringida para que não permita a execução arbitrária de comandos da CLI. O aplicativo web, a lista de comandos permitidos, as credenciais dos dispositivos e o tratamento da saída tornam-se uma única cadeia de confiança. Uma falha em qualquer ponto pode transformar uma conveniência de diagnóstico em acesso ao plano de gerenciamento.
Mesmo uma saída corretamente restrita pode ser sensível. Uma visão pública de rotas é diferente de uma topologia interna ou de informações específicas de clientes. Os operadores precisam decidir quais dispositivos e comandos pertencem a cada público. Limites de frequência e registros de atividade podem reduzir abusos. A separação em relação ao coletor principal pode limitar as consequências do comprometimento da interface web.
O looking glass também ilustra uma questão mais ampla sobre o RANCID: as credenciais de coleta podem sustentar serviços além do arquivamento, o que aumenta tanto a utilidade quanto o risco. Reutilizar o mesmo caminho privilegiado para funções demais torna o coletor um alvo maior. Uma conta de serviço restrita e uma conta separada de diagnóstico podem ser mais seguras, mesmo que aumentem a administração.
Servidores de rotas e plataformas modernas de observabilidade podem oferecer visões semelhantes por meio de APIs e interfaces específicas. Isso não torna a função histórica irrelevante; esclarece a questão de projeto. O acesso de leitura é uma autoridade que deve ter escopo definido, ser monitorada e justificada. A ausência de comandos de configuração não torna as informações inofensivas.
Um perfil do RANCID não deve tratar o looking glass como a principal identidade do projeto, mas ele ajuda a explicar sua cultura operacional. O sistema nasceu de operações pragmáticas de rede, nas quais os engenheiros precisavam de formas de inspecionar e preservar o estado dos dispositivos usando as interfaces disponíveis. Cada conveniência trazia um limite de gerenciamento que os operadores locais precisavam aplicar.
A sustentabilidade depende de um pequeno projeto canônico e de muitas implantações invisíveis
O RANCID é um software de código aberto, não uma empresa convencional com receita, funcionários e uma organização de suporte ao cliente divulgados. O projeto canônico é mantido por meio da Shrubbery Networks e de colaboradores. O registro público não oferece um levantamento completo e atual dos responsáveis pela manutenção, do orçamento ou do plano de sucessão.
Essa forma cria resiliência e fragilidade. O código pode ser baixado, inspecionado, modificado e mantido em funcionamento sem a renovação de uma licença. Os operadores podem manter módulos locais depois que um fornecedor ou consultor deixa de se interessar por um dispositivo. O projeto não fica exposto a uma única decisão comercial de descontinuar um produto por assinatura.
Ao mesmo tempo, a disponibilidade aberta não cria capacidade de revisão. Módulos de dispositivos precisam de atualizações. Problemas de segurança exigem diagnóstico e novas versões. Documentação e sistemas de compilação envelhecem. Poucas pessoas podem concentrar o conhecimento do qual milhares de instalações dependem sem que essas instalações sejam visíveis ou contribuam com recursos para o projeto principal.
A distribuição por pacotes pode ajudar ao adaptar o RANCID a sistemas operacionais e distribuir correções. Também pode gerar atrasos ou divergências. A versão de um pacote pode ficar atrás da versão canônica. Correções locais talvez nunca retornem ao projeto principal. Uma organização pode acreditar que está “usando RANCID” enquanto executa uma ramificação com comportamento significativamente diferente.
A economia acontece principalmente fora do projeto. Os usuários pagam por servidores de coleta, armazenamento, backups e tempo de engenharia. Consultores podem obter receita com implantação ou suporte. O projeto cria valor por meio de investigações mais rápidas e configurações preservadas, mas esse valor não aparece como receita auditada do projeto. Uma pequena carga de manutenção pode sustentar grandes ativos posteriores sem um mecanismo de financiamento correspondente.
A sustentabilidade deve, portanto, ser monitorada por meio de versões, respostas de segurança, atividade dos colaboradores, documentação e saúde da distribuição canônica. Grandes usuários podem reduzir o risco contribuindo com correções, saídas de teste, financiamento ou trabalho de manutenção, em vez de tratar o projeto como um utilitário estático. Também devem manter um plano de saída: o formato do repositório é portátil, mas a lógica local de coleta e as credenciais talvez não sejam.
A ausência de uma fundação formal ou de um fornecedor dominante não é necessariamente um defeito. Significa, porém, que nenhum órgão central pode garantir um roteiro. As organizações que dependem do RANCID precisam decidir quanta responsabilidade irão internalizar e quais relações externas são confiáveis o bastante para sustentá-lo.
Uma migração deve preservar as evidências, não apenas substituir o coletor
Quando organizações migram do RANCID para o Oxidized, um gerenciador comercial ou uma plataforma baseada em controladores, a tarefa óbvia é coletar as configurações atuais no novo sistema. A tarefa mais difícil é preservar o significado do arquivo histórico. Anos de diffs podem ser valiosos durante auditorias, litígios, revisões de incidentes ou na reconstrução dos motivos de um projeto antigo.
Um plano de migração deve preservar o histórico do repositório, os carimbos de data e hora, a identidade dos dispositivos e os controles de acesso. Se os nomes dos arquivos ou dos hosts mudarem, será necessário um mapeamento para comparar os registros antigos e novos. A política de retenção de segredos deve ser revisada antes da transferência do histórico para uma nova plataforma. Dados protegidos em um repositório Git local podem se tornar mais amplamente visíveis quando transferidos para um aplicativo web.
A equivalência da coleta também precisa ser testada. A nova ferramenta pode executar comandos diferentes ou normalizar a saída de outra maneira. Uma migração correta pode parecer alterar todas as linhas porque a formatação mudou. Por outro lado, um modelo supostamente equivalente pode omitir comandos coletados pelo RANCID. Execuções paralelas fornecem evidências sobre cobertura, atualidade e comportamento diante de falhas antes da desativação do coletor antigo.
As credenciais não devem ser copiadas automaticamente. A migração é uma oportunidade para reduzir privilégios, substituir segredos compartilhados, adotar algoritmos SSH mais fortes e segmentar dispositivos. Equipamentos antigos que não atendam à nova política podem exigir um coletor isolado ou um plano acelerado de substituição.
O repositório antigo não deve permanecer online indefinidamente sem um responsável. Se for mantido, precisará de backups, atualizações de segurança e revisão de acesso. Se for arquivado, a organização deve saber como lê-lo e verificá-lo. Um diretório compactado que ninguém consegue interpretar não é uma evidência preservada.
Essa disciplina de migração reforça a lição mais ampla do RANCID. O ativo durável não é apenas o script ou a interface. É uma sequência confiável de observações e o conhecimento de como elas foram produzidas. Substituir o coletor e descartar a proveniência pode tornar um sistema moderno menos útil do que o sistema antigo que ele substituiu.
O uso de texto comum e controle de versão pelo RANCID ajuda porque os dados não ficam presos a um banco de dados proprietário. A portabilidade, porém, é apenas potencial. Ela se torna real quando a organização documenta módulos, filtros, agendas, mapeamentos de dispositivos e as limitações do registro.
O texto da configuração não é a mesma coisa que o comportamento da rede
Um roteador pode ter uma configuração aparentemente correta e ainda se comportar de forma inesperada. As rotas dependem do estado dos vizinhos, dos anúncios recebidos, de temporizadores, recursos de hardware, defeitos de software e políticas aplicadas em outros lugares. Uma lista de acesso pode existir no texto, mas estar associada à interface errada. Um route map pode estar correto isoladamente e ainda corresponder a dados que mudaram fora do dispositivo. O RANCID preserva uma camada importante, não todo o sistema de encaminhamento.
Esse limite é importante durante o diagnóstico. Um diff próximo ao incidente é uma evidência que merece investigação, mas a proximidade temporal não prova a causa. Os engenheiros devem comparar o estado operacional: tabelas de roteamento, estado das adjacências, contadores de interfaces, logs e telemetria. Devem perguntar se o comando alterado estava ativo, se a mudança se propagou e se outro sistema produziu o mesmo sintoma.
O caso oposto também ocorre. O comportamento pode mudar sem um diff de configuração. Um enlace falha. Um vizinho anuncia uma rota diferente. Um certificado expira. Uma tabela de hardware fica cheia. Um processo reinicia e seleciona um novo caminho com base em uma política inalterada. Um sistema de monitoramento ou telemetria é necessário para enxergar esses eventos. O RANCID não deve ser criticado por não registrar um estado que não foi projetado para coletar.
Alguns módulos de fornecedores incluem comandos operacionais além da configuração, o que pode ajudar. Essa escolha deve ser documentada porque altera o significado e o perfil de ruído do arquivo. Um instantâneo da tabela de rotas pode ser grande e volátil. Armazená-lo periodicamente pode apoiar comparações, mas consome espaço e produz diffs que ocultam mudanças de configuração.
Modelos estruturados de estado podem melhorar o raciocínio, mas também exigem suporte dos fornecedores e uma semântica cuidadosa. O texto continua útil porque está próximo do que os engenheiros veem e pode ser inspecionado com ferramentas comuns. A arquitetura mais forte usa ambos quando possível: telemetria estruturada para o comportamento atual, instantâneos de configuração para a política informada pelo dispositivo e sistemas de intenção para o projeto aprovado.
Essa separação protege contra um erro analítico comum. Um arquivo de configuração não prova conformidade apenas porque os arquivos existem, e uma rede em funcionamento não prova a qualidade da configuração apenas porque o tráfego está fluindo. Evidências de camadas diferentes precisam ser comparadas. O RANCID conquista seu lugar ao tornar uma dessas camadas durável o bastante para participar dessa comparação.
O valor para auditoria depende da proveniência, da retenção e da capacidade de explicar o coletor
O histórico de configurações pode apoiar controles internos, auditorias externas e revisões de incidentes, mas um repositório não é automaticamente um sistema de auditoria. Auditores e investigadores precisam saber quais dispositivos estavam no escopo, com que frequência eram coletados, quais comandos eram executados, quais campos eram filtrados e como o acesso ao arquivo era controlado.
A proveniência começa na configuração do coletor.router.db, as definições dos grupos, as regras de login e os módulos de fornecedores determinam as evidências. Esses arquivos devem ser versionados e revisados. Uma mudança em um filtro pode alterar todos os instantâneos futuros. Uma mudança na agenda pode ampliar as lacunas de observação. Uma mudança nas credenciais pode remover silenciosamente parte da frota.
O tempo é outra dependência. Os carimbos de data e hora do repositório, os relógios dos dispositivos, os registros de chamados e os logs de identidade precisam estar alinhados o suficiente para reconstruir uma sequência. O horário do commit não é necessariamente o horário da mudança na rede. Os investigadores devem preservar essa distinção, em vez de criar uma precisão falsa.
A retenção precisa de uma regra explícita. Manter todas as configurações para sempre pode expor segredos obsoletos e informações pessoais ou de clientes. Excluir o histórico de forma agressiva demais pode remover o único registro capaz de explicar uma política de rotas antiga. Classes diferentes de dispositivos ou dados podem exigir períodos distintos. As obrigações jurídicas e regulatórias variam conforme a organização e a jurisdição.
Controles de integridade podem fortalecer o registro. Espelhos remotos, backups restritos somente para acréscimo, commits assinados ou marcação temporal externa podem dificultar alterações não autorizadas. Nenhuma dessas medidas é útil se chaves, espelhos e coletores compartilharem o mesmo administrador ou sistema de armazenamento comprometido. A independência deve corresponder à ameaça que está sendo enfrentada.
Uma auditoria também precisa de evidências negativas. A organização deve informar coletas com falha, dispositivos ausentes e períodos nos quais o arquivo não era confiável. Ocultar essas lacunas transforma um registro parcial em um registro enganoso. Uma cadeia limpa de commits não cobre um dispositivo que o coletor não conseguiu acessar.
A questão central é saber se outra pessoa qualificada consegue reproduzir o significado do registro depois que o administrador original deixa a organização. Se módulos, filtros e agendas não forem documentados, o repositório poderá preservar o texto e perder sua interpretação. A simplicidade do RANCID ajuda, mas é a governança que transforma essa simplicidade em evidência confiável.
Dispositivos antigos mantêm a necessidade de uma compatibilidade restrita
O hardware de rede costuma permanecer em serviço por mais tempo do que a tendência de gerenciamento sob a qual foi comprado. Um switch pode continuar encaminhando tráfego de forma confiável depois que seu fornecedor migra para outro controlador, modelo de licenciamento ou API. A substituição pode exigir capital, janelas de interrupção e mudanças em sistemas dependentes. Por isso, os operadores mantêm frotas heterogêneas nas quais novos dispositivos oferecem telemetria estruturada, enquanto equipamentos antigos disponibilizam apenas uma linha de comando e SNMP.
O RANCID se ajusta a essa realidade porque seu requisito central é modesto: uma sessão de gerenciamento acessível e um módulo capaz de recuperar texto útil. Ele pode preservar o histórico de dispositivos que já não recebem atenção das plataformas mais novas. Essa capacidade é valiosa em campi, concessionárias de serviços públicos, bordas de redes de provedores e outros ambientes nos quais a infraestrutura envelhece de forma desigual.
O benefício não deve se tornar uma desculpa para uma dívida técnica indefinida. O acesso antigo pode exigir cifras obsoletas, senhas compartilhadas ou Telnet. O software do fornecedor pode conter vulnerabilidades sem correção. Peças de reposição e documentação desaparecem. Um coletor pode manter o dispositivo gerenciável o suficiente para adiar a substituição e, ao mesmo tempo, registrar evidências que apoiem uma migração mais segura.
As organizações devem classificar as exceções de compatibilidade. Um dispositivo antigo pode ser isolado atrás de um coletor e um caminho de gerenciamento dedicados. As credenciais podem ser restringidas. O repositório pode mostrar se sua configuração muda. A prioridade de substituição pode refletir a exposição e a importância comercial, e não apenas a idade.
Essa abordagem separa preservação de aprovação. A capacidade do RANCID de coletar dados de uma plataforma antiga não significa que a plataforma continue segura ou seja estrategicamente desejável. Significa que a organização pode manter a visibilidade enquanto decide como e quando removê-la.
A presença global do RANCID, portanto, não pode ser medida por um único mapa de serviços. O software funciona dentro de redes controladas de maneira independente, muitas vezes justamente porque elas contêm equipamentos que não podem ser entregues a uma plataforma central gerenciada. Seu alcance está registrado em repositórios locais, instalações de pacotes e scripts que os responsáveis pelo projeto talvez nunca vejam.
Essa invisibilidade dificulta a sustentabilidade, mas reforça a finalidade do projeto. A infraestrutura de rede está cheia de ativos cuja vida operacional supera a vida comercial de suas ferramentas de gerenciamento. Um coletor simples pode preencher essa lacuna, desde que seja usado como um controle temporário em torno de limitações conhecidas, e não como permissão para esquecê-las.
Uma ferramenta restrita pode sobreviver a várias tendências de gerenciamento
A sede canônica do projeto RANCID é a Shrubbery Networks, e o site atual, na data-limite desta pesquisa, indicava a versão 3.14, com o arquivo público de versões situando a linha 3.14 em 2025. Existem espelhos e pacotes distribuídos por terceiros, mas o site canônico deve ser usado para afirmações sobre versões e governança, salvo indicação diferente do próprio projeto.
O projeto não publica uma contagem auditada de instalações, orçamento, levantamento completo dos responsáveis pela manutenção nem uma matriz universal de suporte a dispositivos. Por isso, sua escala é difícil de medir. A longevidade e a disponibilidade de pacotes demonstram relevância contínua, mas não estabelecem participação de mercado. Muitas implantações podem ser antigas, modificadas localmente ou invisíveis para os responsáveis pelo projeto principal.
Essa opacidade é comum em pequenos projetos de infraestrutura. O software pode estar profundamente incorporado sem gerar um registro comercial claro. O trabalho de manutenção pode ser voluntário, financiado por empregadores ou sustentado por consultoria. Os usuários se beneficiam do tempo de incidente evitado e das evidências mantidas, mas esse valor não é capturado como receita do projeto.
A sustentabilidade depende de sucessão e trabalho de compatibilidade. Novas versões de software dos dispositivos alteram prompts e saídas. Dispositivos antigos exigem suporte legado. As expectativas de segurança mudam. Sistemas de controle de versão e dependências do sistema operacional evoluem. Uma ferramenta restrita pode permanecer estável, mas essa estabilidade ainda exige revisão e publicação de versões.
O escopo do RANCID o protege de algumas pressões de mercado. Ele não precisa se tornar uma plataforma completa de observabilidade. Pode continuar coletando texto enquanto os dispositivos oferecerem texto que valha a pena coletar. O risco é o projeto se tornar fácil de ignorar até surgir um problema de segurança ou compatibilidade.
O motivo mais forte para seu uso contínuo não é nostalgia. É a existência de redes heterogêneas, duradouras e automatizadas de forma imperfeita. É improvável que essas condições desapareçam rapidamente. Uma ferramenta que registra evidências nesses ambientes pode continuar útil mesmo quando sua interface parece antiga.
Um diff de texto importa porque é uma evidência delimitada e inspecionável
A ideia central do RANCID sobreviveu porque o texto de configuração continua próximo do mecanismo operacional de muitas redes. Um diff pode ser lido por um engenheiro, pesquisado com ferramentas comuns e mantido sem um banco de dados proprietário. A evidência é portátil e compreensível depois que a plataforma original de monitoramento muda.
Seus limites devem ser declarados com a mesma clareza. O arquivo é periódico, não contínuo. Ele registra comandos selecionados, não todo o dispositivo. A normalização pode remover contexto. Um commit identifica a coleta, não a pessoa responsável. Credenciais e repositórios criam um risco para o plano de gerenciamento. Um arquivo não é o estado desejado, e restaurá-lo sem revisão pode ser perigoso.
Esses limites mantêm a ferramenta honesta. O RANCID não precisa afirmar que instantâneos são uma intenção executável. Ele pode complementar o GitOps porque registra a resposta do dispositivo após a automação. Pode complementar o LibreNMS porque acrescenta contexto de configuração aos sintomas. Pode complementar gerenciadores comerciais porque preserva um repositório independente.
O teste observável é verificar se o arquivo melhora uma investigação real. A equipe consegue identificar a última coleta bem-sucedida, comparar as linhas relevantes, vincular a mudança a outro registro e se recuperar sem expor credenciais nem aplicar texto antigo? Consegue provar que o próprio repositório não foi alterado? Consegue reconhecer quando a ausência de um diff é causada por uma falha de coleta?
Se as respostas forem positivas, o RANCID é mais do que um script antigo. É um pequeno sistema de evidências incorporado às operações de rede. Se forem negativas, o controle de versão pode fornecer um histórico convincente da coisa errada.
A lição duradoura do projeto é que não se deve presumir que controle e evidência sejam a mesma coisa. Um controlador declara o que deveria acontecer. Um dispositivo informa o que acredita estar configurado. Um sistema de monitoramento mostra o que determinados sinais fizeram. Um diff de texto preserva uma parte dessa divergência. As redes se tornam mais fáceis de governar quando esses registros podem ser comparados, em vez de forçados a formar uma única narrativa.
A disciplina final é preservar a incerteza no registro. Um diff limpo pode estabelecer que o texto selecionado mudou entre coletas bem-sucedidas. Ele não pode estabelecer a sequência completa de comandos, a motivação do operador ou o caminho causal até uma interrupção. Essas conclusões exigem outros logs, entrevistas e testes. O RANCID é mais confiável quando os usuários resistem a pedir que ele prove mais do que coletou.
Essa contenção também explica por que o sistema continua legível depois de décadas. Seus arquivos podem ser abertos sem um cliente proprietário, seu histórico pode ser espelhado e seus módulos podem ser examinados. A arquitetura não torna as evidências neutras — filtros, agendas e acessos ainda as moldam —, mas deixa essas escolhas próximas o bastante da superfície para que um operador possa questioná-las. Em um mercado de infraestrutura atraído por plataformas de gerenciamento cada vez maiores, essa capacidade de inspeção é uma forma concreta de controle.
Ela também oferece um caminho de saída. Se o projeto, o pacote ou a integração preferida mudar, a organização poderá manter o texto comum e o histórico de versões, desde que tenha documentado como os dados foram reunidos. Essa portabilidade não elimina o trabalho de migração, mas impede que as evidências desapareçam junto com uma conta de fornecedor ou uma estrutura de banco de dados. Para redes duradouras, a capacidade de levar o registro de ontem para a ferramenta de amanhã pode ser tão valiosa quanto qualquer novo recurso de automação.
O arquivo passa então a ser uma memória institucional, e não um anexo de um único coletor. Seu valor depende da continuidade do acesso, de uma proveniência interpretável e de pessoas que saibam onde começam seus limites. Essas são escolhas de governança, não configurações padrão do software, e precisam ser testadas antes que uma emergência atinja a rede na prática.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance