
Résumé
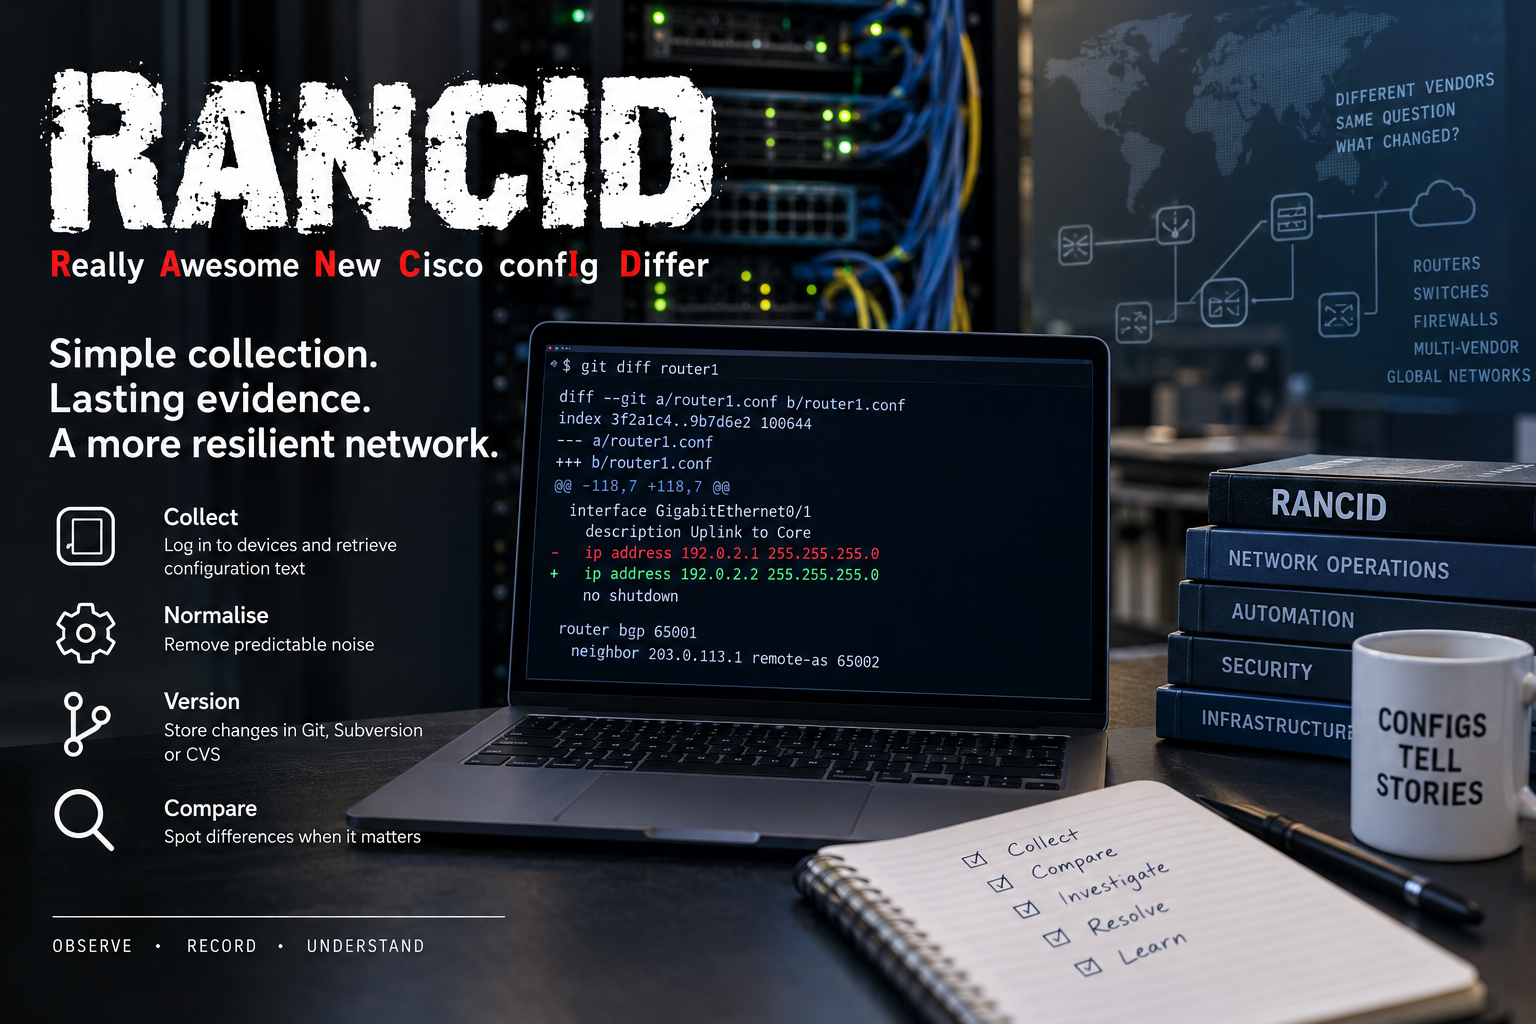
- RANCID—Really Awesome New Cisco confIg Differ—collecte périodiquement les configurations des équipements au moyen de modules de connexion et de commande propres à chaque fournisseur, normalise les sorties et stocke les changements dans CVS, Subversion ou Git.
- Ses preuves reposent sur le texte observé, et non sur l’état souhaité: un instantané peut révéler une dérive ou un changement d’urgence tout en omettant les modifications intermédiaires, l’état de fonctionnement et l’identité de la personne qui a modifié l’équipement.
- Le même hôte qui améliore la reconstitution des incidents peut devenir une cible de grande valeur, car il détient les identifiants de gestion, la topologie et les secrets de configuration de tout un parc.
- RANCID reste utile aux côtés de GitOps, de l’automatisation et des plateformes de référence, car un collecteur indépendant peut montrer ce qu’un équipement a déclaré après le contournement ou l’application partielle du processus prévu.
Après une panne, la plus petite question utile est souvent: « qu’est-ce qui a changé? »
Un réseau peut tomber en panne sous l’effet d’une interaction complexe entre politique de routage, état des interfaces, défauts logiciels et trafic. Le premier indice exploitable peut néanmoins tenir en une seule ligne de configuration. Une adresse de voisin a changé. Une liste d’accès a été déplacée. Une route map a reçu une condition de correspondance supplémentaire. Une liaison multi-VLAN a perdu un VLAN. L’équipement a accepté la commande, puis l’effet opérationnel est apparu plus tard, peut-être loin du point de modification.
RANCID a été conçu pour préserver ce type de preuve. Il se connecte aux routeurs, commutateurs et autres équipements pris en charge, exécute des commandes, filtre leurs sorties et enregistre le texte obtenu dans un système de gestion de versions. Lorsqu’un fichier change, le dépôt fournit un diff et peut déclencher un courriel ou un autre processus. Le système n’a pas besoin de comprendre chaque intention métier à l’origine d’une commande pour montrer que la configuration déclarée par l’équipement est différente.
La modestie de ce modèle constitue une force. RANCID ne prétend pas être le plan de contrôle complet. Il ne planifie pas un changement approuvé, ne produit pas toutes les configurations propres aux fournisseurs et ne garantit pas la conformité aux politiques. Il consigne des observations périodiques. Cela le rend utile dans les parcs hétérogènes où certains équipements sont automatisés, d’autres administrés manuellement et d’autres encore trop anciens pour proposer une API moderne.
Le modèle est aussi volontairement incomplet. Un changement peut être appliqué puis annulé entre deux collectes. L’échec d’une connexion peut laisser un ancien fichier paraître à jour. Un module propre à un fournisseur peut omettre la commande importante. La normalisation peut supprimer un champ variable qui se révèle ensuite essentiel. Un diff montre que le collecteur a observé un texte différent; il ne prouve pas qui a modifié l’équipement, pourquoi cette personne l’a fait ni si le changement a causé l’incident.
Ces réserves ne diminuent pas la valeur de la preuve. Elles la définissent. RANCID fournit aux opérateurs une réponse durable et peu complexe à une question précise, à un instant donné. Pendant une panne, cette réponse peut être plus utile qu’un vaste tableau de bord qui signale les symptômes sans préserver le contexte de configuration.
Le projet a donné aux routeurs une mémoire externe avant que les contrôleurs ne s’imposent
RANCID est apparu à une époque où les équipements réseau étaient principalement administrés par des interfaces en ligne de commande. La configuration résidait sur les routeurs et les commutateurs, tandis que les connaissances opérationnelles se trouvaient souvent dans la mémoire, l’historique des terminaux ou les répertoires personnels des ingénieurs. Le remplacement d’un équipement ou une modification erronée pouvait révéler que l’organisation ne possédait aucun relevé indépendant et à jour.
Le nom du projet faisait initialement référence à Cisco, mais son périmètre s’est élargi grâce à des modules propres aux fournisseurs. L’architecture acceptait un constat inconfortable: les systèmes d’exploitation réseau présentaient des invites, des séquences de connexion, des mécanismes de pagination et des commandes différents. Au lieu d’attendre un modèle de gestion universel, RANCID a automatisé les interfaces réellement disponibles.
Cette approche a rendu le système exploitable sur plusieurs générations d’équipements. Un collecteur pouvait utiliser un script de connexion tel queclogin, piloté par Expect, afin de gérer les invites et les sessions. Un module propre à un fournisseur pouvait exécuter les commandes renvoyant la configuration active, l’inventaire matériel ou d’autres états pertinents. La sortie pouvait ensuite être normalisée et stockée sous forme de texte.
L’approche est fragile de toutes les manières propres à l’automatisation des interfaces en ligne de commande. Une invite modifiée peut interrompre un script. Une nouvelle version de micrologiciel peut changer la sortie d’une commande. La pagination, les bannières, les demandes d’authentification et les délais varient. Certains équipements exigent des chiffrements anciens ou proposent encore Telnet. Les modules locaux peuvent diverger de la version amont. Chaque plateforme prise en charge représente un savoir qu’il faut entretenir.
La longévité de l’architecture montre néanmoins que l’interopérabilité naît souvent de l’adaptation plutôt que d’une norme unique et nette. RANCID ne rend pas cohérentes les interfaces en ligne de commande des fournisseurs. Il construit un processus commun autour de leurs incohérences. Le dépôt devient l’interface stable, même lorsque la collecte sous-jacente emploie des commandes différentes.
Ce choix a également séparé la mémoire de l’équipement. Un routeur pouvait tomber totalement en panne sans priver l’organisation de sa dernière configuration collectée ni de son historique de changements. L’archive pouvait faciliter le remplacement, l’audit et l’analyse d’incident. L’équipement restait la source du texte observé, mais n’était plus le seul endroit où l’organisation le conservait en mémoire.
router.dbtransforme un parc en plan de collecte programmé
Le fonctionnement traditionnel de RANCID commence parrouter.db, un inventaire qui associe les noms d’hôtes à des types et à des états. Les entrées actives deviennent des cibles de collecte. Les groupes définissent les périmètres organisationnels, les calendriers et les dépôts. Le fichier est assez simple pour être inspecté et versionné, mais assez important pour déterminer quels équipements sont mémorisés et lesquels restent invisibles.
Cette simplicité rend les erreurs lisibles. Un nom d’hôte mal orthographié, un type d’équipement incorrect ou un état désactivé peuvent être repérés dans le texte. Elle signifie aussi que l’inventaire n’est complet que si le processus chargé de le tenir à jour l’est également. Un routeur absent derouter.dbne sera pas surveillé par magie. Un équipement mis hors service peut rester dans l’archive. Un nom d’hôte peut se résoudre vers une adresse inattendue. L’inventaire doit être rapproché du véritable système de référence de l’organisation.
Lorsquerancid-runs’exécute, il sélectionne les équipements actifs, appelle la logique de connexion et le module fournisseur appropriés, récupère les sorties, les compare à la version précédente et enregistre les changements significatifs. Les échecs et les nouvelles tentatives font partie du processus. Un équipement peut être inaccessible, l’authentification peut échouer ou une commande peut renvoyer des données incomplètes. Le résultat doit être traité comme un événement de collecte doté d’un état, et non comme la simple présence d’un fichier.
Cette distinction est importante, car un ancien succès peut être dangereux. La dernière version du dépôt peut dater de plusieurs mois tout en restant propre et lisible. Les opérateurs doivent connaître l’âge de la dernière collecte réussie, le nombre d’échecs consécutifs et l’achèvement ou non de toutes les commandes attendues. Une archive de configurations sans surveillance de sa fraîcheur peut créer une fausse confiance.
Le modèle par groupes peut limiter la portée d’un incident et clarifier les responsabilités. Différentes équipes ou différents environnements peuvent employer des identifiants, des calendriers et des dépôts distincts. Les équipements critiques peuvent être interrogés plus fréquemment ou par des collecteurs isolés. Les parcs de développement et de production peuvent suivre des politiques différentes. L’architecture offre cette possibilité; les administrateurs locaux décident de l’utiliser ou non.
L’inventaire de RANCID n’est pas une source de référence réseau au sens moderne de la modélisation de l’intention. C’est un plan de collecte. Ce rôle étroit est utile parce qu’il peut être comparé à l’inventaire prévu. Un équipement présent dans NetBox mais absent de RANCID peut ne disposer d’aucune preuve historique. Une cible RANCID absente de l’inventaire approuvé peut correspondre à une infrastructure oubliée. L’écart entre les deux listes est souvent plus utile que chacune d’elles prise isolément.
La connexion fondée sur Expect a rendu l’automatisation possible tout en concentrant les identifiants
Les interfaces réseau interactives en ligne de commande ont été conçues pour des personnes, non pour des logiciels déterministes. Elles affichent des bannières, demandent des noms d’utilisateur et des mots de passe, négocient le comportement du terminal, interrompent la sortie et modifient les invites selon le niveau de privilège ou le mode de configuration. Expect permet aux scripts d’attendre des motifs puis d’y répondre, transformant une conversation en séquence automatisée.
Les outils de connexion de RANCID appliquent cette méthode aux équipements réseau. Selon la configuration locale et les capacités de l’équipement, ils peuvent employer Telnet ou SSH, gérer les invites, passer en mode privilégié et exécuter des commandes. Cela a permis aux opérateurs d’automatiser les équipements bien avant la généralisation des API et de la gestion pilotée par des modèles.
Le mécanisme de connexion crée une forte concentration du risque de sécurité. Un collecteur peut avoir besoin d’un accès en lecture à des centaines ou des milliers d’équipements. Les identifiants sont couramment définis dans.cloginrcet protégés par les permissions du système de fichiers ainsi que par des contrôles locaux. Si l’hôte ou le fichier est compromis, un attaquant peut obtenir à la fois une cartographie du parc et les moyens d’authentification de son plan de gestion. L’emploi d’identifiants privilégiés ou partagés augmente encore la portée de l’incident.
Un accès en lecture seule peut réduire la capacité à modifier les équipements, mais le privilège réel dépend de chaque plateforme. Certains équipements ne séparent pas clairement l’affichage de la configuration d’un accès plus large aux commandes. L’archive elle-même peut révéler des chaînes de communauté, des empreintes de mots de passe, des clés, des descriptions d’interfaces, des noms de clients et des adresses internes. Le filtrage des secrets est utile, mais ne constitue pas une garantie complète.
Un déploiement sécurisé traite donc l’hôte RANCID comme un système privilégié du plan de contrôle. Il doit être segmenté, corrigé, sauvegardé et surveillé. Les identifiants doivent être limités, renouvelés et audités. SSH doit remplacer Telnet lorsque les équipements le permettent. Les algorithmes anciens doivent être confinés plutôt qu’activés largement sur un hôte généraliste de gestion. L’accès au dépôt doit respecter le principe du moindre privilège.
L’utilisation d’Expect crée également des dépendances opérationnelles. Une évolution vers une authentification renforcée, une obligation d’authentification multifacteur ou une modification des invites peut casser l’automatisation. Les opérateurs ont besoin d’une voie non interactive prise en charge, qui n’affaiblisse pas la sécurité uniquement pour maintenir la collecte. Des équipements de test et des changements d’identifiants par étapes peuvent éviter une perte de visibilité à l’échelle du parc.
Le compromis de sécurité de RANCID est direct: la centralisation de la collecte améliore les preuves et la reprise, mais crée une cible de grande valeur. La bonne réponse n’est pas de nier cette concentration, mais de concevoir les protections qui l’entourent.
Les modules propres aux fournisseurs transforment des sorties de commande instables en texte comparable
Un routeur Cisco, un équipement Juniper et le commutateur d’un autre fournisseur ne présentent ni les mêmes commandes ni les mêmes sorties. RANCID gère cette diversité grâce à des modules et à une logique de connexion propres aux équipements. Chaque module sait quelles commandes exécuter et comment traiter la réponse. La sortie commune n’est pas un modèle de données universel, mais un ensemble de fichiers texte adaptés à la comparaison.
Cette organisation permet une prise en charge progressive. Un contributeur peut ajouter ou mettre à jour une plateforme sans reconcevoir tout le collecteur. Les parcs anciens en bénéficient, car un module peut continuer à servir des équipements qui ne reçoivent plus de nouvelles API de gestion. Les opérateurs peuvent écrire des modules locaux pour du matériel spécialisé.
Le coût réside dans un travail d’analyse syntaxique permanent. Une sortie d’interface en ligne de commande destinée aux humains n’est pas un contrat stable. Les fournisseurs ajoutent des rubriques, réordonnent des sections et modifient les espaces. Les branches de micrologiciel divergent. Une invite ou un message d’erreur peut ressembler à une sortie attendue. Un module peut ne collecter silencieusement qu’une partie de la configuration si une commande est renommée ou si les permissions changent.
Les tests sont difficiles, car les responsables de maintenance ne possèdent pas tous les modèles et toutes les versions logicielles. Des exemples de sorties peuvent alimenter des tests de régression, mais ils ne reproduisent ni les délais, ni l’authentification, ni tous les états d’une plateforme. Un correctif local peut résoudre un problème immédiat tout en créant une branche qui ne bénéficie plus des corrections amont. La prise en charge d’un équipement doit donc être décrite par son type exact, son jeu de commandes et la version testée, et non par une affirmation générale portant sur une marque.
Les modules décident aussi de ce qui constitue une configuration. Certaines commandes exposent l’inventaire matériel, les versions logicielles ou l’état opérationnel en plus de la configuration. Inclure davantage de données peut faciliter l’analyse d’incident, mais produire des diffs plus bruyants et des dépôts plus volumineux. Les exclure peut rendre l’archive plus lisible tout en masquant un changement pertinent. Il n’existe pas de frontière correcte indépendamment du contexte.
La réussite multifournisseur de RANCID ne tient pas à l’élimination des interfaces propriétaires. Le projet a préservé un processus cohérent de collecte de preuves malgré leur présence. Cette approche est moins élégante qu’un modèle commun et souvent plus immédiatement utile pour les environnements anciens. Le dépôt devient le point de comparaison, tandis que le module consigne les compromis nécessaires pour y parvenir.
La normalisation sépare les changements significatifs des sorties qui varient à chaque exécution
Les sorties des équipements réseau contiennent des valeurs inutiles dans un diff de configuration parce qu’elles changent continuellement. La durée de fonctionnement, les horodatages, les compteurs, les identifiants de session et les données cryptographiques générées peuvent faire paraître chaque collecte différente. RANCID filtre ou masque certains champs afin que le dépôt enregistre des changements interprétables par un opérateur.
La normalisation transforme les sorties brutes des commandes en preuves opérationnelles. Sans elle, un courriel quotidien pourrait contenir des centaines de lignes modifiées uniquement parce que le temps s’est écoulé. Les ingénieurs cesseraient de le lire. En supprimant les champs volatils et en uniformisant les sorties, le système fait ressortir une modification de politique tenant en une seule ligne.
La décision de filtrage constitue aussi un pouvoir de sélection. Un champ supprimé parce qu’il est considéré comme du bruit ne peut plus contribuer à une analyse ultérieure. Une empreinte de mot de passe peut être masquée pour des raisons de sécurité, mais sa modification peut prouver que les identifiants ont été renouvelés. Un horodatage peut sembler inutile jusqu’à ce qu’il révèle un redémarrage. Un identifiant dynamique peut distinguer un processus habituel d’un processus inattendu.
Le bon filtre dépend de la finalité de l’archive. Un dépôt de conformité peut privilégier la stabilité du texte de politique et une suppression stricte des secrets. Un système d’investigation d’incident peut conserver davantage de contexte dans un emplacement protégé. Certaines organisations peuvent maintenir des sorties distinctes ou compléter RANCID par des journaux et de la télémétrie.
La normalisation peut échouer lorsque la syntaxe d’un fournisseur change. Une expression régulière écrite pour un format donné peut supprimer trop d’informations ou ne pas masquer un secret. La vérification doit donc porter sur le résultat filtré et, lorsque cela peut être fait en sécurité, sur des essais réalisés à partir de sorties brutes représentatives. Un diff propre ne prouve pas qu’aucune donnée importante n’a été écartée.
Cette tension est au cœur de tout système d’observabilité. Une preuve utile est rarement brute. Elle est sélectionnée, transformée et étiquetée. RANCID rend cette transformation visible dans son code et ses modules. L’opérateur responsable sait ce qui a été retiré et ne confond pas un dépôt silencieux avec un compte rendu complet de l’état des équipements.
La gestion de versions donne une chronologie au texte de configuration, mais pas un historique des transactions
RANCID utilisait initialement CVS, puis a pris en charge Subversion et Git. La gestion de versions apporte un historique durable, des diffs, des horodatages et un mécanisme familier de réplication ou de sauvegarde. Elle transforme un répertoire de fichiers actuels en une succession d’états observés.
Un enregistrement peut montrer que le collecteur a vu une configuration le lundi et une autre le mardi. Il peut identifier les lignes différentes et permettre une comparaison avec la période d’une panne. Les branches et les copies distribuées de Git peuvent améliorer la résilience et l’intégration. Les outils du dépôt peuvent appliquer des politiques d’accès et de conservation.
L’enregistrement dans le dépôt n’est pas la transaction effectuée sur l’équipement. Son auteur peut être le compte de service RANCID plutôt que l’ingénieur ayant modifié le réseau. Son horodatage correspond à la collecte ou à l’enregistrement, pas nécessairement à l’exécution de la commande. Plusieurs modifications peuvent être regroupées dans un seul diff. Un changement appliqué puis annulé entre deux collectes peut ne jamais apparaître.
Le dépôt peut également conserver indéfiniment des données sensibles. Retirer un secret du fichier actuel ne le supprime pas de l’historique. La réécriture de l’historique est perturbatrice et peut laisser des copies ailleurs. L’analyse des secrets, les contrôles d’accès et un filtrage rigoureux dans les modules sont nécessaires avant d’enregistrer les configurations d’un grand parc.
L’intégrité du dépôt est importante. Un attaquant qui compromet le collecteur peut modifier les fichiers actuels ou l’historique, supprimer des diffs ou insérer de fausses preuves. Des miroirs distants, des enregistrements signés ou des sauvegardes immuables peuvent renforcer la confiance, mais chacun exige un modèle de menace. Une gestion de versions ordinaire consigne les changements; elle ne prouve pas automatiquement l’authenticité du relevé.
La durée de conservation doit répondre aux exigences opérationnelles et juridiques. Un long historique peut révéler des dérives récurrentes et apporter des preuves d’audit. Il augmente aussi l’exposition et le stockage nécessaires. Une entreprise doit décider de la quantité d’historique dont elle a besoin ainsi que de la manière de le protéger ou de le supprimer.
Le recours de RANCID à la gestion de versions s’est révélé durable sur le plan stratégique, car il réutilise un outil généraliste au lieu d’inventer une archive propriétaire. Le même dépôt peut être inspecté avec des commandes standard et intégré à d’autres processus. Sa signification reste circonscrite: il s’agit d’une chronologie du texte collecté, non d’un registre garanti de chaque action réseau.
La collecte périodique laisse un intervalle dans lequel le changement le plus important a pu survenir
La principale limite de RANCID est temporelle. Il voit des instantanés. Si un équipement est interrogé toutes les heures, cinquante-neuf minutes d’activité peuvent se dérouler entre deux observations. Un changement nuisible peut être introduit, provoquer une perturbation puis être supprimé avant l’exécution du collecteur. Le dépôt ne montrera aucune différence, alors même que le réseau aura subi un événement réel.
Augmenter la fréquence réduit cet intervalle, mais accroît la charge. Se connecter à de nombreux équipements, exécuter des commandes et traiter les sorties consomme du processeur, de la bande passante de gestion et des ressources sur les équipements. Certaines plateformes gèrent mal les sessions simultanées. Le collecteur doit équilibrer rapidité d’observation et stabilité.
Les échecs de collecte élargissent l’intervalle de façon imprévisible. Un incident de routage peut isoler le chemin de gestion au moment même où les preuves de configuration seraient les plus utiles. Une modification de l’authentification peut bloquer l’accès. Une commande lente peut dépasser le délai prévu. Un équipement soumis à une forte charge peut renvoyer une sortie partielle. L’absence d’un nouvel enregistrement doit être distinguée de la confirmation qu’aucun changement n’a eu lieu.
Les systèmes déclenchés par événement ou alimentés en continu peuvent compléter les instantanés périodiques. Les journaux d’audit des équipements peuvent consigner les commandes et les utilisateurs. Les plateformes d’automatisation peuvent enregistrer les changements prévus. La télémétrie peut montrer l’état de fonctionnement. Les contrôleurs peuvent exposer les résultats des transactions. Aucun de ces mécanismes ne remplace automatiquement l’instantané indépendant. Chacun observe une couche différente et peut échouer par une voie différente.
L’intervalle affecte aussi la restauration. Un ancien fichier RANCID peut fournir un texte de référence, mais le réinjecter sans vérification peut être dangereux. Le logiciel, le matériel ou les dépendances environnantes de l’équipement peuvent avoir changé. L’instantané peut contenir des valeurs générées ou des secrets. L’organisation doit l’utiliser comme preuve dans un processus de reprise vérifié, et non comme une vérité exécutable automatiquement, sauf si elle a conçu et testé ce fonctionnement.
La valeur de RANCID augmente lorsque ses angles morts sont mesurés. Les opérateurs peuvent enregistrer l’heure de la dernière réussite, l’intervalle d’interrogation, l’achèvement des commandes et l’état de l’enregistrement dans le dépôt. Ils peuvent comparer les instantanés avec les demandes de changement et les journaux d’audit des équipements. L’absence d’un diff attendu devient alors un signal indiquant que la collecte ou le relevé du changement est incomplet.
L’observation périodique n’est pas exhaustive, mais elle est indépendante. C’est cette indépendance qui maintient l’utilité de l’outil aux côtés de systèmes promettant un contrôle en temps réel.
L’hôte RANCID peut exposer tout un plan de gestion
Les archives de configuration sont des cibles attrayantes, car elles réunissent accès et connaissance. Le collecteur connaît les noms, adresses, types et identifiants des équipements. Les fichiers révèlent les interfaces, les relations de routage, les listes d’accès, les chaînes de communauté, les empreintes, les clés et les commentaires. Une compromission peut accélérer la reconnaissance et ouvrir une voie vers une prise de contrôle active.
L’hôte doit donc être placé dans un environnement de gestion restreint et proposer un minimum de services. Lorsque les plateformes le permettent, les administrateurs doivent séparer les comptes de collecte des comptes opérationnels capables d’écrire. Les lecteurs du dépôt ne doivent pas recevoir automatiquement les identifiants de connexion aux équipements. Les sauvegardes et les miroirs doivent être chiffrés et soumis à des contrôles d’accès.
Les secrets exigent une attention particulière. Le masquage dans les sorties collectées est utile, mais ne peut être présumé complet pour tous les modules fournisseurs. Une nouvelle sortie de commande peut introduire des champs que le filtre ne reconnaît pas. Des adaptations locales peuvent contourner les protections amont. Une analyse automatisée des secrets peut aider, même si elle produit parfois de faux positifs et ne remplace pas la vérification de la conception.
Les fichiers d’identifiants tels que.cloginrcreposent fortement sur la protection du système de fichiers. Des utilisateurs locaux, des agents de sauvegarde ou des outils d’assistance peuvent obtenir un accès non prévu. Le transfert des identifiants vers un système spécialisé de gestion des secrets peut améliorer le contrôle si l’intégration reste fiable. Quel que soit le mécanisme retenu, l’organisation doit gérer le renouvellement, la responsabilité et les preuves d’utilisation.
La sécurité réseau peut entrer en conflit avec la compatibilité. Les anciens équipements peuvent ne prendre en charge que des algorithmes SSH faibles ou Telnet. Activer ces protocoles sur un collecteur généraliste élargit le risque. Des hôtes de compatibilité isolés, des systèmes de rebond ou un remplacement accéléré des équipements peuvent être plus sûrs que l’affaiblissement d’une plateforme centrale. La valeur opérationnelle des preuves historiques doit être comparée au coût du maintien de chemins de gestion non sécurisés.
L’intégrité et la disponibilité du dépôt doivent aussi faire partie du modèle de menace. Un rançongiciel ou une action d’administration destructrice peut effacer l’historique nécessaire à la reprise. Une copie hors ligne ou immuable peut protéger les preuves. Les journaux d’audit doivent consigner les accès et les opérations inhabituelles sur le dépôt. La configuration du collecteur lui-même doit être versionnée et sauvegardée séparément des données d’équipement qu’il recueille.
La simplicité de RANCID peut le rendre plus facile à sécuriser qu’une vaste suite de gestion, mais simplicité ne signifie pas isolement. Son service étroit se trouve à une jonction privilégiée. Le traiter comme un simple serveur utilitaire revient à ignorer la valeur qu’il concentre.
LibreNMS apporte le symptôme; RANCID, le contexte de configuration
LibreNMS et RANCID apparaissent souvent ensemble parce qu’ils répondent à des questions complémentaires. LibreNMS interroge les compteurs, les états et les capteurs au fil du temps. RANCID collecte le texte de configuration et enregistre les différences. Une alerte de surveillance peut montrer quand l’accessibilité, les erreurs ou le trafic ont changé; le dépôt de configurations peut indiquer si le texte d’un équipement a évolué à proximité de cet événement.
L’intégration ne fusionne pas les preuves en une vérité unique. Les intervalles d’interrogation diffèrent. Une alerte LibreNMS peut précéder une collecte RANCID. RANCID peut ne pas parvenir à se connecter alors que SNMP continue de fonctionner, ou inversement. Un changement de configuration peut être légitime et sans rapport avec le symptôme. La corrélation resserre l’enquête; elle ne prouve pas la causalité.
L’inventaire partagé des équipements peut également dériver. Un équipement peut exister dans LibreNMS mais pas dansrouter.db. Les noms et les adresses peuvent différer. Les identifiants et les permissions peuvent être gérés séparément. Une intégration doit signaler une configuration absente ou ancienne plutôt que d’afficher silencieusement le dernier fichier.
Les frontières de sécurité exigent de l’attention. Afficher une configuration dans une interface de surveillance peut exposer du texte sensible à des utilisateurs qui n’avaient auparavant accès qu’aux graphiques. La conception des rôles doit distinguer la visibilité opérationnelle de l’accès aux configurations. Selon le modèle d’accès, créer des liens vers un dépôt peut être plus sûr que copier chaque fichier dans une autre base de données.
Le processus combiné est particulièrement efficace après un changement. Une interface tombe; LibreNMS consigne l’événement et son historique; RANCID montre une configuration modifiée; un système de référence indique ce qui était prévu; une plateforme de changement montre l’approbation et l’auteur. Aucun outil ne fournit à lui seul ces quatre relevés.
Ce modèle en couches illustre pourquoi les outils spécialisés à code source ouvert perdurent. Une plateforme généraliste peut intégrer les données, mais un collecteur indépendant peut préserver des preuves lorsque son propre processus de changement a été contourné. Aux côtés de LibreNMS, la valeur de RANCID vient de son maintien en tant que voie d’observation distincte.
GitOps et les systèmes de référence définissent l’intention; RANCID enregistre la réponse de l’équipement
L’automatisation réseau moderne stocke la configuration prévue dans un système de gestion de versions, modélise l’inventaire et les politiques dans des systèmes tels que NetBox ou Nautobot, puis utilise des outils comme Ansible ou NAPALM pour produire, valider et déployer les changements. Dans ce contexte, RANCID peut sembler redondant. Si Git contient déjà la configuration, pourquoi la récupérer depuis l’équipement?
Parce que l’état prévu et l’état observé peuvent diverger. Une commande d’urgence peut contourner l’automatisation. Un déploiement partiel peut échouer sur un équipement. Un fournisseur peut normaliser ou produire la configuration différemment. Une personne peut effectuer une modification pendant un dépannage puis oublier de la rapprocher du référentiel. Le dépôt source peut rester parfait alors que le réseau ne l’est pas.
RANCID fournit une voie de retour indépendante. Il demande à l’équipement ce qu’il déclare actuellement et consigne la réponse. La comparaison de cette réponse avec l’intention produite peut révéler une dérive. Le processus peut mettre au jour des faiblesses de l’automatisation, de l’inventaire ou du contrôle des changements, plutôt que de simplement qualifier l’équipement de non conforme.
L’instantané reste dépourvu de sémantique. Une comparaison textuelle peut signaler un ordre sans importance ou des valeurs générées. Elle peut manquer une différence de comportement exprimée en dehors des commandes collectées. Les API structurées et les données pilotées par des modèles peuvent améliorer la comparaison lorsqu’elles sont prises en charge. RANCID demeure utile dans les parcs hétérogènes précisément parce qu’il accepte le texte lorsque les données structurées ne sont pas disponibles.
GitOps soulève également ses propres questions d’autorité. Un enregistrement Git consigne le changement prévu, mais le comportement en production dépend des chaînes d’automatisation, des identifiants, des réponses des équipements et des contournements humains. Le dépôt RANCID enregistre un autre maillon de cette chaîne. Les deux historiques ne doivent ni être fusionnés ni pouvoir s’écraser mutuellement.
Un processus mature peut traiter RANCID comme un contrôle de détection. Les changements approuvés vont de l’intention vers les équipements. Les configurations collectées reviennent et sont comparées. Les différences inattendues déclenchent un examen. Le collecteur ne devient pas le moteur de déploiement, ce qui préserve son indépendance.
Le point stratégique est que l’automatisation accroît le besoin de preuves au lieu de le supprimer. Plus les changements se propagent rapidement, plus il est important de savoir ce qui a réellement atteint chaque équipement. L’ancien modèle de diff textuel de RANCID peut encore remplir ce rôle lorsque ses limites sont comprises.
Oxidized et les gestionnaires commerciaux modernisent le processus sans supprimer le problème d’origine
Oxidized est une solution de remplacement à code source ouvert bien connue, qui collecte elle aussi les configurations des équipements réseau grâce à une logique propre aux modèles et conserve les versions, généralement dans Git. Son architecture et ses intégrations peuvent convenir différemment aux environnements modernes, et de nombreux opérateurs l’utilisent avec LibreNMS. RANCID reste la référence historique de cette catégorie.
Les gestionnaires commerciaux de configurations réseau ajoutent la découverte, des règles de conformité, des processus d’approbation, l’automatisation des changements, la prise en charge des fournisseurs et la production de rapports. Ils peuvent offrir des contrats de service et une expérience utilisateur plus intégrée. Ils introduisent aussi des coûts de licence, des modèles de données propriétaires et une dépendance à la couverture des équipements ainsi qu’à la feuille de route d’un fournisseur.
Les cadres d’automatisation peuvent récupérer un état structuré ou déployer des changements. Les contrôleurs peuvent maintenir la politique prévue. Les systèmes intégrés aux équipements peuvent consigner l’historique des commandes. Ces capacités recouvrent certaines fonctions de RANCID, mais n’éliminent pas la question centrale: existe-t-il un relevé indépendant et durable de ce que l’équipement a déclaré au fil du temps?
Le choix n’est pas binaire. Une organisation peut utiliser un gestionnaire commercial pour les processus, Git pour l’état prévu, la télémétrie en continu pour les preuves de fonctionnement, et RANCID ou Oxidized pour les instantanés indépendants. L’architecture doit éviter de dupliquer inutilement les identifiants et définir quel relevé répond à quelle question.
Les avantages de RANCID sont sa maturité, sa transparence, ses besoins modestes en ressources et sa compatibilité avec le texte ainsi qu’avec les outils standard de gestion de versions. Ses inconvénients sont la fragilité des interfaces en ligne de commande, l’inventaire manuel, la gouvernance formelle limitée, la concentration du risque de sécurité et une expérience utilisateur façonnée par des scripts plutôt que par un produit moderne. Ces compromis sont explicites et souvent acceptables dans les parties d’un réseau que les plateformes récentes couvrent mal.
La présence persistante du projet ne prouve pas l’échec de l’automatisation réseau. Elle montre que les systèmes d’automatisation ont toujours besoin d’une mémoire externe. Plus la chaîne de gestion de l’état prévu devient sophistiquée, plus une observation simple et indépendante peut être utile lorsque les hypothèses de cette chaîne sont mises en doute.
Les diffs envoyés par courriel transforment les changements du dépôt en processus humain
Le modèle d’exploitation traditionnel de RANCID ne s’arrête pas à l’enregistrement dans le dépôt. Un changement peut produire un courriel contenant le diff et placer directement les preuves de configuration dans le processus de travail des ingénieurs réseau. Le mécanisme est suffisamment simple pour survivre aux changements de systèmes de tickets et de tableaux de bord. Il montre aussi la différence entre notification et réponse.
Un diff utile est concis, attribuable à un équipement et transmis à des personnes capables d’en comprendre les conséquences. La normalisation favorise cet objectif en supprimant le bruit habituel. Les groupes peuvent orienter les changements vers l’équipe appropriée. Les liens vers le dépôt peuvent fournir un contexte plus large. Un changement programmé peut être reconnu rapidement; une ligne inattendue peut déclencher une enquête avant le prochain incident.
Le même canal peut perdre son efficacité sous l’effet du volume. Les changements planifiés de grande ampleur produisent de longs messages. Les champs volatils ayant échappé au filtrage créent un bruit répété. Un équipement instable peut envoyer les mêmes variations à chaque cycle. Les ingénieurs créent des règles de messagerie, cessent de lire et finissent par manquer précisément le changement que le système devait révéler. La fatigue liée aux alertes ne concerne pas uniquement les plateformes de surveillance; un flux de diffs peut subir le même échec.
La politique de notification doit donc être conçue. Les opérations de maintenance prévues peuvent être rapprochées des changements attendus. Les diffs très volumineux peuvent être résumés avec un lien vers le dépôt, tout en conservant le relevé complet. Les échecs répétés de collecte doivent être distingués des changements de configuration. Les équipes peuvent mesurer les événements non lus ou non acquittés au lieu de supposer que l’envoi équivaut à une vérification.
Le courriel crée également un risque de fuite de données. Un diff de configuration peut contenir des adresses internes, des références clients ou un secret que le filtrage n’a pas supprimé. Les listes de diffusion et leurs archives peuvent être accessibles plus largement que le dépôt. Un transfert peut déplacer les preuves hors de l’environnement de gestion. Certaines organisations préféreront des intégrations avec des systèmes de tickets ou de messagerie dotés de contrôles d’accès plus stricts, même si ces systèmes introduisent leurs propres jetons et politiques de conservation.
La caractéristique importante n’est pas le courriel lui-même. C’est la transformation d’un événement du dépôt en étape opérationnelle assortie d’une responsabilité. Qui doit vérifier le diff? Dans quel délai? Qu’est-ce qui rend un changement autorisé? Où la décision est-elle consignée? RANCID fournit un déclencheur; l’organisation doit le transformer en contrôle.
Un processus mature reconnaît également que l’absence de message ne constitue pas une preuve de bon fonctionnement. Si le collecteur ou le système de messagerie tombe en panne, le silence peut ressembler à de la stabilité. Des changements synthétiques, des notifications de test et des tableaux de bord de fraîcheur peuvent vérifier toute la chaîne entre l’équipement et la personne. Le diff d’une ligne n’a de valeur que si quelqu’un peut avoir confiance dans l’arrivée des lignes importantes.
La fonction de consultation diagnostique montre pourquoi l’accès en lecture doit lui aussi être délimité
RANCID a historiquement inclus une fonction de consultation permettant à certains utilisateurs d’exécuter des commandes de diagnostic limitées depuis une interface web. L’idée est séduisante sur le plan opérationnel: le personnel d’assistance ou des utilisateurs externes peuvent inspecter les routes et l’accessibilité sans recevoir un accès illimité aux équipements. Cette fonction transforme l’automatisation de connexion existante en service de diagnostic contrôlé.
La frontière de sécurité est délicate. Une commande apparemment limitée à la lecture peut révéler les tables de routage, les voisins, les interfaces, les adresses et les politiques. Les entrées utilisateur doivent être contraintes afin d’empêcher toute exécution arbitraire dans l’interface en ligne de commande. L’application web, la liste des commandes autorisées, les identifiants des équipements et le traitement des sorties forment une seule chaîne de confiance. Une faille à n’importe quel point peut transformer un outil de diagnostic pratique en accès au plan de gestion.
Même une sortie correctement limitée peut être sensible. Une vue publique des routes est différente d’une topologie interne ou d’informations propres aux clients. Les opérateurs doivent décider quels équipements et quelles commandes conviennent à chaque public. La limitation du débit et la journalisation peuvent réduire les abus. Une séparation avec le collecteur principal peut limiter les conséquences d’une compromission de l’interface web.
Cette fonction illustre également un point plus général concernant RANCID: les identifiants de collecte peuvent servir à d’autres services que l’archivage, ce qui augmente à la fois leur utilité et le risque. Réutiliser le même chemin privilégié pour un trop grand nombre de fonctions agrandit la surface d’attaque du collecteur. Un compte de service étroit et un compte de diagnostic distinct peuvent être plus sûrs, même s’ils demandent davantage d’administration.
Les serveurs de routes modernes et les plateformes d’observabilité peuvent fournir des vues similaires au moyen d’API et d’interfaces dédiées. Cela ne rend pas la fonction historique sans intérêt; cela clarifie la question de conception. L’accès en lecture est une autorité qui doit être limitée, surveillée et justifiée. L’absence de commandes de configuration ne rend pas les informations inoffensives.
Un profil de RANCID ne doit pas traiter cette fonction de consultation comme l’identité principale du projet, mais elle aide à expliquer sa culture opérationnelle. Le système est issu d’une pratique pragmatique des réseaux, dans laquelle les ingénieurs avaient besoin de moyens d’inspecter et de préserver l’état des équipements au moyen des interfaces disponibles. Chaque commodité créait une frontière de gestion que les opérateurs locaux devaient faire respecter.
La pérennité repose sur un petit projet de référence et de nombreux déploiements invisibles
RANCID est un logiciel à code source ouvert plutôt qu’une entreprise classique publiant son chiffre d’affaires, ses effectifs et l’organisation de son assistance client. Le projet de référence est maintenu par Shrubbery Networks et des contributeurs. Les informations publiques ne fournissent ni recensement actuel complet des responsables de maintenance, ni budget, ni plan de succession.
Cette forme crée à la fois résilience et fragilité. Le code peut être téléchargé, inspecté, modifié et maintenu en fonctionnement sans renouvellement de licence. Les opérateurs peuvent continuer d’entretenir des modules locaux après qu’un fournisseur ou un consultant a cessé de s’intéresser à un équipement. Le projet ne dépend pas d’une décision commerciale unique visant à interrompre un produit sur abonnement.
Dans le même temps, la disponibilité du code ne crée pas de capacité de vérification. Les modules d’équipement doivent être mis à jour. Les problèmes de sécurité exigent des diagnostics et des versions correctives. La documentation et les systèmes de construction vieillissent. Quelques personnes peuvent porter un savoir dont dépendent des milliers d’installations, sans que celles-ci soient visibles ni qu’elles apportent des ressources au projet amont.
Les paquets distribués en aval peuvent aider en adaptant RANCID aux systèmes d’exploitation et en diffusant des corrections. Ils peuvent aussi créer des retards ou des divergences. Une version empaquetée peut être en retard sur la version de référence. Des correctifs locaux peuvent ne jamais revenir vers le projet amont. Une organisation peut penser qu’elle « utilise RANCID » tout en exécutant une branche au comportement sensiblement différent.
L’économie se situe principalement hors du projet. Les utilisateurs paient les hôtes de collecte, le stockage, les sauvegardes et le temps des ingénieurs. Des consultants peuvent tirer des revenus du déploiement ou de l’assistance. Le projet crée de la valeur en accélérant les investigations et en préservant les configurations, mais cette valeur n’apparaît pas dans des revenus audités du projet. Une faible charge de maintenance peut soutenir d’importants actifs en aval sans mécanisme de financement équivalent.
La pérennité doit donc être suivie au moyen des versions publiées, des réponses de sécurité, de l’activité des contributeurs, de la documentation et de la santé de la distribution de référence. Les grands utilisateurs peuvent réduire le risque en apportant des corrections, des sorties de test, des financements ou des responsables de maintenance, plutôt qu’en traitant le projet comme un utilitaire figé. Ils doivent aussi conserver un plan de sortie: le format du dépôt est portable, mais la logique locale de collecte et les identifiants peuvent ne pas l’être.
L’absence de fondation formelle ou de fournisseur dominant n’est pas nécessairement un défaut. Elle signifie toutefois qu’aucun organisme central ne peut garantir une feuille de route. Les organisations dépendant de RANCID doivent décider de la part de responsabilité qu’elles internalisent et des relations externes suffisamment fiables pour les soutenir.
Une migration doit préserver les preuves, pas seulement remplacer le collecteur
Lorsque des organisations passent de RANCID à Oxidized, à un gestionnaire commercial ou à une plateforme fondée sur des contrôleurs, la tâche évidente consiste à collecter les configurations actuelles dans le nouveau système. La tâche la plus difficile est de préserver la signification de l’archive historique. Des années de diffs peuvent être utiles lors d’un audit, d’un contentieux, d’un examen d’incident ou pour reconstituer les raisons d’une ancienne conception.
Un plan de migration doit préserver l’historique du dépôt, les horodatages, l’identité des équipements et les contrôles d’accès. Si les noms de fichiers ou d’hôtes changent, une table de correspondance est nécessaire pour comparer les anciens et les nouveaux relevés. La politique de conservation des secrets doit être réexaminée avant de copier l’historique vers une nouvelle plateforme. Des données protégées dans un dépôt Git local peuvent devenir plus largement visibles après leur transfert dans une application web.
L’équivalence de la collecte doit aussi être testée. Le nouvel outil peut exécuter des commandes différentes ou normaliser autrement les sorties. Une migration propre peut sembler modifier chaque ligne en raison d’un changement de format. À l’inverse, un modèle présenté comme équivalent peut omettre des commandes que RANCID collectait. Des exécutions parallèles apportent des preuves sur la couverture, la fraîcheur et le comportement en cas d’échec avant la mise hors service de l’ancien collecteur.
Les identifiants ne doivent pas être copiés automatiquement. La migration offre l’occasion de réduire les privilèges, de remplacer les secrets partagés, d’adopter des algorithmes SSH plus robustes et de segmenter les équipements. Les matériels anciens qui ne respectent pas la nouvelle politique peuvent nécessiter un collecteur isolé ou un plan de retrait accéléré.
L’ancien dépôt ne doit pas rester en ligne indéfiniment sans responsable. S’il est conservé, il exige des sauvegardes, des mises à jour de sécurité et une révision des accès. S’il est archivé, l’organisation doit savoir comment le lire et en vérifier l’intégrité. Un répertoire compressé que personne ne sait interpréter ne constitue pas une preuve préservée.
Cette discipline de migration renforce la leçon générale de RANCID. L’actif durable n’est pas seulement le script ou l’interface. C’est une succession fiable d’observations, accompagnée de la connaissance de leur mode de production. Remplacer le collecteur tout en supprimant la provenance peut rendre un système moderne moins utile que l’ancien.
Le recours de RANCID au texte ordinaire et à la gestion de versions facilite cette démarche, car les données ne sont pas enfermées dans une base propriétaire. La portabilité ne reste toutefois qu’une possibilité tant que l’organisation ne documente pas les modules, les filtres, les calendriers, les correspondances entre équipements et les limites du relevé.
Le texte de configuration n’est pas synonyme de comportement réseau
Un routeur peut présenter une configuration apparemment correcte tout en se comportant de manière inattendue. Les routes dépendent de l’état des voisins, des annonces reçues, des temporisateurs, des ressources matérielles, des défauts logiciels et des politiques appliquées ailleurs. Une liste d’accès peut exister dans le texte tout en étant associée à la mauvaise interface. Une route map peut être correcte isolément, mais agir sur des données ayant changé hors de l’équipement. RANCID préserve une couche importante, non l’ensemble du système de transmission.
Cette frontière est importante pendant le diagnostic. Un diff proche de l’incident constitue une preuve à examiner, mais la proximité temporelle ne prouve pas la cause. Les ingénieurs doivent comparer l’état opérationnel: tables de routage, état des adjacences, compteurs d’interfaces, journaux et télémétrie. Ils doivent déterminer si la commande modifiée était active, si elle s’est propagée et si un autre système a produit le même symptôme.
Le cas inverse se produit également. Le comportement peut changer sans diff de configuration. Une liaison tombe. Un voisin annonce une route différente. Un certificat expire. Une table matérielle se remplit. Un processus redémarre et choisit un nouveau chemin à partir d’une politique inchangée. Un système de surveillance ou de télémétrie est nécessaire pour observer ces événements. RANCID ne doit pas être critiqué pour ne pas enregistrer un état qu’il n’a pas été conçu pour collecter.
Certains modules fournisseurs incluent des commandes opérationnelles en plus de la configuration, ce qui peut aider. Ce choix doit être documenté, car il modifie la signification de l’archive et son niveau de bruit. Un instantané de table de routage peut être volumineux et volatil. Le stocker périodiquement peut faciliter les comparaisons tout en consommant de l’espace et en produisant des diffs qui masquent les changements de configuration.
Les modèles d’état structurés peuvent améliorer le raisonnement, mais ils nécessitent eux aussi une prise en charge par les fournisseurs et une sémantique rigoureuse. Le texte reste utile parce qu’il est proche de ce que voient les ingénieurs et peut être inspecté avec des outils ordinaires. L’architecture la plus solide utilise les deux lorsque c’est possible: télémétrie structurée pour le comportement actuel, instantanés de configuration pour la politique déclarée par l’équipement et systèmes d’intention pour la conception approuvée.
Cette séparation protège contre une erreur d’analyse courante. Une archive de configurations ne prouve pas la conformité simplement parce que des fichiers existent, et un réseau actif ne prouve pas la qualité de la configuration uniquement parce que le trafic circule. Les preuves issues des différentes couches doivent être comparées. RANCID mérite sa place en rendant l’une de ces couches suffisamment durable pour participer à cette comparaison.
La valeur d’audit dépend de la provenance, de la conservation et de la capacité à expliquer le collecteur
L’historique des configurations peut soutenir le contrôle interne, l’audit externe et l’examen des incidents, mais un dépôt n’est pas automatiquement un système d’audit. Les auditeurs et les enquêteurs doivent savoir quels équipements entraient dans le périmètre, à quelle fréquence ils étaient collectés, quelles commandes étaient exécutées, quels champs étaient filtrés et comment l’accès à l’archive était contrôlé.
La provenance commence par la configuration du collecteur.router.db, les définitions de groupes, les règles de connexion et les modules fournisseurs déterminent les preuves. Ces fichiers doivent être versionnés et vérifiés. La modification d’un filtre peut transformer tous les futurs instantanés. La modification d’un calendrier peut élargir les intervalles sans observation. La modification des identifiants peut retirer silencieusement une partie du parc.
Le temps constitue une autre dépendance. Les horodatages du dépôt, les horloges des équipements, les tickets et les journaux d’identité doivent être suffisamment alignés pour reconstituer une séquence. L’heure d’enregistrement n’est pas nécessairement celle du changement réseau. Les enquêteurs doivent préserver cette distinction au lieu de créer une fausse précision.
La conservation nécessite une règle explicite. Garder chaque configuration indéfiniment peut exposer d’anciens secrets ainsi que des informations personnelles ou relatives aux clients. Supprimer trop rapidement l’historique peut éliminer le seul relevé permettant d’expliquer une politique de routage ancienne. Différentes catégories d’équipements ou de données peuvent exiger des durées différentes. Les obligations juridiques et réglementaires varient selon l’organisation et la juridiction.
Des contrôles d’intégrité peuvent renforcer le relevé. Des miroirs distants, des sauvegardes restreintes en ajout uniquement, des enregistrements signés ou un horodatage externe peuvent rendre les modifications non autorisées plus difficiles. Aucun de ces moyens n’est utile si les clés, les miroirs et les collecteurs dépendent du même administrateur ou système de stockage compromis. Le degré d’indépendance doit correspondre à la menace traitée.
Un audit a également besoin de preuves négatives. L’organisation doit signaler les échecs de collecte, les équipements absents et les périodes pendant lesquelles l’archive n’était pas fiable. Masquer ces lacunes transforme un relevé partiel en relevé trompeur. Une succession propre d’enregistrements ne peut pas couvrir un équipement que le collecteur ne pouvait pas atteindre.
La question centrale consiste à savoir si une autre personne qualifiée pourra reproduire la signification du relevé après le départ de l’administrateur d’origine. Si les modules, les filtres et les calendriers ne sont pas documentés, le dépôt peut conserver le texte tout en perdant son interprétation. La simplicité de RANCID aide, mais c’est la gouvernance qui transforme cette simplicité en preuve fiable.
Les équipements anciens entretiennent le besoin d’une compatibilité ciblée
Le matériel réseau reste souvent en service plus longtemps que la mode de gestion sous laquelle il a été acheté. Un commutateur peut continuer à transmettre le trafic de manière fiable après le passage de son fournisseur à un autre contrôleur, à un autre modèle de licence ou à une autre API. Son remplacement peut exiger des investissements, des fenêtres d’interruption et des changements dans les systèmes dépendants. Les opérateurs maintiennent donc des parcs mixtes dans lesquels les nouveaux équipements prennent en charge une télémétrie structurée, tandis que les plus anciens ne proposent qu’une interface en ligne de commande et SNMP.
RANCID correspond à cette réalité parce que son exigence fondamentale est modeste: une session de gestion accessible et un module capable de récupérer du texte utile. Il peut préserver l’historique d’équipements auxquels les nouvelles plateformes ne prêtent plus attention. Cette capacité est précieuse dans les campus, les services publics, les périphéries de réseaux de fournisseurs de services et d’autres environnements où les infrastructures vieillissent de façon inégale.
Ce bénéfice ne doit pas servir d’excuse à une dette technique indéfinie. Les anciens accès peuvent exiger des chiffrements obsolètes, des mots de passe partagés ou Telnet. Les logiciels des fournisseurs peuvent contenir des vulnérabilités non corrigées. Les pièces de rechange et la documentation disparaissent. Un collecteur peut rendre l’équipement suffisamment administrable pour retarder son retrait, tout en consignant les preuves nécessaires à une migration plus sûre.
Les organisations doivent classer les exceptions de compatibilité. Un équipement ancien peut être isolé derrière un collecteur et un chemin de gestion dédiés. Les identifiants peuvent être restreints. Le dépôt peut montrer si sa configuration change réellement. La priorité de remplacement peut tenir compte de l’exposition et de l’importance métier plutôt que du seul âge.
Cette approche sépare préservation et approbation. La capacité de RANCID à collecter une ancienne plateforme ne signifie pas que celle-ci reste sûre ou stratégiquement souhaitable. Elle signifie que l’organisation peut conserver de la visibilité tout en décidant comment et quand la retirer.
Il est donc impossible de mesurer l’empreinte mondiale de RANCID à partir d’une carte unique des services. Le logiciel fonctionne dans des réseaux contrôlés indépendamment, souvent précisément parce que ceux-ci contiennent des équipements qui ne peuvent pas être confiés à une plateforme gérée centralement. Sa portée est inscrite dans des dépôts locaux, des installations de paquets et des scripts que le projet amont peut ne jamais voir.
Cette invisibilité complique la pérennité, mais renforce la raison d’être du projet. Les infrastructures réseau regorgent d’actifs dont la vie opérationnelle dépasse la vie commerciale de leurs outils de gestion. Un collecteur simple peut combler cet écart, à condition d’être employé comme contrôle temporaire autour de limites connues, et non comme autorisation de les oublier.
Un outil ciblé peut survivre à plusieurs modes de gestion
Le site de référence de RANCID est celui de Shrubbery Networks. À la date de clôture de la recherche, il indiquait la version 3.14, et l’archive publique des versions datait la branche 3.14 de 2025. Il existe des miroirs et des paquets en aval, mais le site de référence doit servir de base aux affirmations sur les versions et la gouvernance, sauf indication contraire du projet.
Le projet ne publie ni nombre audité d’installations, ni budget, ni recensement complet des responsables de maintenance, ni matrice universelle de prise en charge des équipements. Son échelle est donc difficile à mesurer. Sa longévité et la disponibilité de paquets montrent une pertinence persistante, mais n’établissent pas une part de marché. De nombreux déploiements peuvent être anciens, modifiés localement ou invisibles pour les responsables amont.
Cette opacité est fréquente dans les petits projets d’infrastructure. Le logiciel peut être profondément intégré sans produire de relevé commercial clair. Le travail de maintenance peut être bénévole, financé par un employeur ou soutenu par des missions de conseil. Les utilisateurs bénéficient du temps d’incident évité et des preuves conservées, mais cette valeur n’apparaît pas dans les revenus du projet.
La pérennité dépend de la succession et du travail de compatibilité. Les nouveaux logiciels d’équipement modifient les invites et les sorties. Les anciens appareils exigent une prise en charge historique. Les attentes de sécurité évoluent. Les systèmes de gestion de versions et les dépendances des systèmes d’exploitation changent. Un outil ciblé peut rester stable, mais cette stabilité exige toujours des vérifications et des publications.
Le périmètre de RANCID le protège de certaines pressions du marché. Il n’a pas besoin de devenir une plateforme complète d’observabilité. Il peut continuer à collecter du texte tant que les équipements exposent un texte utile. Le risque est que le projet soit facile à ignorer jusqu’à l’apparition d’un problème de sécurité ou de compatibilité.
La principale raison de continuer à l’utiliser n’est pas la nostalgie. C’est l’existence de réseaux hétérogènes, durables et imparfaitement automatisés. Ces conditions ne disparaîtront probablement pas rapidement. Un outil qui recueille des preuves dans ces environnements peut rester utile même si son interface paraît ancienne.
Un diff textuel compte parce qu’il constitue une preuve circonscrite et inspectable
L’idée centrale de RANCID a survécu parce que le texte de configuration reste proche du mécanisme opérationnel de nombreux réseaux. Un ingénieur peut lire un diff, le rechercher avec des outils standard et le conserver sans base de données propriétaire. La preuve reste portable et compréhensible après le remplacement de la plateforme de surveillance d’origine.
Ses limites doivent être énoncées avec la même force. L’archive est périodique, non continue. Elle consigne certaines commandes, pas l’équipement entier. La normalisation peut retirer du contexte. Un enregistrement identifie la collecte, pas la personne qui a agi. Les identifiants et les dépôts créent un risque pour le plan de gestion. Un fichier ne représente pas l’état souhaité, et le restaurer sans vérification peut être dangereux.
Ces limites maintiennent l’honnêteté de l’outil. RANCID n’a pas besoin de prétendre que les instantanés constituent une intention exécutable. Il peut compléter GitOps parce qu’il consigne la réponse de l’équipement après l’automatisation. Il peut compléter LibreNMS parce qu’il ajoute le contexte de configuration aux symptômes. Il peut compléter les gestionnaires commerciaux parce qu’il préserve un dépôt indépendant.
Le test observable consiste à déterminer si l’archive améliore une véritable investigation. L’équipe peut-elle identifier la dernière collecte réussie, comparer les lignes pertinentes, relier le changement à un autre relevé et assurer la reprise sans exposer les identifiants ni déployer un ancien texte? Peut-elle prouver que le dépôt lui-même n’a pas été modifié? Peut-elle reconnaître que l’absence d’un diff résulte d’un échec de collecte?
Si les réponses sont positives, RANCID est plus qu’un ancien script. C’est un petit système de preuve intégré aux opérations réseau. Dans le cas contraire, la gestion de versions peut fournir un historique convaincant de la mauvaise réalité.
La leçon durable du projet est que contrôle et preuve ne doivent pas être considérés comme identiques. Un contrôleur indique ce qui devrait se produire. Un équipement déclare ce qu’il croit configuré. Un système de surveillance montre le comportement de certains signaux. Un diff textuel préserve une partie de ce désaccord. Les réseaux deviennent plus faciles à gouverner lorsque ces relevés peuvent être comparés plutôt que contraints à raconter une histoire unique.
La discipline finale consiste à préserver l’incertitude dans le relevé. Un diff propre peut établir que certains textes ont changé entre deux collectes réussies. Il ne peut pas établir la séquence complète des commandes, le motif de l’opérateur ni le chemin causal vers une panne. Ces conclusions exigent d’autres journaux, des entretiens et des essais. RANCID est plus crédible lorsque ses utilisateurs refusent de lui faire prouver davantage que ce qu’il a collecté.
Cette retenue explique aussi pourquoi le système reste lisible après des décennies. Ses fichiers peuvent être ouverts sans client propriétaire, son historique peut être répliqué et ses modules peuvent être examinés. L’architecture ne rend pas les preuves neutres: les filtres, les calendriers et les accès continuent de les façonner. Elle laisse toutefois ces choix assez près de la surface pour qu’un opérateur puisse les contester. Dans un marché des infrastructures attiré par des plateformes de gestion toujours plus vastes, cette inspectabilité constitue une forme concrète de contrôle.
Elle offre également une voie de sortie. Si le projet, le paquet ou l’intégration privilégiée change, l’organisation peut conserver le texte ordinaire et l’historique des versions, à condition d’avoir documenté la manière dont les données ont été recueillies. Cette portabilité ne supprime pas le travail de migration, mais elle empêche les preuves de disparaître avec un compte fournisseur ou une structure de base de données. Pour les réseaux durables, la capacité à transporter le relevé d’hier vers l’outil de demain peut être aussi précieuse qu’une nouvelle fonction d’automatisation.
L’archive devient alors une mémoire institutionnelle plutôt qu’une pièce jointe à un collecteur particulier. Sa valeur dépend d’un accès durable, d’une provenance interprétable et de personnes sachant où commencent ses limites. Ce sont des choix de gouvernance, non des réglages logiciels par défaut, et ils doivent être testés avant qu’une urgence ne touche réellement le réseau.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance