
Summary
- O Prospero permitia que usuários e administradores criassem visões virtuais sobre arquivos e índices remotos, sem transferir nem interpretar os dados originais.
- Um relatório de 1994 registrou integração com Archie e Gopher e planos para WAIS e Web; em 2005, um RFC afirmou que o protocolo não havia sido amplamente implementado.
O diretório podia refletir o trabalho de quem o usava
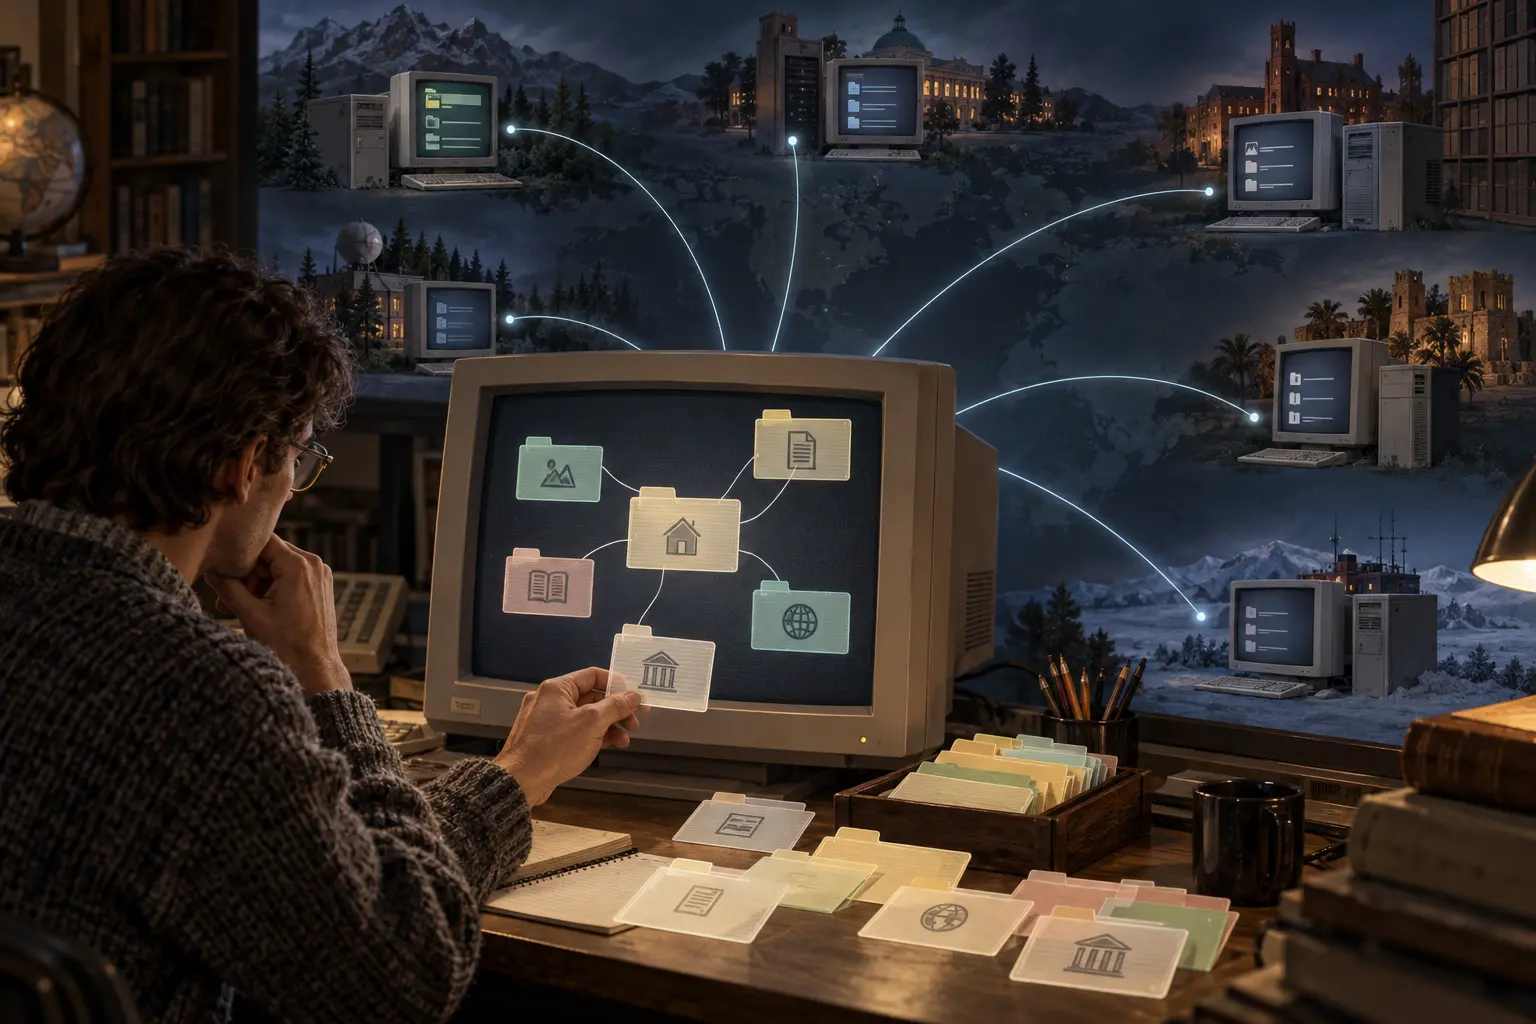
Em geral, o diretório parece pertencer à máquina que guarda seus arquivos. O Prospero partia de outra pergunta: seria possível organizar, em uma visão própria, recursos espalhados por diversas instituições sem copiá-los para um repositório central?
No início dos anos 1990, a Internet já tinha ferramentas diferentes para tarefas diferentes. Archie indexava nomes de arquivos em arquivos FTP. Gopher conduzia a navegação por menus. WAIS pesquisava bases de texto, e a Web começava a ligar documentos por hiperlinks. Essas ferramentas ajudavam a localizar informação, mas a descoberta não colocava automaticamente o recurso no mapa de trabalho de uma pessoa. Um pesquisador podia reunir referências sem exigir que os arquivos mudassem de endereço.
O Virtual System Model do Prospero separava organização e armazenamento. Um servidor podia expor partes de seu sistema de arquivos ou informações de outra base. Usuários e administradores também podiam criar visões personalizadas do espaço de nomes. As entradas apontavam para recursos que continuavam nas máquinas de origem. Assim, a visão podia ser integrada sem que o armazenamento se tornasse centralizado.
Encontrar e obter não eram a mesma etapa
Prospero não era uma versão alternativa do Archie. O Archie montava uma base pesquisável de nomes e localizações de arquivos FTP; o Prospero podia apresentar essa base como um dos elementos de um diretório mais amplo. Também não era simplesmente Gopher: o relatório de 1994 descrevia um gateway capaz de tratar servidores Gopher como bancos de dados e combiná-los com outras fontes.
O sistema não interpretava os dados que organizava. Podia oferecer mecanismos de recuperação, mas a aplicação do usuário decidia como exibir e utilizar o resultado. Prospero tampouco tinha protocolo próprio para transferir arquivos. A recuperação podia ocorrer por FTP, NFS, AFS ou Gopher; serviços com login podiam usar Telnet. O diretório ajudava a localizar e a selecionar uma forma de acesso, sem garantir que o arquivo estivesse atualizado, que o servidor autorizasse a consulta ou que o conteúdo fosse relevante.
Essa separação tornava possível integrar serviços sem obrigá-los a compartilhar formato ou armazenamento. Em compensação, cada fronteira podia falhar: o ponteiro permanecia depois que o arquivo mudava, uma permissão bloqueava o acesso, ou o cliente não sabia lidar com a URL devolvida.
Um mapa sujeito a permissões
As solicitações ao diretório Prospero usavam UDP e uma camada própria de entrega confiável. O relatório também registra controles de acesso a objetos, diretórios e índices, com opções de autenticação que incluíam senhas e Kerberos versão 5. Um diretório virtual, portanto, não precisava ser uma lista pública; seu responsável podia limitar quem consultava cada parte.
O esquema prospero:// deixava a separação visível. Ele designava um objeto cujo nome específico do host seria interpretado pelo servidor Prospero. Ao consultá-lo, o servidor podia indicar outro método de acesso, talvez descrito por uma URL diferente. O endereço não garantia que o recurso existisse ou que o leitor tivesse autorização. Nem as barras indicavam necessariamente uma hierarquia: a semântica ficava a cargo do servidor.
A analogia mais útil é um mapa, não um depósito. O mapa relaciona lugares e sugere trajetos, mas não é dono dos lugares nem mantém as estradas abertas. As notas de Heng Lu sobre diretórios e autoridade distribuída servem como lente editorial, não como evidência dos objetivos do projeto: descrever um recurso não significa controlá-lo.
Uma proposta documentada, mas pouco difundida
O relatório sobre ferramentas de recuperação de informação em rede, publicado em 1994, estimava cerca de 50 servidores Prospero; os registros de servidores e clientes tinham sido atualizados em novembro de 1993. É uma estimativa reportada pelo projeto em uma data específica, não uma medição de usuários ou de diretórios ativos. O relatório descreveu integração com Archie e Gopher, enquanto tratava WAIS e documentos Web como planos futuros.
Em 2005, o RFC 4157 preservou o esquema URI e classificou o documento como histórico. Também declarou que o protocolo não havia sido amplamente implementado e que quase nenhum servidor continuava em uso. Isso não apaga o experimento arquitetural, mas limita o que se pode afirmar: o Prospero tornou concreta uma forma de organizar recursos distribuídos, sem se tornar uma camada de diretórios amplamente adotada.
O desafio não era apenas programar os conectores. A utilidade de um mapa dependia de alguém manter as visões, de clientes reconhecerem o espaço de nomes, de integrações continuarem atualizadas e de usuários aceitarem mais uma ferramenta. Uma ponte entre serviços só existe enquanto alguém cuida dela.
A importância histórica do Prospero está menos em reivindicar que antecipou uma tecnologia posterior e mais em tornar explícita uma escolha. A Internet deveria depender de um índice global ou permitir muitos mapas locais sobre recursos ainda mantidos por seus próprios provedores? Prospero experimentou a segunda alternativa. Seu alcance modesto mostra que distribuir a organização pode preservar autonomia, mas torna a coordenação cotidiana uma tarefa permanente.
Referências
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance