
Resumen
- RFC 1913 definió un resumen de “conocimiento hacia delante”: términos sin duplicados que indicaban qué servidores inferiores podían guardar una coincidencia. Era información para enrutar la consulta, no prueba del registro.
- Al aceptar varios padres y varias jerarquías, la red de índices evitó una única ruta, pero convirtió la búsqueda en un grafo que el cliente debía recorrer con controles de bucles, tiempo, coste y disponibilidad.
- La técnica se abstrajo en 1999 como Common Indexing Protocol; Whois++ fue reclasificado como Historic en 2006 tras una revisión del IETF que lo describió como definido pero no utilizado.
Reducir una ficha hasta convertirla en indicio
El ejemplo de RFC 1913 toma tres fichas: dos usuarios y un dominio. El centroid conserva, bajo cada tipo de plantilla y atributo, una sola aparición de cada palabra encontrada. “Smith” queda una vez, tanto si procede de una ficha como de mil. Las palabras de una misma frase se separan. No sobreviven el número de coincidencias, el identificador del registro, el orden, la coexistencia de términos ni la persona que mantuvo el dato.
La pérdida es la función, no el defecto. Para descartar ramas sin interés, un índice no necesita duplicar toda la base. Necesita saber que un servidor inferior podría responder. Por eso una coincidencia tenía una semántica limitada: según el resumen disponible, esa palabra apareció en ese atributo y plantilla en algún punto inferior. El resultado correcto era una referencia. La evidencia continuaba en otro lugar.
Una malla por encima de los datos
En agosto de 1995, RFC 1835, Architecture of the WHOIS++ service, estructuró el viejo modelo de WHOIS con plantillas tipadas y pares atributo-valor. Distinguió el servidor base, que contenía fichas completas, del servidor índice, que guardaba conocimiento hacia delante y punteros. Un mismo equipo podía asumir ambos papeles, sin confundir sus contenidos.
La separación respondía a dos límites. Centralizar un directorio mundial concentraba almacenamiento, tráfico y fallo. Organizarlo solo como árbol exigía saber antes de buscar dónde debía vivir la información, cargaba los niveles superiores y trataba mal preguntas transversales de “páginas amarillas”.
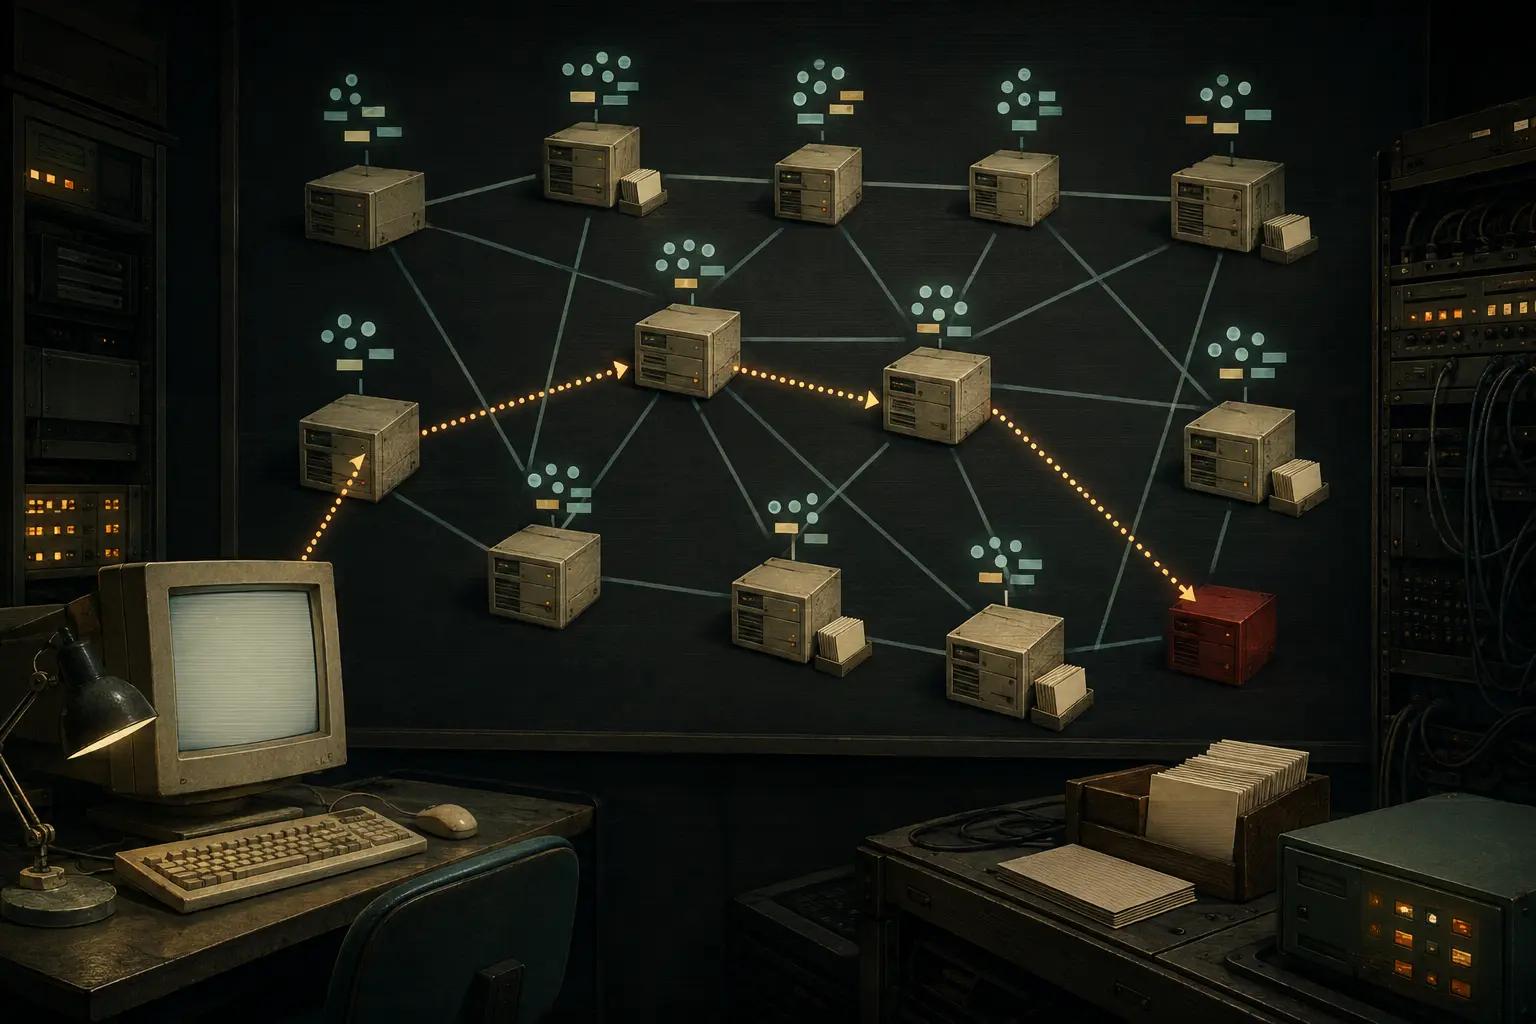
Publicado en febrero de 1996, RFC 1913, Architecture of the Whois++ Index Service, superpuso una malla. Un índice reunía centroids de servidores base o de otros índices y generaba su propio resumen. Cualquier servidor podía ser indexado por más de un superior y participar en jerarquías geográficas, administrativas o topológicas. La identidad única de una ficha quedó separada de la ruta para encontrarla.
Eso daba rutas alternativas y directorios especializados. La consulta podía empezar sin conocer la ubicación. Sin embargo, la malla seguía transportando indicios. La ficha autoritativa continuaba en el servidor base, y cada referencia solo explicaba por qué merecía la pena preguntar de nuevo.
Una actualización se descompuso en actos
El protocolo mantenía el conocimiento mediante POLL autenticado. Un índice podía pedir un centroid completo o cambios limitados por plantilla y campo. El servidor inferior podía enviar DATA-CHANGED; el receptor decidía si y cuándo volver a sondear.
Entre la realidad y el índice había varias etapas: cambio del registro, cambio del centroid, aviso, aceptación, sondeo, autenticación del informe, incorporación local y propagación posterior. El código 227 significaba que una transmisión había sido aceptada y registrada para actuar después. No acreditaba aplicación global.
Un indicio positivo antiguo podía enviar al cliente a un servidor que ya no contenía la palabra. Un indicio nuevo aún no propagado podía excluir a quien acababa de incorporarla. Los RFC no miden la frecuencia real de esos casos. La deducción legítima es más sobria: recepción, aplicación, propagación y estado actual son pruebas distintas.
El cliente heredó la complejidad
La malla parecía jerárquica, pero la pertenencia múltiple la convertía en grafo. RFC 1913 propuso un contador de saltos para relaciones de sondeo, con máximo ocho en aquella versión, y planteó que el cliente detectara referencias repetidas durante la consulta.
RFC 1914, How to Interact with a Whois++ Mesh, también de febrero de 1996, detalló el recorrido. El cliente conectaba, preguntaba, recibía registros y referencias, cerraba la conexión y elegía el siguiente servidor. Guardaba los ya consultados y podía ampliar la búsqueda preguntando qué servidores sondeaban a cuáles.
La expansión no era neutral. Seguir todo podía generar un coste exponencial de recursos. Algunas respuestas podían cobrarse. El cliente necesitaba límites de tiempo y dinero, listas negras y una opción de cancelar. La cobertura dependía del punto de entrada, las referencias disponibles, la detección de ciclos, la política de expansión, el presupuesto y la disponibilidad. “Todos los resultados” era una propiedad de la ejecución completa, no de la primera respuesta.
La identidad duraba más que la dirección
Una referencia incluía servidor, host y puerto, pero esos datos podían proceder de un sondeo realizado semanas antes. Si la conexión fallaba, el cliente podía usar el server handle estable para preguntar al Directory of Servers por el destino más reciente conocido.
Separar identidad y ubicación permitía mover el servicio sin renovar cada copia a la vez. Aun así, “más reciente conocido” no significaba “en línea”. El segundo destino también podía fallar. RFC 1913 distinguía el servidor inalcanzable del host accesible cuyo servicio no respondía. El identificador reparaba una dirección obsoleta; no garantizaba el proceso.
La seguridad también quedaba acotada. RFC 1913 declaraba que no discutía asuntos de seguridad. RFC 1914 aconsejaba listas negras porque podían aparecer servidores Whois++ falsos. No hay ahí prueba de un ataque observado. Sí hay una advertencia estructural: cada referencia traspasaba otra frontera administrativa y pedía al cliente que evaluara otra fuente.
La abstracción siguió su camino
En agosto de 1999, RFC 2651, The Architecture of the Common Indexing Protocol, presentó CIP como evolución y refinamiento del índice distribuido de Whois++. Separó el intercambio de índices del protocolo de acceso, permitió otros objetos de resumen y llamó “pistas” a los datos usados para encaminar consultas. El cliente aún necesitaba un protocolo nativo para recuperar el resultado real.
Esa continuidad impide decir que todo terminó con el producto. Una implementación o servicio puede desaparecer y dejar una distinción útil: información para elegir una ruta no es la información buscada.
La retirada formal llegó en marzo de 2006. RFC 4450, Getting Rid of the Cruft, documentó una revisión conservadora de Proposed Standards antiguos. Incluyó RFC 1835, 1913 y 1914 entre los textos que debían pasar a Historic y citó Whois++ como protocolo definido pero no utilizado. La afirmación no borra pruebas ni software — RFC 2651 menciona Digger —; recoge el juicio del IETF de que esos estándares ya no representaban práctica documentada vigente.
No fue una derrota simple de lo distribuido frente a lo central. La malla abordó un problema real y su mecanismo fue generalizado. El límite persistente estaba en cada salto entre el indicio y el hecho.
Fuentes
- RFC 1835, RFC 1913, RFC 1914, RFC 2651 y RFC 4450 aparecen enlazados una sola vez en el análisis.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance