
Resumo
- O RFC 1913 permitiu que servidores Whois++ publicassem “conhecimento adiante”: termos deduplicados que indicavam quais servidores inferiores talvez contivessem uma correspondência. Era roteamento de consulta, não prova do registro.
- Vários caminhos reduziram a dependência de uma hierarquia única, mas criaram um grafo que o cliente precisava percorrer. Atualização, laços, recuperação do destino, expansão e custo continuaram separados.
- O mecanismo foi generalizado em 1999 no Common Indexing Protocol; o Whois++ foi reclassificado como Historic em 2006 após uma revisão do IETF descrevê-lo como definido, mas não usado.
Esquecer para poder procurar
O exemplo do RFC 1913 reúne três registros: dois usuários e um domínio. Para cada modelo e atributo, o centroid guarda uma ocorrência de toda palavra encontrada. “Smith” aparece uma vez, esteja em um registro ou em mil. Palavras antes vizinhas se tornam itens independentes. Desaparecem identificador, contagem, ordem, coocorrência, origem e confirmação de que o valor ainda existe.
Essa redução era intencional. Para eliminar ramos que não ajudariam, o servidor de índice não precisava duplicar a base. Bastava afirmar que, segundo o resumo disponível, uma palavra daquele atributo havia aparecido em algum lugar abaixo. A conclusão legítima era indicar outro servidor. O dado final ainda precisava ser consultado.
Uma malha acima dos registros
Publicado em agosto de 1995, o RFC 1835, Architecture of the WHOIS++ service, transformou fichas soltas em modelos tipados e pares atributo-valor estruturados. Separou servidores de base, com registros preenchidos, de servidores de índice, com conhecimento adiante e ponteiros. Uma máquina podia cumprir os dois papéis, sem tornar os conteúdos equivalentes.
Um diretório mundial central concentraria armazenamento, tráfego e falha. Uma árvore rígida exigiria saber antes da busca onde a informação deveria morar, sobrecarregaria os níveis superiores e responderia mal a perguntas transversais de “páginas amarelas”.
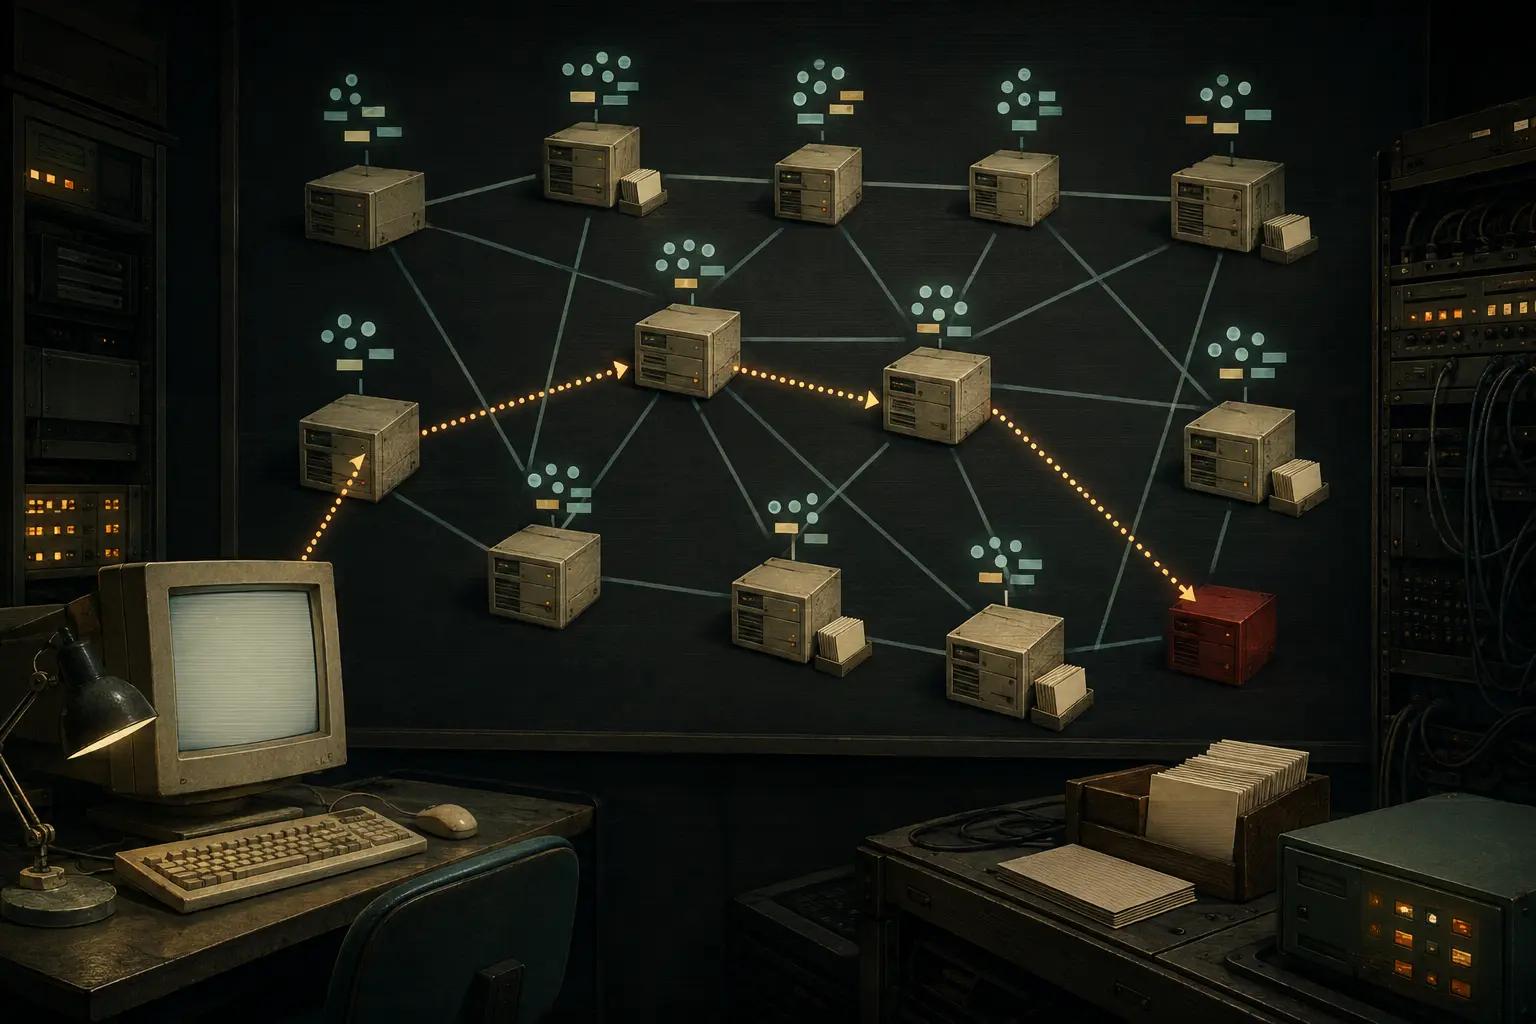
Em fevereiro de 1996, o RFC 1913, Architecture of the Whois++ Index Service, sobrepôs uma malha. Um índice podia agregar centroids de servidores de base ou de outros índices e produzir seu próprio resumo. Um servidor podia participar de mais de uma hierarquia — geográfica, administrativa ou topológica. A identidade do registro deixou de impor um único caminho de descoberta.
O benefício eram rotas alternativas e índices especializados sem mover a fonte autoritativa. O usuário não precisava conhecer a localização. Mas a malha transportava razões para perguntar; não transportava automaticamente a realidade inteira do destino.
Uma mudança atravessava vários relógios
O RFC 1913 definiu sondagens POLL autenticadas. O coletor podia pedir um centroid completo ou alterações por modelo e campo. O servidor inferior podia emitir DATA-CHANGED; quem recebia escolhia se e quando buscaria o novo estado.
Uma atualização se dividia em eventos: o registro mudava, o centroid era recalculado, o aviso saía, era aceito, ocorria nova sondagem, o relatório era autenticado, o índice aplicava a alteração e índices superiores a recebiam depois. O código 227 significava aceito e registrado para ação posterior. Não significava aplicado e propagado em toda parte.
Assim, um positivo antigo podia apontar para onde a palavra já não existia. Um dado novo ainda não propagado podia produzir um falso silêncio no índice. Os RFCs não medem a frequência real. A lição verificável é que recebimento, aplicação, propagação e estado atual são provas diferentes.
O cliente recebeu o grafo
A malha parecia uma hierarquia, mas vários pais a tornavam um grafo. Para relações de sondagem, o RFC 1913 propunha contagem de saltos, limitada a oito naquela versão. Para referências de consulta, o cliente precisava lembrar servidores já visitados.
O RFC 1914, How to Interact with a Whois++ Mesh, também de fevereiro de 1996, descreveu o percurso. O cliente conectava, enviava a consulta, recebia registros e referências, fechava e escolhia o próximo destino. Mantinha uma lista dos já consultados e podia ampliar a busca além do ponto inicial.
Ampliar tudo, porém, podia gerar custo exponencial de recursos. Partes da malha poderiam cobrar por resposta. O cliente necessitava de limite de tempo e dinheiro, lista de bloqueio e interrupção pelo usuário. A completude dependia do início, das referências, da detecção de ciclos, da política de expansão, do orçamento e da disponibilidade. Não cabia em uma única resposta.
Um identificador estável não mantinha o serviço no ar
Host, endereço IP e porta de uma referência podiam vir de uma sondagem feita semanas antes. Se a conexão falhasse, o cliente podia levar o server handle estável a um Directory of Servers e pedir o destino mais recente conhecido.
Separar identidade de localização permitia mudanças sem atualizar todos os caches simultaneamente. Mas “mais recente conhecido” não era “agora acessível”. A segunda conexão ainda podia falhar. O RFC 1913 distinguia servidor inalcançável de host acessível cujo serviço não respondia. O handle corrigia uma referência antiga; não criava um processo disponível.
Os limites de segurança eram igualmente explícitos. O RFC 1913 dizia não discutir segurança. O RFC 1914 recomendava listas de bloqueio porque servidores Whois++ falsos poderiam surgir. Isso não documenta um ataque ocorrido. Mostra que seguir uma referência atravessava uma fronteira administrativa e exigia avaliar outra alegação sobre os dados.
A ideia saiu do produto
Em agosto de 1999, o RFC 2651, The Architecture of the Common Indexing Protocol, apresentou o CIP como evolução e refinamento da indexação distribuída do Whois++. Separou a troca de índices do protocolo de acesso, generalizou os objetos possíveis e chamou o conteúdo de pistas para roteamento de consultas. O cliente ainda usava um protocolo nativo para obter o resultado.
Uma distinção arquitetural pode sobreviver ao serviço que a apresentou. O Whois++ combinava centroid e diretório por modelos; o CIP tentou preservar a parte reutilizável: trocar conhecimento compacto para aproximar a consulta de prováveis detentores dos dados.
Em março de 2006, o RFC 4450, Getting Rid of the Cruft, registrou uma revisão conservadora de antigos Proposed Standards. Os RFCs 1835, 1913 e 1914 foram incluídos na mudança para Historic, e o Whois++ foi citado entre protocolos definidos, mas não usados. Isso não apaga experimentos nem programas — o RFC 2651 menciona Digger. Registra o juízo do IETF de que os textos já não representavam prática corrente a manter como Proposed Standard.
Não é uma fábula em que a centralização venceu a descentralização. A malha resolveu um problema real e sua abstração prosseguiu. O limite duradouro estava no custo de cada passagem entre pista e fato.
Fontes
- Os RFCs 1835, 1913, 1914, 2651 e 4450 estão vinculados uma vez cada na análise.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance