
Résumé
- Dans RFC 1913, le centroid était une « connaissance en avant » : une liste dédupliquée de mots signalant quels serveurs inférieurs pouvaient contenir un résultat. Il routait la requête, sans prouver l’enregistrement.
- La pluralité des chemins libérait l’annuaire d’une hiérarchie unique, mais laissait au client les boucles, l’expansion, les limites de coût et la vérification d’un point d’accès parfois périmé.
- Le principe fut généralisé en 1999 dans le Common Indexing Protocol ; Whois++ fut néanmoins classé Historic en 2006, après une revue IETF qui le rangea parmi les protocoles définis mais non utilisés.
Une perte d’information assumée
L’exemple de RFC 1913 part de trois enregistrements : deux personnes et un domaine. Le centroid garde, pour chaque modèle et chaque attribut, un exemplaire de chaque mot rencontré. « Smith » n’y figure qu’une fois, qu’il corresponde à une fiche ou à mille. Deux mots tirés de la même valeur deviennent indépendants. L’identifiant de la fiche, la fréquence, l’ordre, les rapprochements et l’auteur de la mise à jour ont disparu.
Cette réduction n’est pas une erreur. L’index n’a pas à recopier toutes les données pour écarter les branches inutiles. Il lui suffit de pouvoir dire : selon l’état résumé que je possède, un mot de cette catégorie et de cet attribut apparaît quelque part en aval. La conséquence correcte est une orientation vers un autre serveur. Ce n’est ni un résultat, ni une preuve de présence au moment de la requête.
Toute l’architecture devient plus lisible dès que cette portée est respectée. Un signal positif peut justifier une vérification. Un silence peut justifier un doute. Aucun des deux ne remplace la lecture de la source.
Superposer un maillage aux fiches
Publié en août 1995, RFC 1835, Architecture of the WHOIS++ service, donnait aux anciennes fiches WHOIS des modèles typés et des couples attribut-valeur structurés. Il distinguait les serveurs de base, détenteurs des fiches remplies, des serveurs d’index, détenteurs de connaissances en avant et de pointeurs. Une même machine pouvait cumuler les rôles, sans que les deux types de contenu deviennent équivalents.
Un annuaire mondial central aurait concentré stockage, trafic et panne. Une arborescence stricte imposait au demandeur de connaître d’avance la place de l’information, chargeait les sommets et répondait mal aux questions de type « pages jaunes », transversales aux frontières géographiques ou administratives.
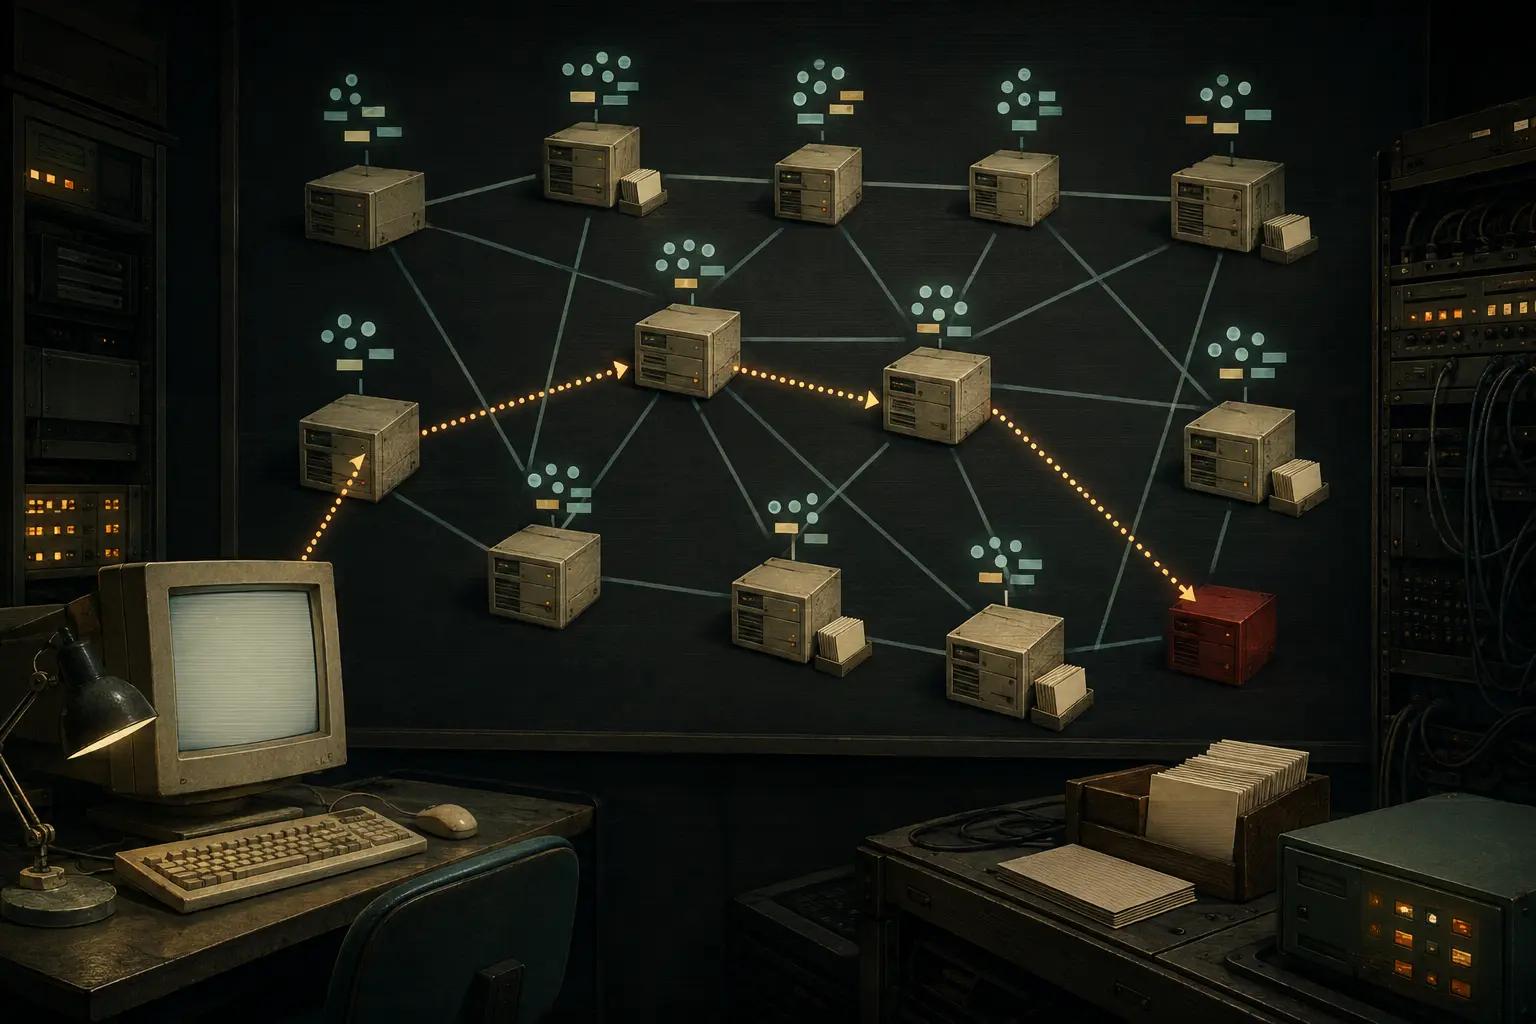
RFC 1913, Architecture of the Whois++ Index Service, publié en février 1996, proposa donc un maillage au-dessus des données. Un serveur d’index pouvait agréger les centroids de serveurs de base ou d’autres index. Un même serveur pouvait relever de plusieurs hiérarchies — géographique, administrative ou topologique. L’identifiant unique d’une fiche ne prescrivait plus l’unique route permettant de la découvrir.
Le bénéfice était réel : chemins alternatifs, annuaires spécialisés, recherche sans connaissance préalable du lieu. La donnée autoritative restait pourtant au serveur de base. Le maillage faisait circuler des raisons de poser la question ailleurs.
La mise à jour n’était pas un seul instant
RFC 1913 prévoyait des interrogations POLL authentifiées, complètes ou limitées à certains modèles et attributs. Le serveur interrogé pouvait envoyer DATA-CHANGED pour annoncer que son centroid avait changé ; l’index destinataire décidait ensuite si et quand il lancerait un nouveau relevé.
Une modification traversait ainsi plusieurs horloges : changement de la fiche, recalcul du centroid, notification, réception, relevé, authentification du rapport, application locale puis éventuelle remontée vers d’autres index. Le code 227 ne promettait que l’acceptation et l’enregistrement d’une transmission pour traitement ultérieur. Il ne certifiait pas sa prise en compte partout.
Une ancienne indication positive pouvait donc conduire vers un serveur où le mot avait disparu. Une nouvelle indication encore absente pouvait écarter un serveur qui venait d’acquérir la bonne fiche. Les RFC ne mesurent pas ces cas en exploitation. Elles suffisent néanmoins à interdire une confusion : accusé de réception, application et propagation ne sont pas le même fait.
Le client devait maîtriser le graphe
Le dessin ressemblait à une hiérarchie, mais la possibilité de plusieurs parents en faisait un graphe. RFC 1913 proposait un compteur de sauts pour détecter les cycles entre collecteurs, plafonné à huit dans cette version. Pour les orientations de requêtes, la mémoire des serveurs déjà consultés revenait au client.
RFC 1914, How to Interact with a Whois++ Mesh, également daté de février 1996, détaillait ce travail. Le client se connectait, posait sa requête, recevait fiches et renvois, fermait la connexion, puis choisissait la prochaine cible. Il conservait l’ensemble des serveurs déjà visités et pouvait élargir la recherche au-delà de son point d’entrée.
Mais une extension aveugle pouvait croître de façon exponentielle. Certaines réponses pouvaient être payantes. Le client devait donc savoir interrompre, plafonner temps et dépense, ou exclure un serveur trop coûteux. La complétude dépendait du point de départ, des renvois reçus, des règles d’expansion, des listes de blocage, du budget et de la disponibilité. L’algorithme ne supprimait pas ces choix ; il les rendait visibles.
Un nom stable, une adresse qui vieillit
Le nom d’hôte, l’adresse IP et le port d’un renvoi pouvaient provenir d’un relevé vieux de plusieurs semaines. En cas d’échec, le client pouvait reprendre le server handle, plus stable, et consulter un Directory of Servers pour obtenir la dernière localisation connue.
Séparer identité et emplacement permettait le déménagement d’un service sans rendre immédiatement cohérents tous les caches. Pourtant, « dernière connue » ne voulait pas dire « actuellement disponible ». La nouvelle tentative pouvait encore échouer. RFC 1913 distinguait d’ailleurs un serveur impossible à joindre d’un hôte joignable dont le service ne répondait pas. Le handle corrigeait un pointeur ; il ne créait pas un processus vivant.
Les limites de sécurité restent documentaires. RFC 1913 disait ne pas traiter les questions de sécurité. RFC 1914 recommandait une liste noire parce que de faux serveurs Whois++ pouvaient apparaître. Cela ne prouve aucune attaque observée ; cela montre que suivre un renvoi engageait le client dans un autre domaine d’administration et face à une autre prétention de détenir les données.
Le mécanisme survécut à son premier véhicule
En août 1999, RFC 2651, The Architecture of the Common Indexing Protocol, présenta CIP comme une évolution et un raffinement des idées d’indexation distribuée de Whois++. Il détacha l’échange d’index du protocole d’accès à l’annuaire, généralisa les objets d’index et qualifia leur contenu d’indices guidant le routage des requêtes. Un protocole d’accès natif restait nécessaire pour obtenir les résultats.
Cette filiation empêche une conclusion trop simple. Whois++ ne devint pas un service public durable, mais sa séparation entre indication et donnée pouvait être réutilisée. Le produit et l’idée n’ont pas le même cycle de vie.
En mars 2006, RFC 4450, Getting Rid of the Cruft, relata une revue prudente d’anciens Proposed Standards. RFC 1835, 1913 et 1914 furent placés dans l’ensemble à reclasser Historic ; Whois++ figura parmi les protocoles définis mais non utilisés. Ce constat n’efface ni essais ni logiciels — RFC 2651 mentionnait Digger. Il signifie que l’IETF ne considérait plus ces textes comme une pratique actuelle à maintenir au rang de Proposed Standard.
Ce n’est donc pas l’histoire d’un centre qui aurait vaincu un réseau. Le maillage répondait à un vrai problème et son abstraction continua. Ce qui demeura insoluble par simple indexation, c’est le prix de chaque passage entre un indice et un fait.
Sources
- Les liens vers RFC 1835, RFC 1913, RFC 1914, RFC 2651 et RFC 4450 figurent chacun une fois dans l’analyse.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance