Resumen
- La Biblioteca anunció en abril de 2010 que recibiría los tuits públicos desde 2006 y seguiría recibiendo los nuevos. Su documento de preguntas frecuentes dejó fuera la información de cuentas privadas, los mensajes borrados y el contenido de fotos o sitios web a los que apuntaban los enlaces.
- El documento de decisión de 2017 explicó que la Biblioteca solo recibía texto mientras los tuits se alargaban y se volvían más visuales. Desde enero de 2018 escogería futuras adquisiciones por acontecimientos y temas; el archivo de texto de 2006–17 seguía conservado y bajo restricciones de acceso, según el anuncio público.
En 2017 cambió la puerta de entrada
La decisión de diciembre de 2017 no ordenó vaciar el depósito. La Biblioteca del Congreso conservaría el texto de los primeros doce años de Twitter. Lo que terminaba era la recepción indiscriminada del flujo público. La institución continuaría escogiendo tuits vinculados a elecciones, políticas públicas y otros acontecimientos o temas. Tras años de contar cada registro recibido, hizo explícita una pregunta que el contador no podía responder: ¿qué parte de un mensaje merece ocupar espacio en una colección histórica?
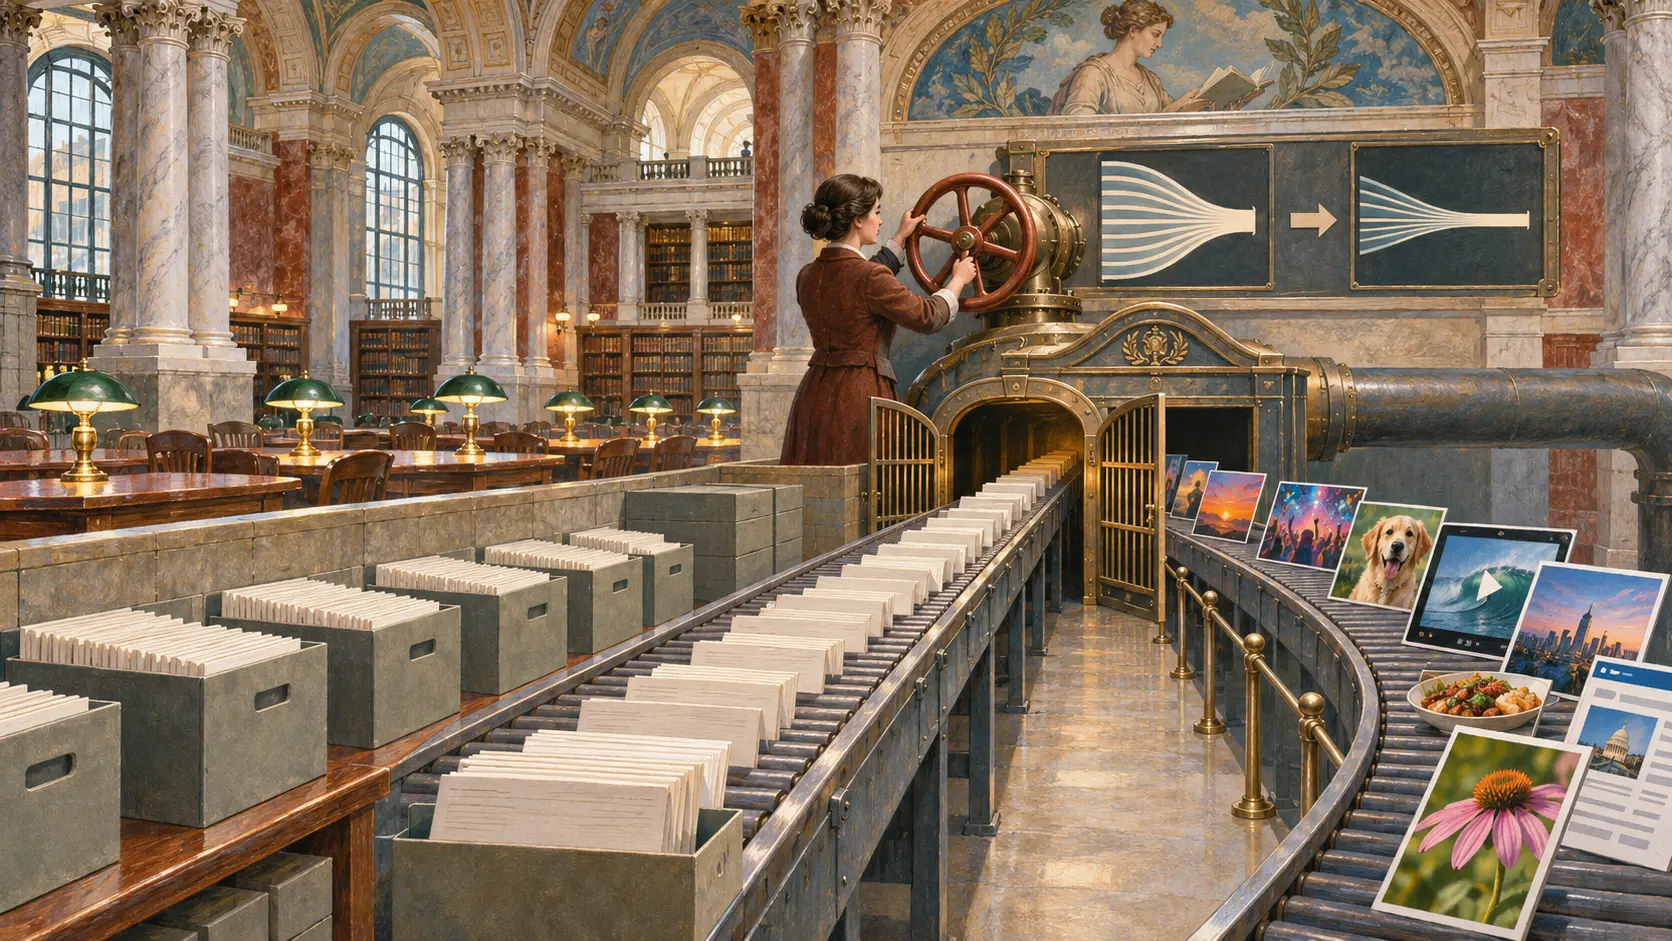
En su explicación oficial, la Biblioteca enumeró el aumento de publicaciones y operaciones asociadas, la mayor longitud de los tuits y una razón institucional: normalmente no recoge todos los elementos de un ámbito sin límite de tiempo. Había aceptado la excepción cuando nadie sabía en qué acabarían las redes sociales. También describió una fractura en el objeto de la colección. Los mensajes pasaban a apoyarse más en imágenes y vídeos. El archivo recibía únicamente el texto.
Una frase que dice «miren esto» conserva la reacción de su autor; si la foto no entra, desaparece aquello ante lo que reaccionó. En un recuento de tuits, ambas cosas parecen una sola unidad. Para quien reconstruye un debate años después, son pruebas distintas. El problema de 2017 era a la vez el coste de sostener el flujo y la capacidad del flujo para representar aquello que decía conservar.
El límite figuraba en la letra oficial de 2010
El anuncio del 14 de abril de 2010 celebraba la llegada de todos los tuits públicos desde el nacimiento de Twitter en 2006. El proyecto quería dejar constancia de noticias, conversaciones cotidianas y cambios sociales. Dos semanas después, la Biblioteca precisó las condiciones. Twitter decidiría qué se consideraba público. No enviaría información privada ni mensajes borrados. Las fotos y páginas a las que conducían los enlaces tampoco formarían parte del archivo. La Biblioteca no intentaría replicar la propia plataforma.
Así quedaban distribuidas tres funciones: la empresa definía el flujo de entrada; la institución guardaba los datos que recibía; las páginas y fotografías enlazadas permanecían bajo otros custodios. «Todos los tuits» describía una ambición de cobertura del texto público, no una copia completa de cada experiencia de lectura. La propia Biblioteca lo explicó antes de recibir los grandes lotes.
Había otro plazo en aquellas respuestas: al menos seis meses entre la publicación de un tuit y su posible uso por investigadores. Ese mínimo contractual no era una fecha de apertura del buscador. Las herramientas y las reglas concretas de acceso seguían por construir.
El depósito funcionó antes que el buscador
El informe técnico de enero de 2013 muestra la escala alcanzada. El lote histórico de 2006 a 2010 contenía unos 21.000 millones de tuits en tres ficheros comprimidos. Para el 1 de diciembre de 2012 habían llegado más de 150.000 millones adicionales: alrededor de 170.000 millones en total. Las dos copias comprimidas ocupaban 133,2 terabytes. La recepción diaria pasó de 140 millones al comenzar la transferencia continua en febrero de 2011 a casi 500 millones en octubre de 2012.
El agente de transferencia agrupaba mensajes por horas. La Biblioteca descargaba cada archivo, comprobaba daños y faltantes, contaba los tuits y lo copiaba a cinta. Guardaba dos archivos de cinta en lugares geográficos diferentes. Ese trabajo daba una respuesta verificable a la pregunta de si los textos recibidos podían mantenerse a salvo.
El mismo informe decía que los investigadores aún no tenían acceso. En los sistemas de entonces, una sola búsqueda en el lote fijo de 2006–10 podía tardar 24 horas. El acuerdo permitía el acceso a investigadores acreditados tras seis meses, pero restringía el uso comercial, la redistribución y la puesta en una web de una porción sustancial descargable. Disponer de una autorización, custodiar bytes y ofrecer una consulta útil eran logros separados. La Biblioteca había avanzado mucho más en la recepción que en la sala de lectura.
Acelerar la búsqueda no habría recuperado una foto que nunca llegó. La dificultad de consultar y la estrechez del material son dos fallos de distinto tipo. Por eso la observación sobre mensajes visuales en 2017 importa tanto como las cifras de 2013: cuanto más crecía el archivo de texto, menos garantizaba ese crecimiento que aumentase igual la parte de la conversación conservada.
Lo adquirido siguió allí; el criterio quedó a la vista
El comunicado de diciembre de 2017 afirmó que la Biblioteca tenía a salvo el texto de 2006–17. Para el futuro aplicaría una selección. El documento de decisión mantuvo el embargo sobre la colección existente hasta poder resolver el acceso de forma sostenible, sin prometer una fecha pública. También planteó cuestiones pendientes con Twitter sobre eliminaciones y acceso de usuarios.
La recogida total ya contenía una elección oculta: entraban las palabras, las imágenes se quedaban fuera. La selección posterior expuso otra decisión, la de qué acontecimiento conservar. Un archivo de doce años de texto es una fuente histórica formidable. Su límite también es una fuente de información sobre quién podía decidir qué llegaba al futuro. El cambio de 2017 no borró el pasado de la colección; hizo visible la regla que gobierna el próximo fragmento de pasado que entrará en ella.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para el Círculo Estratégico
Círculo Estratégico
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete al Círculo EstratégicoSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance