摘要
- 1984 年 7 月,Christopher Welles 与 Walter Milliken 在 RFC 909 中提出通过网络为目标机装载程序、提取状态和调试的应用层协议。目标机可以是分组交换节点、PAD 或网关。作者明确指出,断点若把目标机停住,等待远方主机再发操作指令,就可能让它无力满足实时业务要求。
- 这份提案把目标实现分为逐级累加的装载/提取器、基础调试器和完整调试器。完整级别可以在目标机预置条件命令列表,让断点触发时由机器本地执行判断。省掉关键时刻的网络往返,也意味着让被检查的设备承担更多内存与计算工作。
显微镜不能成为停机按钮
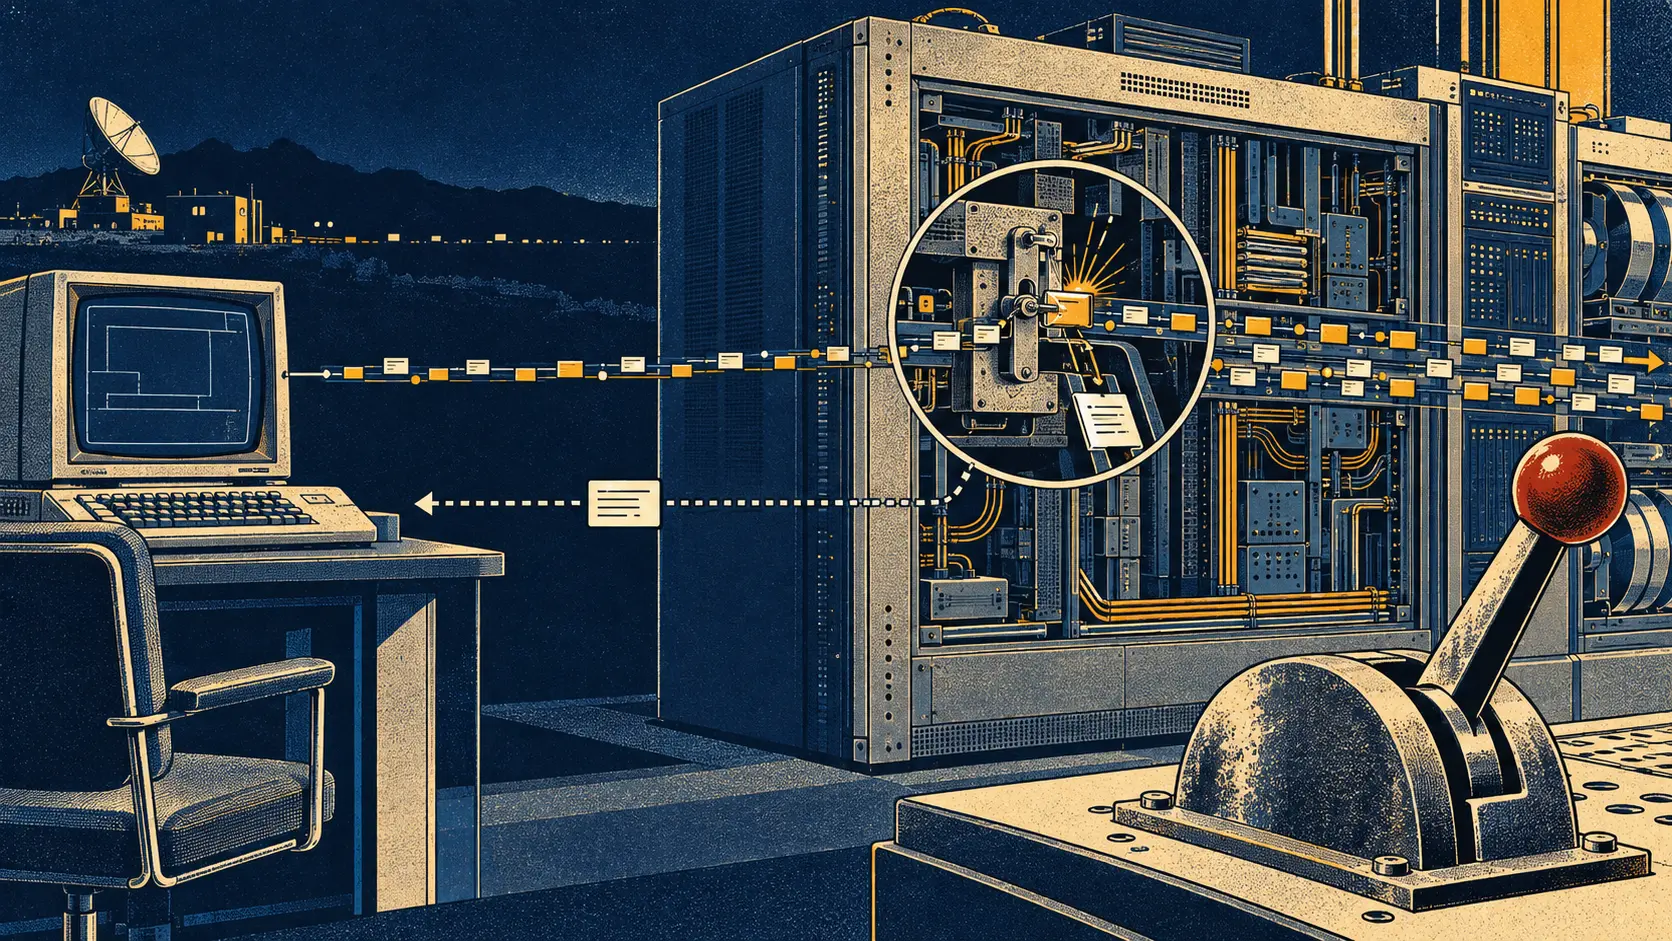
软件调试的经典画面是把程序停在一行,慢慢查看寄存器和内存。对一台隔离的测试机,这很合理;对正在转发流量的网关,停下来本身就是服务故障。RFC 909 在动机部分把这件事说得直接:若断点让目标机停止,直到远端主机送来后续断点命令,目标机就无法服务应用的实时需求。为了弄清一个网络故障而制造另一个,账面上虽是“观察”,用户看到的仍是中断。
这份 Loader Debugger Protocol,简称 LDP,是应用层命令协议,不是被动的日志窗口。它让主机跨网络装载目标程序、读写内存、搬移数据、控制执行、接收异常。正文列了四十多种命令,分成协议、数据传输、管理、控制与断点等类别。目标机类型可以不同,地址模式也必须适应不同处理器。远端获得的权力越深,服务机为这套工具留出的空间和执行时间就越值得算清。
作者并未让每台目标机背上完整工具箱。小型启动装载器的代码空间有限,只需要能收数据、取状态、启动执行和报错。RFC 909 因而定义三个累进级别:LOADER_DUMPER 保留装载与提取的基本命令;BASIC_DEBUGGER 加入更多控制能力与普通断点;FULL_DEBUGGER 加入有限状态机断点命令,监视点仍可选。建立传输连接后,主机发 HELLO,目标机的 HELLO_REPLY 告知版本、实现级别、系统类型和地址格式。先问对方会什么,再发它能承受的命令,比假定所有设备都跑得起完整调试器更诚实。
先把规则送进去,别等事故发生再发问
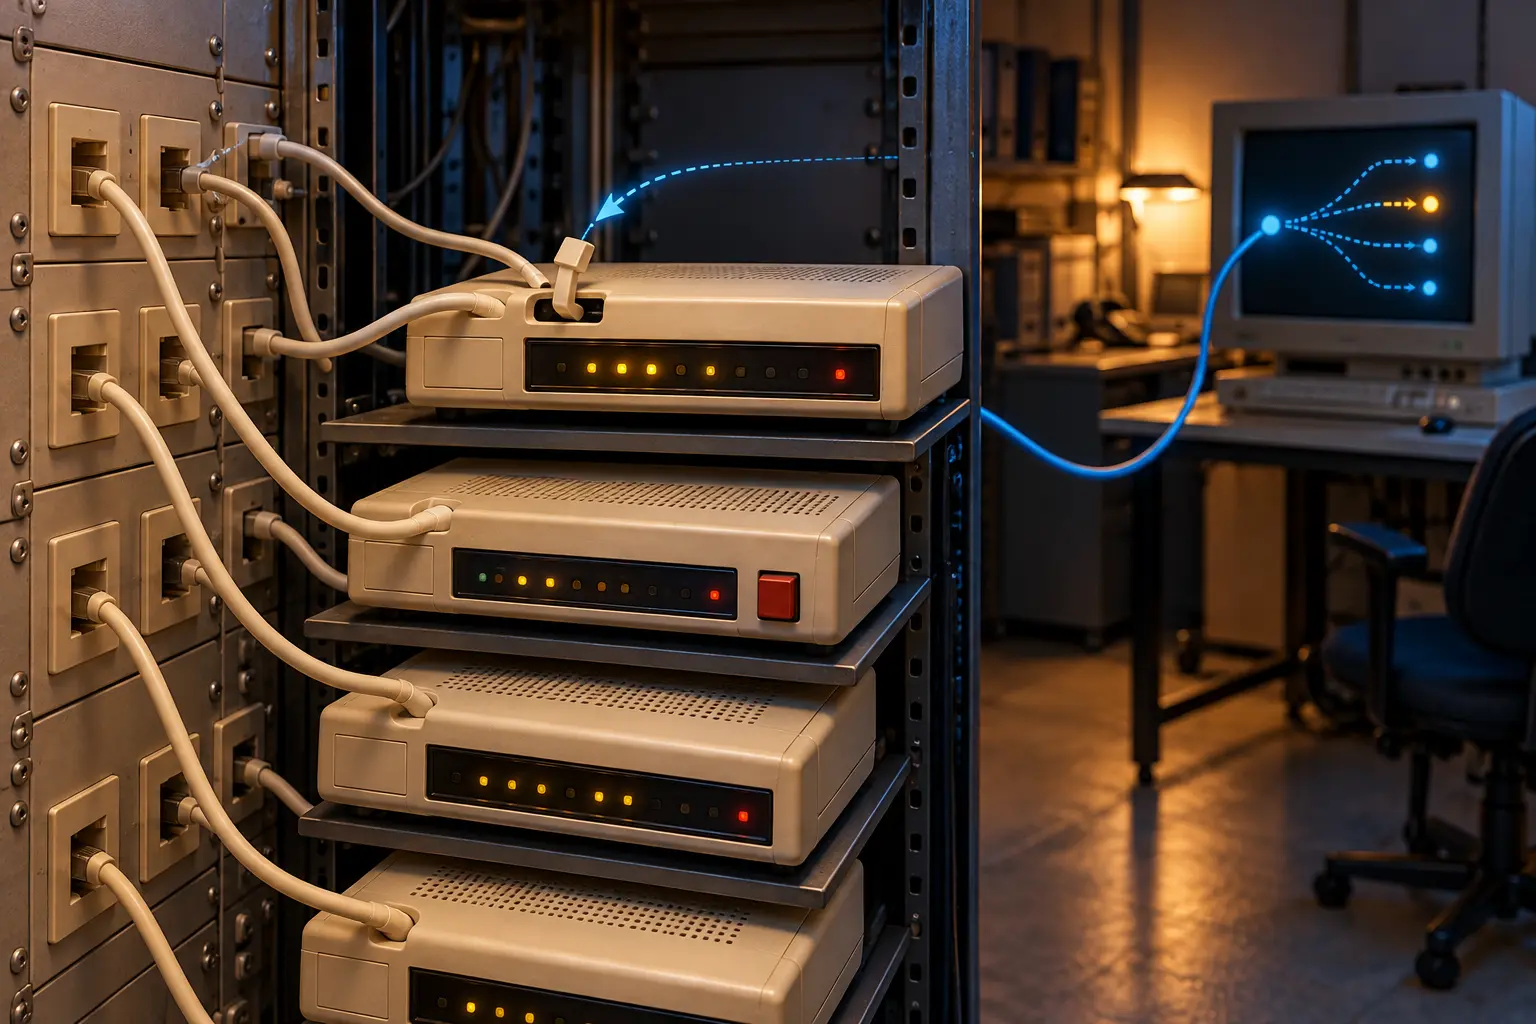
普通断点的机制简单:目标对象停下,状态报告给远端主机,再等下一道命令。网络往返就被算进停机时长。完整级别换了一种顺序。远端主机在事件发生前,把条件命令列表装进目标机;当指定地址被执行,目标机根据断点自己的状态变量挑选列表。计数器和指针可以参与条件与动作。事件发生的瞬间,机器在本地查状态、执行预设命令、决定该报告什么,不必等远处的人重新看完屏幕才让下一包指令到来。
本地执行并不免费。命令列表要占内存,条件判断要用处理器时间,有些动作仍可能停止或改变目标对象。RFC 909 承认断点数量、状态数、条件数与列表长度都可能受到实现限制。它提出的不是“调试完全不打断业务”的保证,而是把关键决策移到事件现场。远端负责事先布置规则;目标机在仍握有瞬时事实时执行,避免所有诊断动作都被远距离来回拖住。
一处细节让权限和资源问题更具体:每个断点或监视点都属于某个调试连接和某个地址。协议还希望多个用户可以同时检查一台目标机,前提是传输与目标实现支持多个连接。这意味着被看守的网关必须分清各会话的命令、状态和对象。工程师多坐几个人,并不会给网关凭空增加内存。若调试工作竞争起业务资源,清楚的归属和上限就比“多用户支持”四个字重要。
调试主机死了,还占着唯一座位
RFC 909 在会话管理中写了另一个不体面的故障。主机建立连接,打招呼,做完工作后关闭;目标机检测到关闭就释放会话资源。但主机可能在中途崩溃。如果目标机只能接纳一个连接,又无法发现这个半死不活的会话,后来的工程师就进不去。原文提出两条路:识别死连接,或者允许新连接抢占长期不活动的旧连接。第二条路也要求目标机在旧连接还存在时保留接收新连接的通道。远端工具的故障不该永远锁住被救援的机器。
传输层为这些指令提供底座。RFC 909 推荐 RFC 908 的可靠数据协议 RDP,也容许使用 TCP,只是原文认为后者更耗资源。它要求消息可靠、按序送达,且不同连接不串线;一个传输消息可以承载多个 LDP 命令,每条命令必须完整地待在同一消息里。这些要求能把指令送到现场,却决定不了断点能占用多少时间,也决定不了崩溃主机何时失去座位。
RFC 909 是实验性提案,原文没有统计实际有多少网关采用。它留下的历史冲突比部署神话更有分量:一个诊断工具越能深入控制工作中的网络机器,就越容易影响机器本来的工作。最精彩的断点记录,若靠让所有数据包陪它一起停下取得,便把“找到故障”变成了一种新的故障。
原始资料
- RFC 909,《Loader Debugger Protocol》(1984 年 7 月)——原始命令设计、目标级别、断点与会话故障。
- RFC Editor 的 RFC 909 记录——作者、日期和实验性状态。
- RFC 908,《Reliable Data Protocol》——RFC 909 推荐的传输底座。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance