
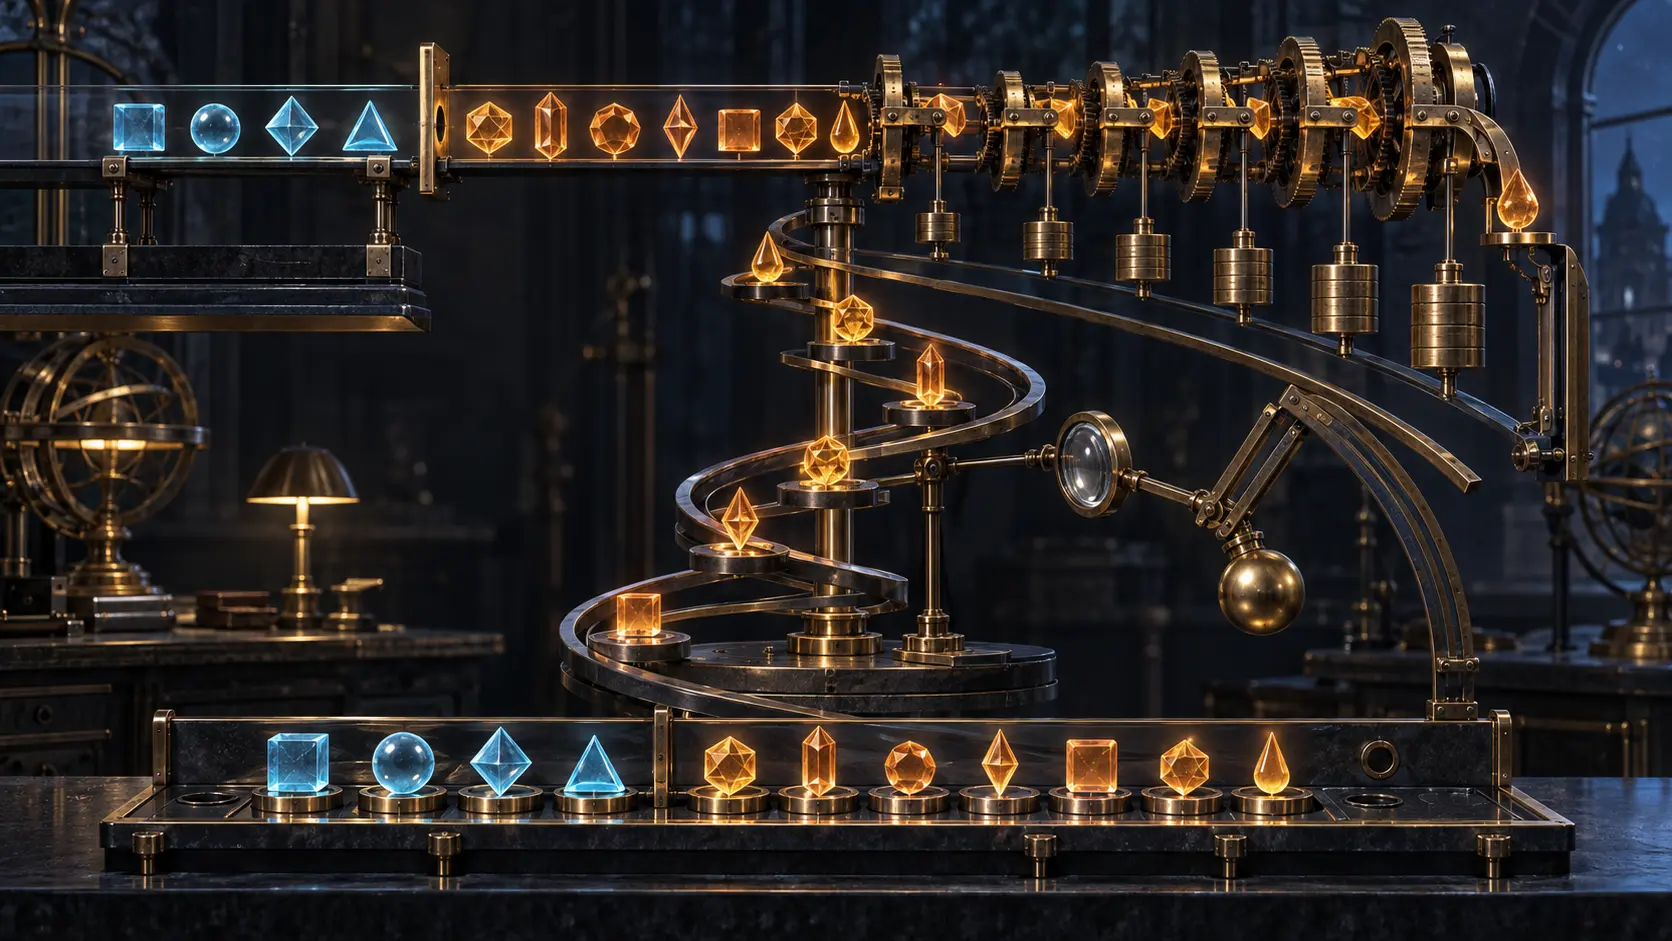
摘要
- RFC 3492 的 Bootstring 先按原顺序复制基本 ASCII 码点,再把非基本码点写成差值;每个差值同时携带码点距离与在增长中输出里的插入位置。
- 自定界变长整数与自适应偏置让表示唯一且可逆,但它们不翻译、不规范化,也不证明 IDNA 有效、已经注册或对应某个身份。
Punycode 最醒目的部分是一串不易读的 ASCII 尾部,可它真正巧妙之处要从解码器看。解码器并不理解词义。它先摆好本来就能用 ASCII 表示的字符,再把其余码点一个个插入精确空位,直到还原原始序列。
Bootstring 的第一步叫基本码点分离。输入中的基本码点被原样复制到输出开头,相对顺序不变;只要至少有一个,后面就放一个分隔符。Punycode 的基本集合是 ASCII,分隔符是连字符。这个字面部分不是半份翻译,只是无需编码的部分。
分隔符后的尾部保存缺失结构。解码器维护 n 和 i:n 是候选码点值,i 是当前输出中的候选插入位置。状态沿所有空位单调前进;越过末端后,i 回到零,n 增加。一个 delta 表示在下一次插入前要跨过多少个“不插入”状态,然后把当时的 n 插到当时的 i。
于是一个非负整数同时描述两件事:在码点空间走了多远,以及落在序列哪里。编码器按非基本码点的数值顺序处理,通常能让相邻距离较小,再反推出会令解码器恢复原出现顺序的 delta。位置没有另建表格,而是嵌入状态步数。
多个 delta 连在一起,普通进位整数无法告诉解码器边界。Bootstring 使用广义变长整数:每一位都有阈值,某一位低于阈值时整数结束,而且恰好只有一个终止位置。小端次序使解码器能从前向后依次切开整数;在给定阈值下,每个非负值只有一种表示。
阈值还会随 delta 改变。每完成一次插入,算法根据刚出现的差值和已经处理的码点数更新 bias。第一次大跳跃受到更强抑制,后续差值则为下一次可能的数量级提供线索。这不是语言模型,只是一项局部算术预测,让相近数量级少花几个基本字符。
Punycode 把基数定为 36:字母对应零到 25,数字对应 26 到 35;n 从 128 开始,初始偏置是 72。参数影响效率,在满足 Bootstring 约束时并不改变正确性。实现还必须检查整数溢出。RFC 对合法 IDNA 标签给出的位宽上界,不能成为通用实现忽略算术边界的理由。
唯一性具有安全意义。若同一 Unicode 序列可以变成多个 ASCII 标签,它们可能落到不同 DNS 权威之下。Punycode 消除了这类一对多表示。可 RFC 3492 随即划清下一条边界:不同 Unicode 序列仍可能在某种规范化、语言或人类判断中被视为“同一文本”。编码器没有权力决定这种相同。
RFC 3490 把 Punycode 放进 IDNA;后来的 IDNA2008 保留 Punycode A-label,同时替换周围的准备与有效性规则。这正符合 Heng Lu 的最小初始规范:窄小而可逆的共同机制可以稳定存在,字符准入、本地映射与注册政策则在别处演进。
输入码点、准备后序列、字面前部、delta 尾部、重建序列、合格 A-label、注册记录、DNS 回答与身份识别是不同现实层。Punycode 只连接序列与 ASCII 表示。它的准确,不能被借来证明它从未判断的事情。
这也说明“看起来更短”不是证据本身。只有同时保存输入、参数、算术边界与往返结果,紧凑表示才可审计;否则尾部只是无法解释来源的记号。
来源
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance