
摘要
- 2026 年 9 月 4 日发布的
draft-ietf-cats-metric-definition-11新增运行章节,处理多厂商归一化约定、更新频率、陈旧值回退和告警;它仍是工作组 Internet-Draft,不是 RFC。 - CATS 可以把计算、通信与服务测量压成一个无单位、单字节的分数。编码一致,并不代表使用不同边界、权重或函数算出的分数可以直接比较。
- 新版要求把规则写进离线同步、受版本控制的配置清单。清单存在仍不等于所有组件已经加载;选中实例也不等于请求已经成功服务。
控制器面前出现两个八分。
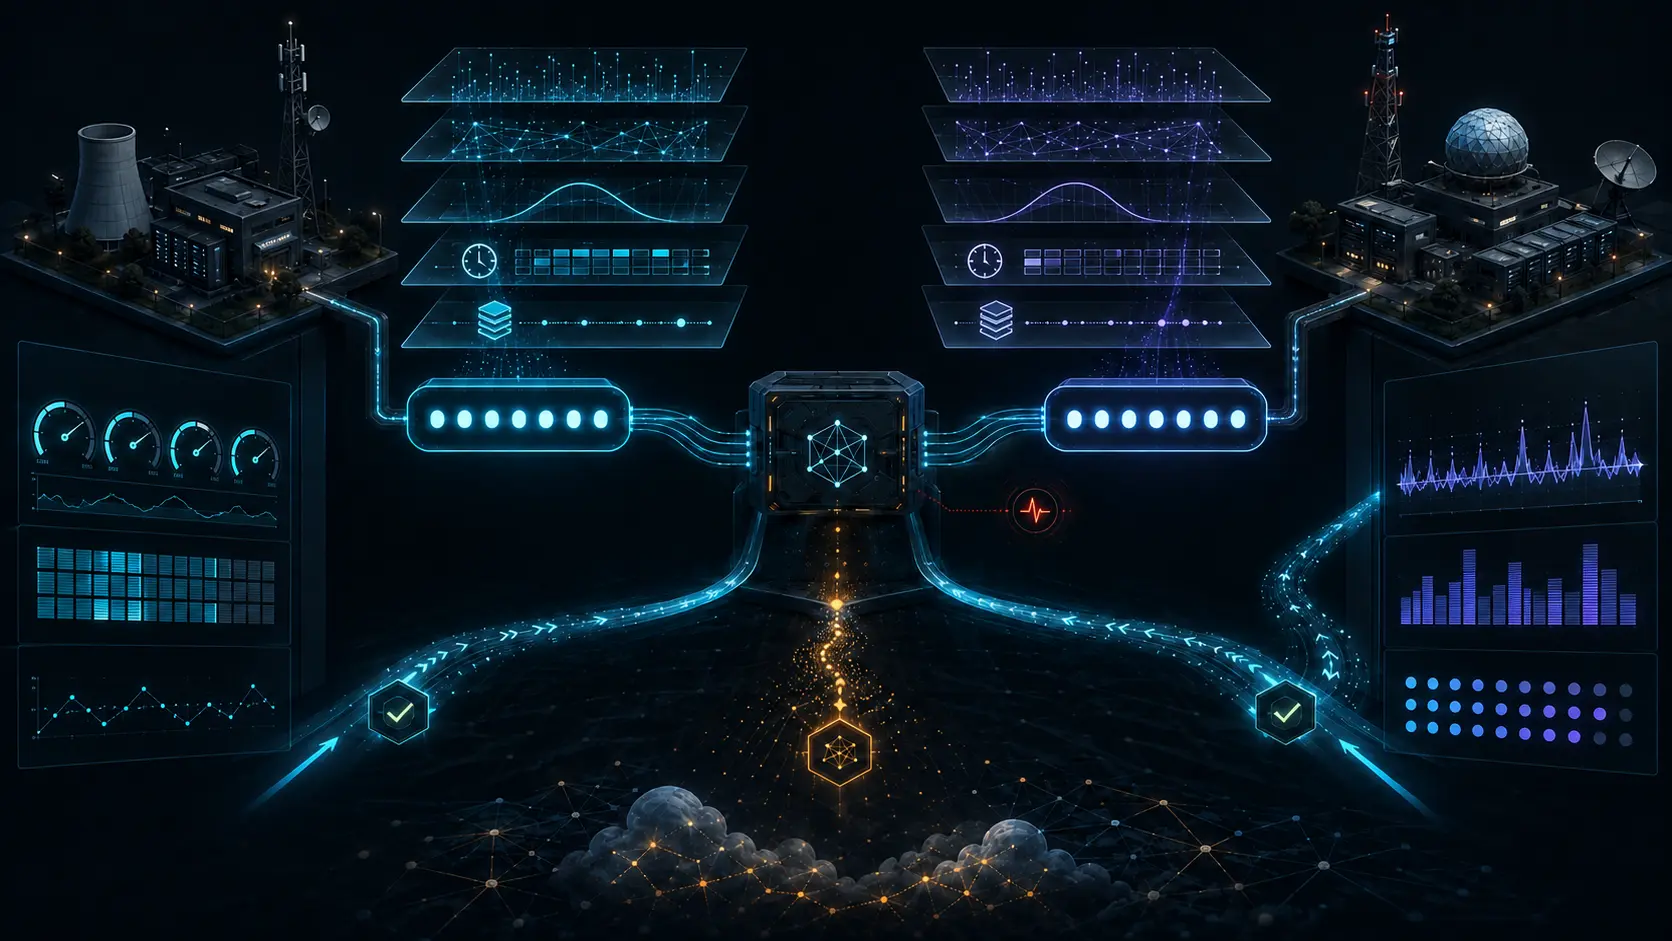
左边的实例把 CPU 余量和内存压力做 min-max 归一化;右边的实例把时延、队列深度和请求成功率按权重合成,再经过 sigmoid。两条消息格式合法、签名有效、时间新鲜。控制器如果只看最后一个字节,只能得出“相等”。
但这不是同一把尺子量出的相等。
CATS Metrics Definition 第 11 版的价值正在这里。Computing-Aware Traffic Steering 希望在选择服务实例时,同时考虑网络状态和算力、服务状态。CATS 框架把职责拆开:C-SMA 收集服务与计算信息,C-NMA 提供网络信息,C-PS 根据这些输入选路径。
指标被分成三层。Level 0 是平台相关的原始量,如处理能力、内存、网络时延、排队和请求速率。Level 1 把它们整理为 computing、communication、service 或 composed 类别。Level 2 再把下层信息压成一个全局归一化分数。
压缩解决了规模问题。网络设备不用理解成百上千个服务专用计数器,协议字段也不必随每种硬件扩张。草案自己的比较表同时承认代价:Level 0 编码复杂、精度高;Level 2 编码简单、稳定性高,但精度低。Level 2 只有一个字节,没有物理单位,来源只标为 normalization。
统一分值范围,不等于统一含义
草案建议把分数放在零到十之间,并举出 min-max 与 sigmoid 两类归一化方法。聚合可以取平均、最小、最大或加权平均。关键在于:这份草案并不标准化具体函数;公式和参数仍由实现与运营者政策决定。
min-max 的上下界一变,同一条原始测量就会换分。加权平均中 CPU 与时延的权重一变,系统实际偏好的资源也会改变。若一方规定高分更好,另一方却把时延原值按低分更优处理,那么相同整数甚至可能朝相反方向说话。
记录并非毫无上下文。Source 区分 nominal、estimation、directly measured、aggregation 与 normalization;Statistics 可说明最大值、最小值、平均值或当前值。Observation_Time 可以用 RFC 3339 时间标记观测瞬间,Validity_Interval 给出可用期;缺省时由本地政策决定。RFC 5835提供指标组合框架,RFC 9439支持来源分类。
这些字段能告诉接收者“这是什么类型的证据”,却不能重演“证据怎样变成这个数”。一条 Source: normalization 不会附带全部采样、异常值剔除、函数、边界、权重、校准负载和程序版本。签名正确的新分数,也可能忠实执行了一份过时规则。
第 11 版新增的 Section 7 正面处理这个问题。它说,在同一管理域内,不同厂商的 C-SMA、C-NMA 与 C-PS 必须对分数有一致理解,否则选择可能产生偏差。需要统一的不只是零到十,还包括归一化类型与参数、聚合公式与权重,以及究竟高分好还是低分好。
约定应编译成正式配置清单,纳入版本控制,并在初始化阶段离线同步。系统上线后,各组件默认别人发来的分数已经按约定计算;运行时不再动态协商。如果不能达成一致,可以把归一化或聚合集中到一个地方,或干脆选用一个明确的 Level 0 指标。
这是合理的最小共识,也是一条证据断点。代码仓库里有清单,不能证明每个实例加载了它。C-PS 接收了签名分数,不能证明发布者使用的是当前 hash。协议减少了运行时负担,运营记录就必须补上执行凭据。
控制面省下的流量,会变成决策里的不确定性
算力与服务状态变化很快,频繁发布又会压垮控制面。新章节建议每个实例在一个测量窗口内最多更新一次,并要求在数百或数千实例规模下计算总负荷。
降低负荷的每种办法都损失信息。把示例中的十秒窗口拉长到三十或六十秒,消息少了,状态也更旧。只发布 Level 2,控制器看不到是哪一类资源拖了后腿。只送 max、min、mean 或 cur,则是用不同统计问题替代完整序列。它们都不是免费的“优化”。
当指标源中断或无法通过新鲜度检查时,第 11 版给出一条回退链:先在有限时间内继续使用最后一个好值,例如两到三个窗口;超过陈旧阈值后降级或排除该实例;最后才退到只看网络的选择。新鲜度失败、C-SMA/C-NMA/C-PS 不可用、分数突然下跌或卡死、Level 1 与 Level 2 明显矛盾,都应触发告警。
若窗口是十秒,允许沿用三个窗口,那么一次中断可能让旧的八分继续支配约三十秒。这或许是连续性所需,但它不再是当前余量。审计记录必须区分观测时间、接收时间、最后好值开始使用的时间和真正排除的时间。
安全章节要求完整性、发布者认证、按服务授权、新鲜度与防重放、传输加密,因为这些指标直接影响转发。可密码学只能证明“谁发了这个八分,途中有没有被改”,不能证明传感器准确、权重合理或工作负载仍与校准环境相同。
分数之后,才是结果证据
Heng Lu 对现实层的区分让整条链不再混成一个仪表盘:原始观测是一层,统计窗口是一层,聚合与归一化是一层,C-PS 选择是一层,转发执行是一层,应用接收与用户结果又是下一层。前一层成功,不自动证明后一层发生。
运行代码优先要求保留可重演凭据:原始指标 ID、单位与来源,窗口与统计方法,清单 hash,发布端和接收端实际激活版本,分数与新鲜度判定,C-PS 输入,选中的 CSCI-ID,下发的转发动作,请求到达、错误、时延与完成结果。
最小初始规范与本地未来决策并不要求全球统一 CPU 权重。公共层可以只规定字段、来源、时间和清单身份;边界、权重、更新率与回退仍可由运营者决定。真正不能隐藏的,是哪一项本地决定改变了流量去向。
第 11 版没有证明 CATS 已部署,也没有证明单分数能改善性能。它做了一件更克制的事:承认分数的含义在运行前配置,运行中只是被假定。两个八分能否比较,不能等事故发生后才从配置碎片里猜。
来源
- https://datatracker.ietf.org/doc/draft-ietf-cats-metric-definition/
- https://www.ietf.org/archive/id/draft-ietf-cats-metric-definition-11.txt
- https://www.ietf.org/archive/id/draft-ietf-cats-metric-definition-10.txt
- https://datatracker.ietf.org/doc/draft-ietf-cats-framework/
- https://www.ietf.org/archive/id/draft-ietf-cats-framework-24.txt
- https://datatracker.ietf.org/doc/draft-ietf-cats-usecases-requirements/
- https://www.rfc-editor.org/rfc/rfc5835.html
- https://www.rfc-editor.org/rfc/rfc8911.html
- https://www.rfc-editor.org/rfc/rfc8912.html
- https://www.rfc-editor.org/rfc/rfc9439.html
- https://www.rfc-editor.org/rfc/rfc3339.html
- https://heng.lu/running-code-primary-the-patch-needed-to-preserve-the-internet-original-design/
- https://heng.lu/on-reality-layers-symbolic-power-and-why-clarity-feels-so-hostile/
- https://heng.lu/minimum-initial-specification-localized-future-decision-voluntary-adoption-internet-coordination-system/
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance