
摘要
- RFC 3557 每 10 毫秒生成一个 44 位特征向量,两个向量组成代表 20 毫秒语音的帧对,再加 4 位 CRC 与填充成为 12 字节固定单元。
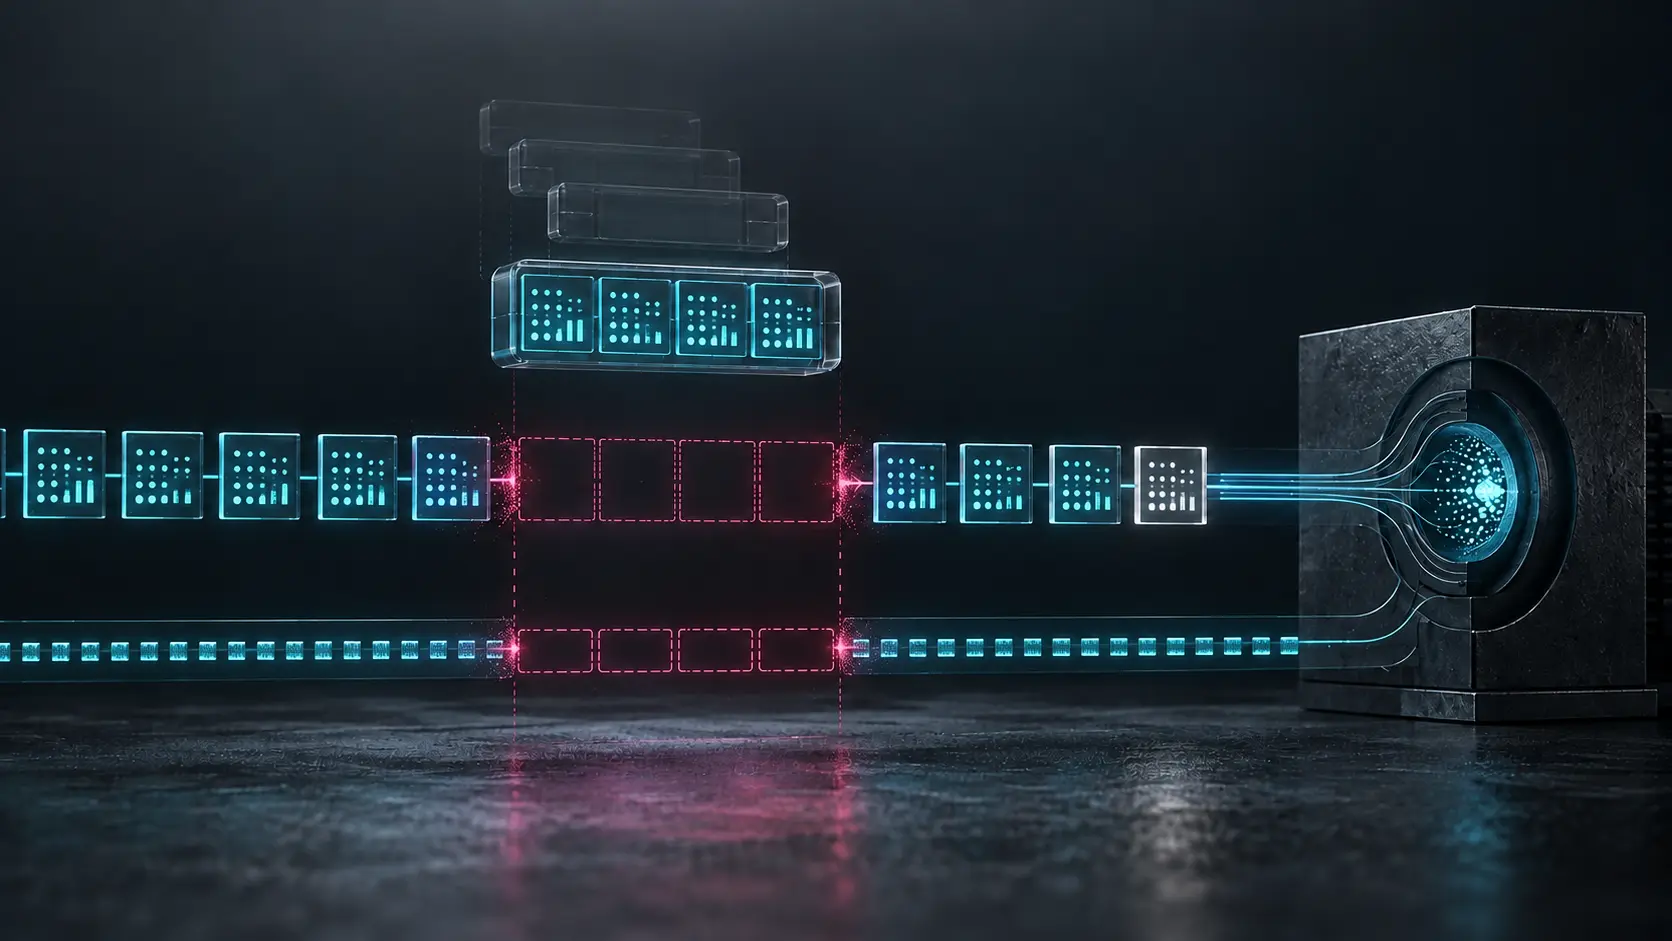
- 一个 RTP 包聚合更多帧对会降低报头占比,却增加等待时间,并让一次丢包覆盖更长的连续特征。CRC、时间戳与 Null FP 都不能替识别结果作证。
RFC 3557 于 2003 年 7 月以 Proposed Standard 身份发布,用于把终端计算的分布式语音识别特征送往识别引擎。它规定格式与选择空间,不报告任何真实用户或识别成绩。
先分清特征单元和传输单元
一个 FP 包含两个连续 10 毫秒向量,四位 CRC,随后四个零填充位,总长 96 位。载荷可以把多个 FP 连续拼接。RTP 时间戳对应首个 FP 的首个采样时刻,并随采样率按每 FP 160、220 或 320 递增。
CRC 只能检查已经收到的 FP。它不是来源认证,不会修复丢失,也不能检查从未到达的内容。剩余 FP 全部通过 CRC,与序列完整并不矛盾。
记录要同时保留 FP 身份、捕获区间、CRC,以及 RTP 序号、时间戳和成员清单。只有这样,序号跳一格时才能回答少了多少个 FP、多少毫秒,而不是笼统写“丢了一个包”。
聚合改变一次失败的语义半径
每包一个 FP,发送等待短、一次丢失覆盖 20 毫秒,却重复更多 IP/UDP/RTP 报头。每包多个 FP 能摊薄报头,但发送方要等数据聚齐,识别延迟上升;丢失时连续缺口也更长。
规范指出,大量连续 FP 丢失是多数识别器难以处理的情形,因此建议在满足带宽效率前提下尽量减少每包 FP,并考虑报头压缩。
这不等于小包永远更好。受限链路、处理开销、竞争和压缩状态都会影响选择。治理要求是让网络效率与识别质量共享同一配置版本,不能只让一个仪表盘决定。
maxptime 是风险参数
maxptime 表示一个包最多承载多少毫秒媒体,应为 20 毫秒的整数倍。缺省时按 80 毫秒;预期丢包较高时可以明确选择更短值。
80 毫秒意味着四个 FP 可以同行。与四个独立包相比,它节省三组报头,也把四个连续 FP 放进一个故障单元。配置记录应说明采用它时的丢包假设、延迟预算、压缩能力和引擎容忍度。
SDP 里的数值只是声明。运行中要根据 RTP 时间与实际成员验证发送方是否遵守。超出上限不是元数据瑕疵,而是未经批准扩大缺口。
RFC 2508 与 RFC 3095 提供报头压缩邻近方案,说明提高效率并非只能靠聚合。RFC 2198 的冗余载荷也不能被想当然地套进本格式;多个主 FP 同包不等于有副本。
Null FP 只结束发送方的一段时间
DTX 允许终端仅在检测到语音时发送。连续非语音帧超过 hangover 阈值后,发送方认定一个 transmission segment 结束;1.5 秒只是规范列出的典型值。随后应发送一个或多个 Null FP。
Null FP 把两个特征字段置零,照常计算 CRC 并填充。它表达“发送方认为这段结束”。它不能证明前一个载荷到达。
于是可能出现一个漂亮结尾跟在一个隐蔽缺口之后。若引擎用 Null FP 把段落标为完整,就让终点信号替丢失内容作证。正确记录包括最后真实 FP、Null 发送、序号缺口、引擎关段和未解决的不确定性。
识别链在 RTP 之后继续
引擎还要重排、解包、检查、处理缺口、决定是否隐蔽或拒绝,再以特定模型生成假设与置信度。应用随后决定是否重问、拒绝、确认或执行动作。
包到达不等于引擎摄取,引擎完成不等于识别正确,识别结果也不自动授权应用动作。每个主语必须留下自己的回执。
报头压缩让决策不必二选一
RFC 3557 指向 RFC 2508 与 RFC 3095 所描述的 IP、UDP、RTP 报头压缩。这一点改变了决策空间:降低报头成本不一定只能依赖扩大聚合。若压缩上下文稳定可用,就可能在保持较短媒体间隔的同时降低开销。
但“支持压缩”不是运行证据。上下文可能尚未建立、已经失效,或频繁进入修复。策略记录需要写明实际采用的压缩方式、上下文状态、有效报头尺寸、修复次数和生效路径,不能只写一个能力开关。
RFC 2198 提供相邻的冗余音频背景,但 RFC 3557 的聚合本身不会自动生成冗余副本。把四个主要 FP 放进同一个包,只是让它们共享同一次交付命运;一个数据报消失时,整个聚合区间都可能消失。
缺口必须成为独立的审计对象
可辩护的时间线应分别保留:采集区间、特征向量、FP 配对、CRC、包内清单、RTP 序号与时间戳、网络到达、重排或丢失分类、引擎接收、缺失处理、模型输出和应用处置。后一步成功不能自动补齐前一步缺失的凭据。
这也让策略变更可以比较。扩大聚合之前,应记录当前丢包分布、压缩状态、端到端延迟、引擎容忍度与重试率;变更之后,用同一组指标和明确的策略版本复查。没有版本,识别信心变化只是无主的相关性,网络节省也无法与服务后果对账。
仪表板至少应并排呈现两条轴:节省了多少报头字节,以及一次丢失暴露了多少连续毫秒。只报包数会把 20 ms 与 80 ms 的缺口描绘成同一个事件;只报识别错误,也无法区分输入不完整和模型在完整输入上做错判断。
比较还必须保留策略真正生效的时间。若月度平均值混合了两种聚合规则,最需要审查的切换点反而会消失。按策略版本、路径和生效窗口切分观测,才能判断变化来自包策略、网络条件、引擎处理还是模型更新,而不是把任何结果笼统归因于 RFC。
当证据不足时,正确结论不是“聚合导致了识别失败”,而是“这个连续区间没有交付,后续结果缺少足够的归因链”。前者超出记录,后者既保留不确定性,也明确指出下一次运行应补充哪些收据。
证据边界
本文不指认用户、声音、语言、终端、引擎、模型、运营商、服务或事故,不声称丢包率、识别率、采用率或最优聚合值。80 毫秒例子来自 RFC 缺省值。
RTP、SDP、压缩和冗余 RFC 仅提供相邻机制边界,不证明部署。Heng Lu 关于运行代码优先与最小初始规范的文章是公开说明的编辑视角,用于区分格式、实现和结果,不是 RFC 作者意图的证据。
结论只到这里:聚合可以省报头,同时把更长连续特征交给一次丢包。协议字段能量出缺口;只有引擎、模型和应用的后续证据能说明后果。
Sources
- https://www.rfc-editor.org/rfc/rfc3557.html
- https://www.rfc-editor.org/info/rfc3557
- https://datatracker.ietf.org/doc/rfc3557/
- https://www.rfc-editor.org/rfc/rfc3550.html
- https://www.rfc-editor.org/rfc/rfc3551.html
- https://www.rfc-editor.org/rfc/rfc2327.html
- https://www.rfc-editor.org/rfc/rfc8866.html
- https://www.rfc-editor.org/rfc/rfc2508.html
- https://www.rfc-editor.org/rfc/rfc3095.html
- https://www.rfc-editor.org/rfc/rfc2198.html
- https://www.rfc-editor.org/rfc/rfc8174.html
- https://heng.lu/running-code-primary-the-patch-needed-to-preserve-the-internet-original-design/
- https://heng.lu/minimum-initial-specification-localized-future-decision-voluntary-adoption-internet-coordination-system/
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance