Résumé
- Après un échec RRDP, un validateur peut conserver un cache antérieur, télécharger un instantané bien plus lourd ou se rabattre sur rsync ; aucun minuteur universel n’impose le même choix à tous.
- La rétention des deltas, la fraîcheur des manifests et les seuils du validateur répartissent le coût de la reprise entre services de publication, opérateurs de réseau et détenteurs de ressources.
- Un contrôle HTTP au vert ne suffit pas : il faut un reçu de reprise par dépôt et une comparaison indépendante des charges utiles validées.
À 9 heures, un validateur demande le prochain petit delta d’un dépôt RPKI. La référence figure dans le fichier de notification, mais le fichier n’arrive pas. Un validateur conserve le dernier cache récupéré avec succès. Un deuxième demande l’instantané complet. Un troisième attend une échéance aléatoire avant d’essayer rsync. Les trois décisions peuvent être défendables. Elles ne produisent pas forcément le même « présent » à la même minute.
C’est en ce sens que la reprise des dépôts devient un point de contrôle du routage. On présente souvent la RPKI à partir de l’objet signé : le détenteur d’une ressource autorise une origine, une relying party la valide, puis un routeur applique sa politique de validation d’origine.
En exploitation, l’intention signée doit d’abord quitter l’autorité de certification, être publiée, traverser le transport du dépôt, passer les contrôles de manifest, de certificat et de révocation, puis être convertie en charge utile validée. Une signature peut rester parfaitement correcte tandis qu’un incident de distribution modifie les preuves accessibles à l’étape suivante.
Du delta à l’instantané, puis au secours
Le RFC 8182 définit trois éléments pour RRDP. Le fichier de notification identifie une session et un numéro de série. Les deltas transportent les modifications incrémentales. L’instantané contient une vue complète et actuelle. Si une chaîne continue de deltas relie le cache local au dernier numéro, le validateur suit la voie légère. S’il manque un delta ou si celui-ci est rejeté, il passe à l’instantané.
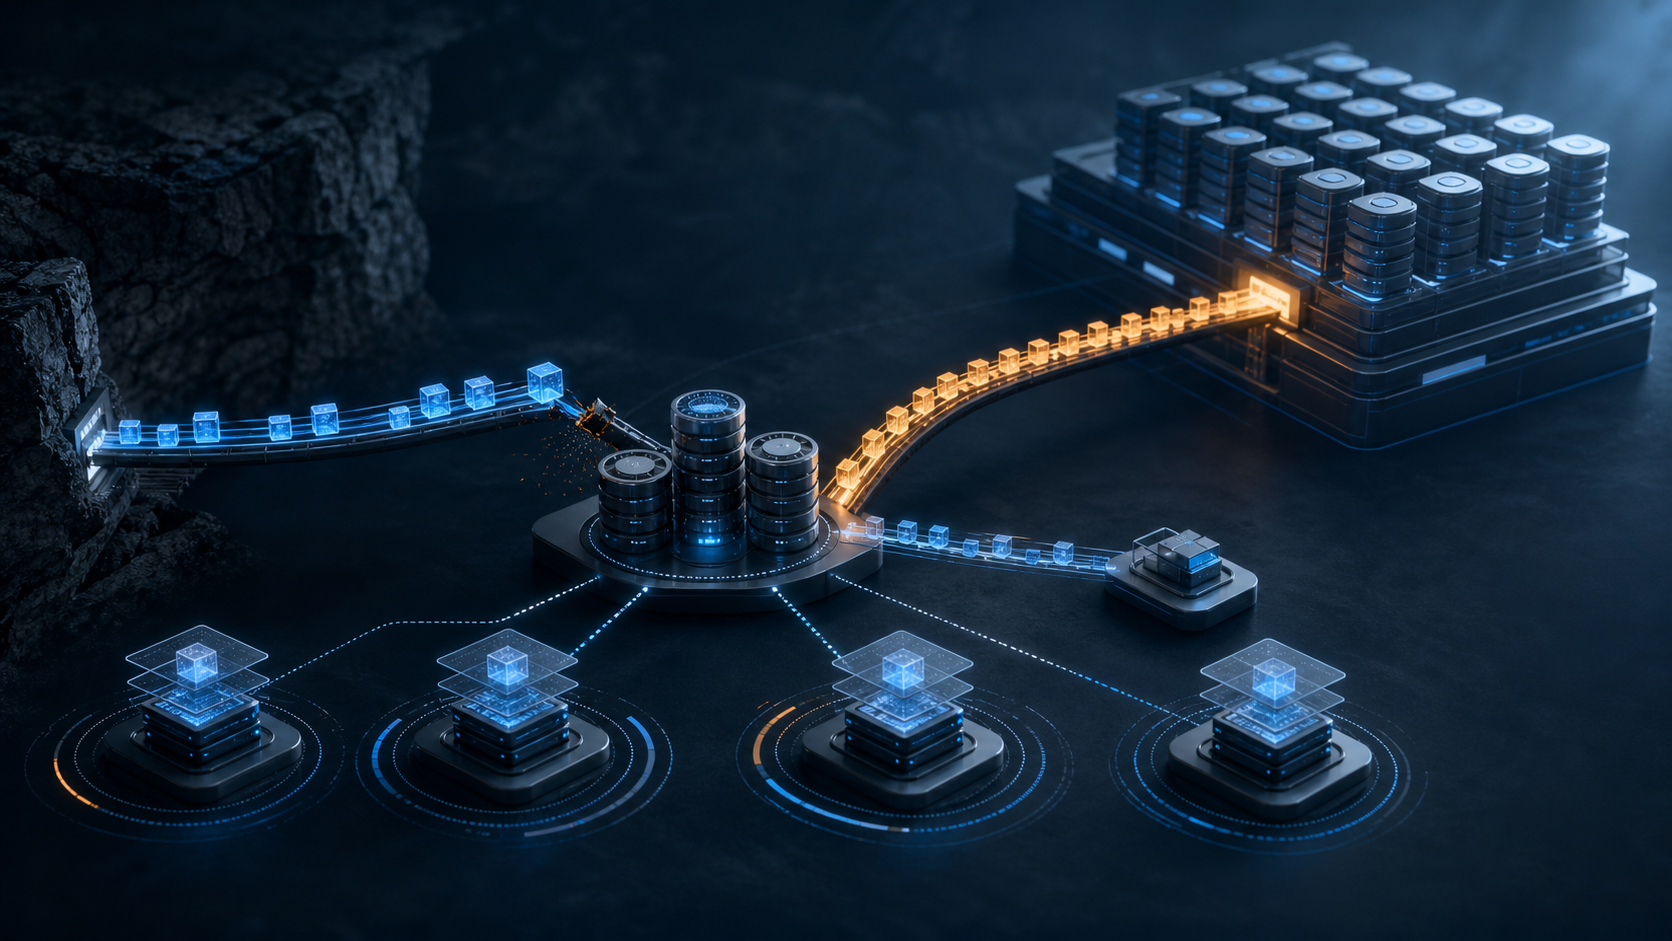
Les deux chemins n’ont pas le même coût. Un delta peut être petit ; un instantané atteint parfois des dizaines ou des centaines de mégaoctets. La dernière version, datée de mai 2026, du projet SIDROPS sur les services de publication décrit une cascade concrète : après l’échec d’un ou plusieurs deltas, la relying party tente généralement l’instantané, plus lourd ; si celui-ci échoue aussi, elle peut basculer sur rsync ; à l’essai RRDP suivant, elle repart souvent de l’instantané. Une surcharge peut donc provoquer une reprise qui accroît encore la demande. Le colis de secours est plus lourd au moment précis où le quai fonctionne le moins bien.
Le texte reste un Internet-Draft de groupe de travail, pas un RFC. Ses chiffres sont néanmoins délimités. Dans un grand dépôt observé en janvier 2024, une notification contenant 144 deltas sur 14 heures a représenté 251 Go sur 55,5 To de trafic total, soit moins de 0,5 %. Conserver davantage de deltas aide un validateur en retard à rattraper l’état par incréments, mais allonge la notification lue par tous.
En conserver moins allège le régime ordinaire et pousse davantage de clients vers l’instantané. Le projet recommande au moins quatre heures de deltas parce que certaines instances de relying parties ne se synchronisaient que toutes les une à deux heures en 2024. Le réglage ne supprime pas le coût ; il choisit son moment et son payeur.
Le validateur ajoute sa propre politique. La documentation actuelle de Routinator propose trois comportements de repli rsync après un échec RRDP : never, stale et new. Le défaut documenté est stale : continuer à utiliser la copie RRDP locale tant qu’elle est considérée comme actuelle, puis essayer rsync après un délai choisi aléatoirement pour chaque dépôt. La borne maximale par défaut est de 3 600 secondes. Cette dispersion évite que tous les validateurs se présentent en même temps à l’entrée secondaire.
Routinator documente aussi des seuils qui changent le chemin de reprise : passer à l’instantané si plus de 100 deltas sont nécessaires ; considérer vide une liste de plus de 500 deltas ; accorder 600 secondes au téléchargement d’une ressource RRDP, 10 secondes à une lecture et 300 secondes à une commande rsync. Ce sont les valeurs par défaut d’un produit, non des constantes de la RPKI. Les modifier transforme un même incident en une autre séquence de requêtes et de décisions de cache.
Le cache appartient à la chaîne de preuve
Le RFC 9286 indique qu’après un échec de récupération, une relying party devrait utiliser les données issues de la précédente récupération réussie jusqu’à ce qu’une nouvelle réussisse. Cette règle évite d’interpréter une vue incomplète comme une nouvelle intention de routage. Elle signifie aussi que la disponibilité instantanée d’un point HTTPS ne révèle pas l’âge des preuves qui pourront atteindre un routeur.
Les manifests bornent cette continuité. Ils énumèrent les objets que l’émetteur entend publier et permettent de détecter suppression, substitution ou rétention d’une version nouvelle. Ils signalent une différence mais ne réparent pas l’objet manquant. thisUpdate, nextUpdate, les CRL et la validité des objets donnent donc au cache une fenêtre finie.
Le projet SIDROPS de 2026 explicite l’arbitrage. Une validité plus longue laisse davantage de temps pour restaurer un service, mais étend la fenêtre de rejeu. Une validité plus courte réduit cette exposition et augmente les réémissions.
Dans un grand dépôt, le passage d’un cycle de réémission de 24 à 48 heures a réduit d’environ moitié l’usage de données, la plupart des changements venant des manifests et CRL plutôt que de nouvelles ROA ou ASPA. Ce n’est pas un coefficient mondial. C’est une observation utile sur la répartition du pouvoir : l’autorité de certification choisit le rythme ; le service de publication et toutes les relying parties en traitent la charge.
Les normes continuent de préciser les cas de reprise. Le RFC 9981, publié en mai 2026, traite du cas exceptionnel où le numéro d’un manifest atteint sa valeur maximale. Il relève qu’avant cette règle, certaines implémentations auraient attendu l’expiration du manifest courant, tandis que d’autres auraient rejeté les suivants indéfiniment. Un comptage normal n’atteindra pratiquement jamais la limite ; un bogue ou une mauvaise configuration est le scénario crédible. L’intérêt de l’exemple n’est pas sa fréquence, mais la preuve qu’une bordure de reprise insuffisamment spécifiée peut produire des états utilisables différents.
Capacité et sécurité ne progressent pas ensemble
Le repli sur rsync peut améliorer l’accessibilité tout en affaiblissant la protection du transport. RRDP diffuse par HTTPS des deltas et instantanés immuables et faciles à mettre en cache. Rsync impose davantage de travail par connexion au serveur et n’assure pas lui-même la confidentialité et l’intégrité du canal. Le modèle de menace de Routinator indique qu’un adversaire sur le chemin peut dégrader RRDP et provoquer un basculement vers rsync. Les signatures et manifests doivent alors porter davantage de la défense.
En 2020, NLnet Labs illustrait le risque de capacité par un modèle prospectif : 150 000 validateurs interrogeant toutes les dix minutes représenteraient environ 250 requêtes par seconde, contre quelque trois requêtes par seconde pour le service rsync de secours envisagé à l’époque. Ce ne sont pas des mesures de 2026. Elles expliquent le choix d’un repli retardé et distribué plutôt que d’une ruée instantanée.
Un calcul de sensibilité suffit, sans inventer un total mondial. Prenons 10 000 validateurs, une mise à jour ordinaire de 1 Mo et un instantané compressé de 100 Mo. Une ronde entièrement incrémentale transfère 10 Go. Si seulement 20 % des clients passent à l’instantané, l’ordre de grandeur atteint 208 Go : 8 000 Mo de deltas et 200 000 Mo d’instantanés. Les tentatives répétées et le coût de calcul de rsync viennent en plus. Le pic dépend moins du nombre brut de validateurs que de la largeur temporelle dans laquelle ils reprennent.
Un dépôt peut ainsi être « disponible » et servir une reprise incohérente. Un répartiteur peut exposer la notification d’un nœud avant que le delta ou l’instantané référencé n’ait atteint les autres. Une connexion persistante peut traverser un basculement et renvoyer une session plus ancienne. Le projet SIDROPS exige une vue cohérente entre nœuds et note que le RFC 8182 ne définit pas une réponse unique à la régression du numéro de série ; certaines implémentations se resynchronisent par instantané. Le moniteur reçoit un code 200. Le validateur reçoit une chronologie cassée.
Les sources ne donnent pas un taux mondial de divergence et ne prouvent pas qu’un dépôt nommé ait causé un incident de routage. Elles établissent le mécanisme, les paramètres et le transfert de coût. C’est suffisant pour construire un essai contrôlé.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance