
Résumé
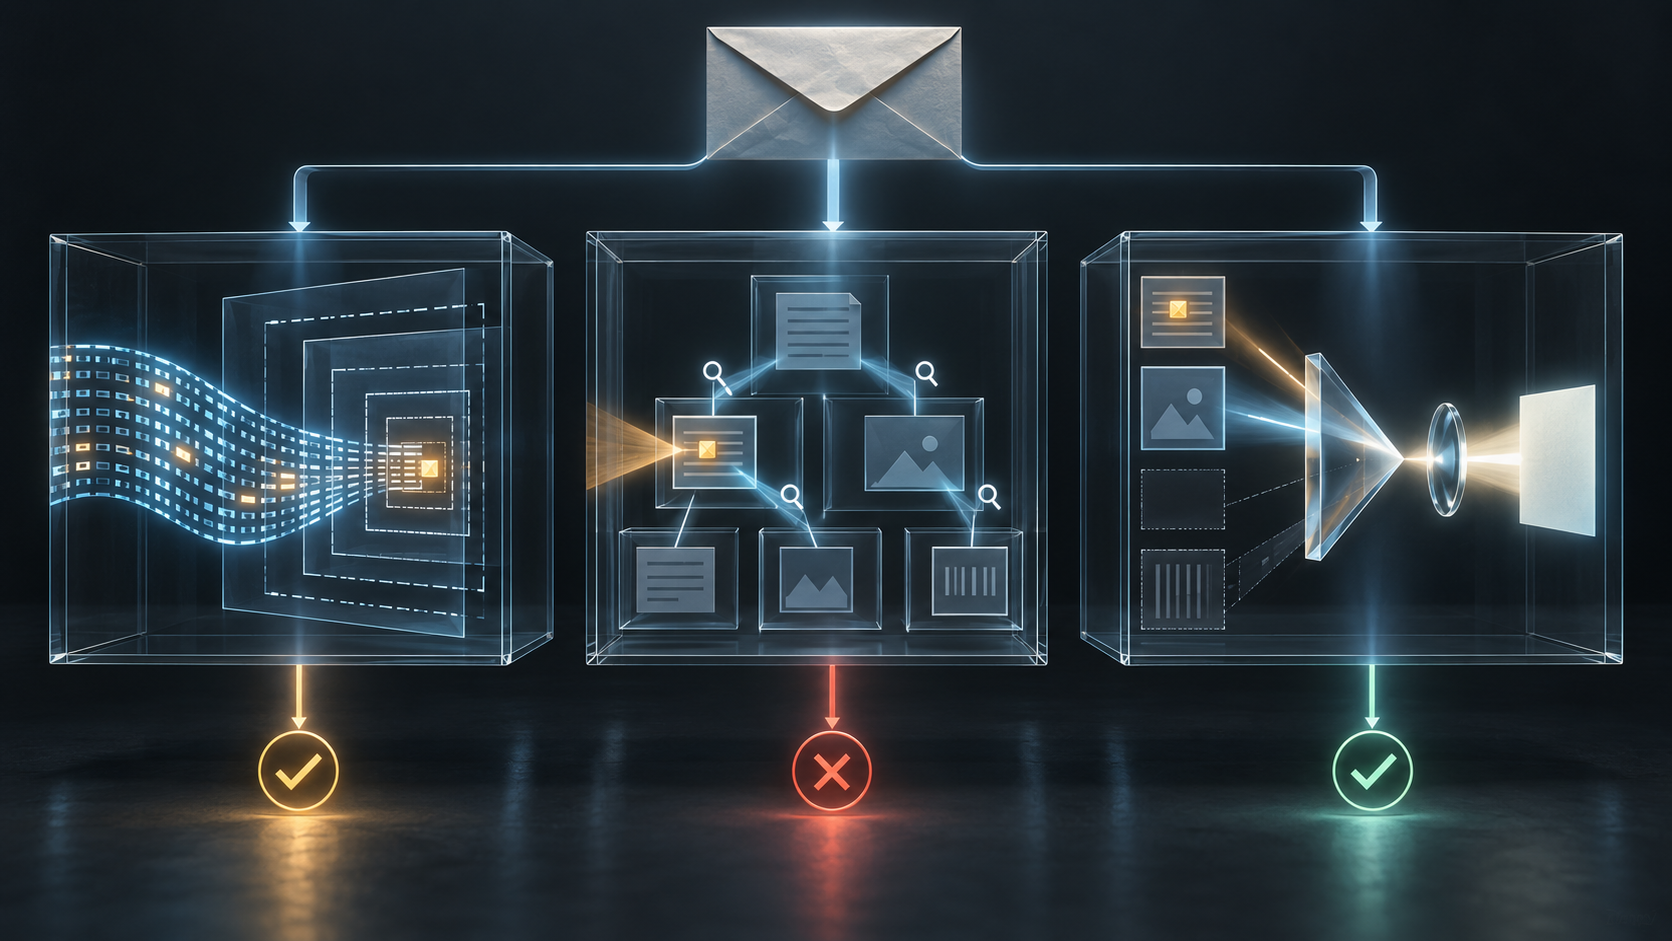
:rawconserve la représentation non décodée,:contentchoisit des parties MIME et:textdépend d’une extraction de texte au mieux des capacités locales. Le booléen final ne décrit pas une surface unique.- Pour reproduire un filtrage important, il faut garder le message, le moteur, la transformation, le comparateur, les échecs de conversion et les parties omises. Une correspondance n’est pas une preuve d’intention ou de danger.
Un lecteur voit un message. Le filtre voit une construction. Après l’en-tête extérieur, une ligne vide délimite le corps ; sans ce séparateur, un message composé seulement d’en-têtes fournit un ensemble vide et tous les tests body échouent, même celui qui cherche une chaîne vide. La première différence apparaît avant le moindre mot-clé.
Le RFC 5173 transforme ensuite le corps en chaînes. Elles ne correspondent pas automatiquement à chaque ligne physique et contiennent souvent des CRLF. Le comparateur et le type de correspondance décident ce que signifie le motif. Dire « le corps correspond » omet donc la partie la plus importante : quel corps a été construit ?
Raw conserve aussi les artefacts de transport
Avec :raw, le corps non décodé devient un seul élément. Les encodages de transfert restent en place. Les frontières multipart et les en-têtes MIME des parties incluses deviennent du contenu recherchable. Une erreur de syntaxe n’écarte pas le message, sauf si l’environnement l’a déjà rejeté.
Cette fidélité répond à une question précise sur la représentation reçue. Elle ne répond pas à la question de ce qu’une personne a lu. Une chaîne peut apparaître dans une frontière, dans du base64 ou dans un champ Content-Type interne. Le résultat prouve la présence d’octets sur la surface raw, pas leur rôle sémantique.
Comme toute la matière forme un élément, un motif peut aussi traverser une zone qu’une analyse MIME divisera. Remplacer une règle raw par une règle structurée change le domaine du test, même si le fichier source et le courriel restent identiques.
Content choisit des branches de l’arbre
:content sélectionne les parties selon le type MIME déclaré. Un type et sous-type complets visent la valeur exacte ; un type seul inclut ses sous-types ; une sélection vide accepte tous les types. Une barre oblique mal placée ou répétée ne provoque pas une recherche large : elle ne sélectionne rien.
La traversée descend récursivement dans les multiparts et les messages encapsulés. Chaque partie admissible est testée séparément et un motif ne peut pas franchir une frontière MIME. Deux fragments voisins à l’écran peuvent donc ne jamais former la même chaîne pour la règle.
Le prologue et l’épilogue d’un conteneur multipart sont des chaînes propres. Dans un message/rfc822, l’en-tête interne peut être testé séparément des corps imbriqués. Le chemin du résultat fait partie de sa signification.
Le moteur décode les encodages courants et convertit du texte vers UTF-8. Mais une partie impossible à décoder ou convertir peut être lue comme US-ASCII, ignorée ou soumise à une convention locale. L’échec d’une règle peut ainsi signifier « partie omise », et non « information absente ».
Text délègue une politique au moteur
:text, la valeur par défaut, demande le meilleur effort de l’implémentation. Un moteur simple peut l’assimiler à :content "text". Un moteur plus riche peut retirer le balisage, convertir un document propriétaire ou lancer une reconnaissance optique sur une image. Le nombre de chaînes produites n’est pas normalisé entre ces choix.
Cette latitude permet l’innovation, mais elle rend la migration observable. Une nouvelle bibliothèque de caractères, un convertisseur ajouté ou une version d’OCR peut faire apparaître un terme auparavant invisible. Le script n’a pas changé ; sa dépendance effective, si.
Le défaut :text est donc une configuration implicite. Sans inventaire du moteur et de ses extracteurs, deux fournisseurs peuvent exécuter le même code conformément au RFC et prendre des décisions différentes.
Le verdict de sécurité doit rester séparé
Le RFC avertit qu’une recherche raw peut être plus générale que prévu et qu’une correspondance textuelle ne remplace pas un système antispam, antivirus ou autre contrôle de sécurité. Il impose aussi de limiter les ressources pour qu’un usage malveillant du test ne prive pas les autres utilisateurs de service.
Un résultat positif ne démontre ni l’intention de l’expéditeur ni la nocivité du message. Un résultat négatif ne démontre ni l’absence du contenu ni son innocuité. La sélection de type, les frontières, l’encodage, la conversion et les capacités de l’extracteur se trouvent entre les octets et le booléen.
Le RFC 5229 garde son propre sujet : les variables et captures du script. Les jokers du test body ne remplissent pas ${1} et suivants. Cette séparation empêche une correspondance de devenir une mémoire cachée ; elle ne rend pas le corps complet.
Sources
- https://www.rfc-editor.org/rfc/rfc5173.html
- https://www.rfc-editor.org/rfc/rfc5173.txt
- https://www.rfc-editor.org/info/rfc5173
- https://datatracker.ietf.org/doc/rfc5173/
- https://datatracker.ietf.org/doc/rfc5173/history/
- https://datatracker.ietf.org/doc/rfc5173/references/
- https://www.rfc-editor.org/errata/rfc5173
- https://www.iana.org/assignments/sieve-extensions/sieve-extensions.xhtml
- https://www.rfc-editor.org/rfc/rfc5228.html
- https://www.rfc-editor.org/rfc/rfc5229.html
- https://www.rfc-editor.org/rfc/rfc5703.html
- https://www.rfc-editor.org/rfc/rfc2045.html
- https://www.rfc-editor.org/rfc/rfc2046.html
- https://www.rfc-editor.org/rfc/rfc3629.html
- https://heng.lu/on-reality-layers-symbolic-power-and-why-clarity-feels-so-hostile/
- https://heng.lu/minimum-initial-specification-localized-future-decision-voluntary-adoption-internet-coordination-system/
- https://heng.lu/running-code-primary-the-patch-needed-to-preserve-the-internet-original-design/
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance