
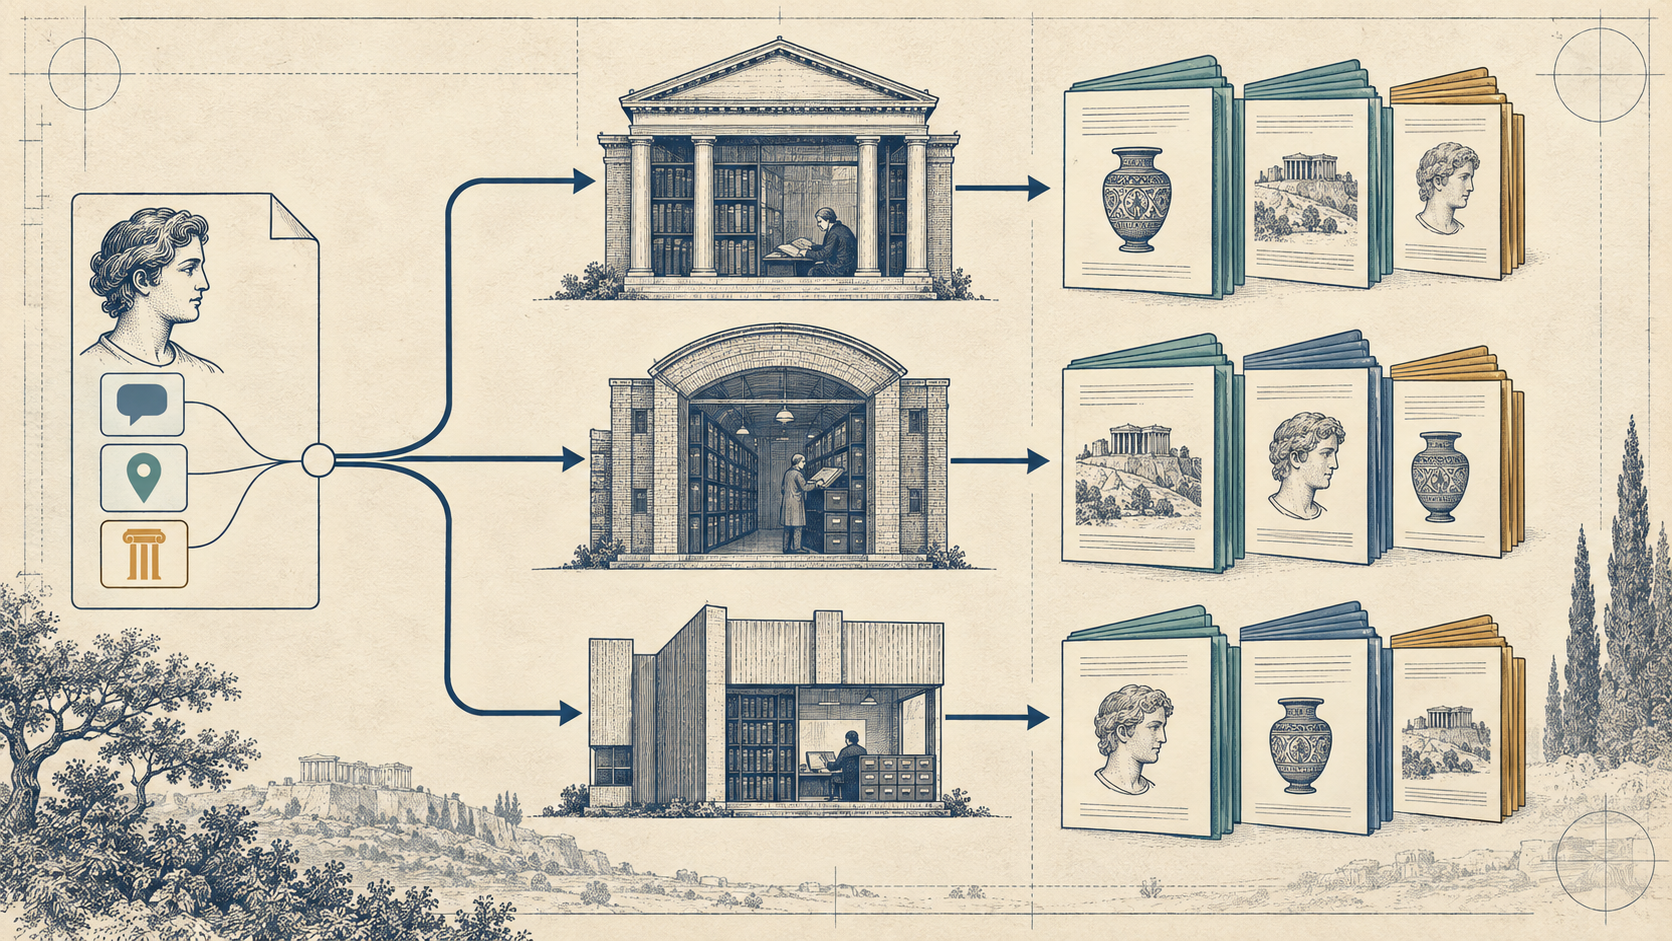
Résumé
- La RFC 3367 rendait la langue, la géographie et la catégorie disponibles comme propriétés communes, mais les définissait comme des indices, non comme des filtres obligatoires.
- Le protocole harmonisait la structure de la question ; la correspondance, le classement et le sens pratique de la pertinence restaient propres à chaque service.
Un nom ne désignait pas une réponse unique
Les noms usuels sont des mots ou des expressions, pas des identifiants mondiaux uniques. « Mercury » peut désigner une planète, une entreprise, une personne ou un produit ; un même service peut aussi associer plusieurs fiches à un nom. La RFC 3367 s’attaquait donc à un problème circonscrit : permettre à un client d’interroger des services sur des fiches liées à un nom. Elle ne définissait ni découverte ou sélection des services, ni enregistrement, ni propriété, ni garantie d’unicité. CNRP était un protocole de requête, pas une autorité de nommage.
Un vocabulaire commun, pas un verdict commun
Le protocole ne se limitait pas à une chaîne de caractères. Ses propriétés fondamentales couvraient le nom, la langue, la géographie, la catégorie et une plage de résultats. Un client pouvait commencer par un ServiceQuery pour connaître les propriétés prises en charge ; un service pouvait aussi annoncer des types de données supplémentaires.
Mais la RFC refusait de transformer ces champs en critères universels. Elle les appelait des « indices » : le contexte et les préférences du client. Leur ordre pouvait signaler une priorité, mais le service restait libre de les ignorer et devait tenter de fournir la meilleure correspondance. Des propriétés différentes se combinent par ET ; plusieurs valeurs d’une même propriété, par OU. Malgré cela, la réponse n’a pas à satisfaire chaque critère. « Français » et « Paris » peuvent guider une recherche sans exclure tous les autres résultats.
Le choix décisif se trouve là : le format transmis pouvait être interopérable tandis que les réponses demeuraient propres à chaque service. L’un pouvait accorder beaucoup de poids à la langue, l’autre peu. La RFC ne fixait ni formule commune de pondération ni règle universelle pour départager les résultats.
L’encodage ne règle pas le sens
UTF-8 permettait l’échange de texte et les balises de langue fournissaient une forme structurée pour indiquer les langues. Aucun de ces mécanismes ne disait si deux graphies, translittérations ou noms étaient équivalents. La RFC 3367 laissait les règles de correspondance dépendre du service et de la langue. Un encodage conserve une chaîne ; il ne décide pas ce qu’elle désigne.
Le classement restait lui aussi local. Un service pouvait ordonner ses résultats selon sa propre appréciation de la pertinence. Des listes issues de services distincts ne devenaient pas comparables simplement parce qu’elles utilisaient CNRP. La RFC 3368, consacrée à l’URI go:, pouvait désigner un service ou une fiche précise, voire porter une requête plus large, sans abolir cette répartition des responsabilités.
La limite de l’interopérabilité
La RFC 3367 normalisait la syntaxe des préférences, l’échange sur les capacités et la logique générale de combinaison des champs. Elle laissait l’équivalence sémantique et l’ordre final aux opérateurs. Ce n’est pas un défaut caché dans les détails : c’est la frontière de conception du protocole. Un vocabulaire commun permet aux systèmes de communiquer sans rendre leurs jugements identiques.
La grille de lecture de Lu Heng sur la primauté du code en fonctionnement éclaire cette distinction, sans aller plus loin : une spécification décrit ce que les implémentations peuvent échanger ; l’expérience dépend des services qui le mettent réellement en œuvre. La RFC décrit une conception, non son adoption ni ses retombées commerciales. Son intérêt historique est plus précis : elle rendait les préférences portables tout en gardant la pertinence locale.
Sources
- RFC 3367 — Common Name Resolution Protocol
- RFC 3368 — schéma d’URI
go: - RFC 1766 — balises de langue
- RFC 2277 — politique de l’IETF sur les jeux de caractères et les langues
- RFC 3629 — UTF-8
- RFC 5646 — balises de langue
- RFC 2119 — mots-clés utilisés dans les RFC
- RFC 2396 — syntaxe générique des URI
- RFC 2616 — HTTP/1.1
- RFC 3986 — syntaxe générique des URI
- RFC 3987 — identifiants de ressources internationalisés
- Notice de publication de la RFC 3367
- Notice RFC 3367 dans l’IETF Datatracker
- Registre IANA des types de média
- Lu Heng, « Running-Code Primacy »
- Lu Heng, « Reality Layers, Symbolic Power, and Why Clarity Feels So Hostile »
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance