
Zusammenfassung
- MIME gab einer Body-Entität eine
Content-IDin der Syntax einer Message-ID, damit andere Teile sie unabhängig von Reihenfolge und externer Adresse referenzieren konnten. multipart/relatedwählte über die Content-ID die Wurzel eines zusammengesetzten Objekts;cid:und die langemid:-Form machten denselben Wert linkfähig.- Die geforderte weltweite Eindeutigkeit war nur eine Erzeugungsregel. Sie schuf weder Inhalts-Hash noch Authentifizierung oder globale Abrufbarkeit; Container und Empfänger behielten die Auswahlmacht.
Eine Adresse führte nach innen
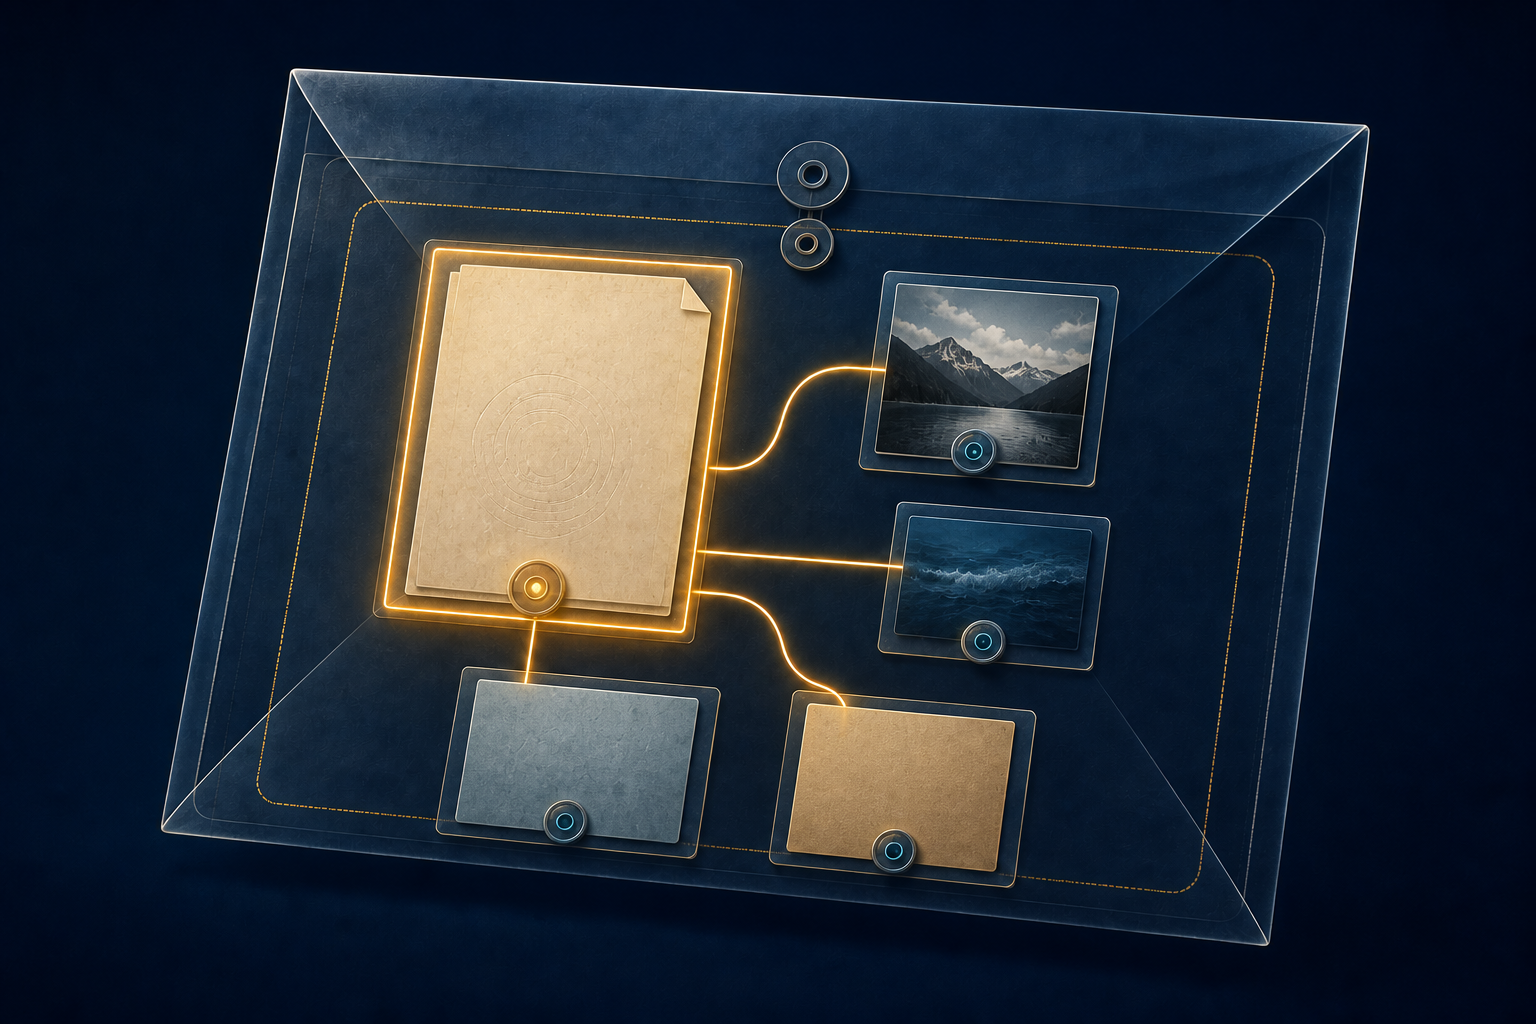
Ein Weblink fordert gewöhnlich zum Verlassen des Dokuments auf: Der Client nimmt eine Adresse und fragt eine andere Ressource ab. In einer zusammengesetzten MIME-Nachricht konnte der Weg vollständig im empfangenen Paket bleiben. Der HTML-Teil nannte ein Bild, das als Schwester oder tiefer verschachtelter Teil bereits vorhanden war.
Eine Positionsnummer oder ein Dateiname hätte diese Aufgabe nicht zuverlässig erfüllt. Gateways durften Teile umordnen, Archive Anhänge herauslösen und rekursive Multipart-Strukturen mehrere zusammengesetzte Objekte enthalten. Eine Referenz musste solche Bewegungen überstehen, ohne einen externen Ort vorzutäuschen.
RFC 1341 führte 1992 MIME als typisierte, rekursive Erweiterung des flachen Internet-Mail-Bodys ein. Zu den optionalen Feldern gehörten Content-ID und Content-Description. Während das zweite eine menschenlesbare Beschreibung liefern konnte, bezeichnete das erste die Entität, auf die sich ein anderer Teil bezog. Content-Type erklärte die dekodierten Bytes, Content-Transfer-Encoding ihre Transportdarstellung und eine Boundary die serielle Trennung. Content-ID beantwortete die Frage nach dem gemeinten Objekt.
Die Neufassung in RFC 2045 präzisierte 1996, dass der Wert die Syntax einer Message-ID verwendet und weltweit eindeutig erzeugt werden soll. Die gemeinsame Grammatik machte aus einem Körperteil keine Nachricht. Message-ID benennt die ganze Nachricht, Content-ID eine MIME-Entität an einer beliebigen Stelle ihres Baums.
Als Anwendung nannte der Standard das Caching. Der Typ message/external-body beschreibt Daten, die über einen externen Zugriffsmechanismus erreicht werden; sein Erzeuger musste eine Content-ID angeben. Ein Cache konnte damit denselben Inhalt hinter mehreren Zugriffsbeschreibungen erkennen. Das Etikett wurde aber nicht aus den Oktetten berechnet. Gleiche Werte waren eine Identitätsbehauptung des Erzeugers, kein kryptografischer Nachweis. Und weltweite Eindeutigkeit bedeutete nicht, dass irgendwo ein globales Verzeichnis oder ein Server für den Abruf existierte.
Die begrenzte Ausnahme für doppelte Werte war entscheidend
Wer Content-ID als Datenbank-Primärschlüssel über serialisierte Knoten versteht, würde jeden doppelten Wert verwerfen. RFC 2046 zeigt mit multipart/alternative, weshalb das zu streng wäre. Dort tragen mehrere Teile dieselbe Information in verschiedenen Formaten; der Empfänger nimmt gewöhnlich die letzte Variante, die er darstellen kann.
Geht bei einer Umwandlung Information verloren, sollen die Darstellungen unterschiedliche Content-IDs erhalten. Mehrere message/external-body-Teile mit alternativen Zugriffen auf identische Daten dürfen dagegen denselben Wert verwenden. Der Cache erkennt ein Objekt, während die Regel des umgebenden Multiparts die Darstellung auswählt.
Content-ID bezeichnete also beabsichtigte Inhaltsidentität im Kontext einer Struktur, nicht zwingend einen einzigen boundary-begrenzten Block. Pauschales Ablehnen zerstört legitime Alternativen. Pauschales Akzeptieren lässt mehrdeutige oder bösartige Nachrichten Referenzen umlenken. Der Elterncontainer gehört deshalb zur Auswertung des Werts.
Ein zusammengesetztes Objekt brauchte eine Wurzel
Eine HTML-Seite mit Bildern ist keine lose Sammlung von Anhängen. Ein Teil organisiert die anderen, und einzeln betrachtet geht ihre Funktion verloren. RFC 2110 standardisierte 1997 eine frühe MHTML-Kapselung für aggregierte Dokumente und verband Content-ID, CID-URLs und Content-Location.
Ein Jahr später definierte RFC 2387 den allgemeineren Container multipart/related. Sein Parameter type kündigt den Medientyp der Wurzel an. Der optionale Parameter start verweist durch eine Content-ID auf den zuerst zu verarbeitenden Teil. Fehlt er, ist der erste Body-Teil die Wurzel.
Damit besaß die Reihenfolge eine Voreinstellung, die eine explizite Kennung überschreiben konnte. Verschob ein Gateway die Wurzel, ohne die start-Beziehung zu erhalten oder anzupassen, veränderte es die Bedeutung trotz vollständiger Bytes. Umgekehrt durfte start nicht beliebig außerhalb des richtigen Related-Objekts suchen. Widersprachen sich der angegebene type und der tatsächliche Content-Type der Wurzel, ließ RFC 2387 das Verhalten des User Agents undefiniert.
Die Related-Semantik konnte auch eine gewöhnliche Darstellungsanweisung für Anhänge überstimmen. Ein Dateiname hilft beim Speichern; ob ein Bild ein eigenständiger Anhang oder ein unentbehrlicher Bestandteil des Dokuments ist, entscheidet die zusammengesetzte Anwendung. Wer nur die Teile extrahiert und ihre Beziehungen verliert, bewahrt Material, aber nicht das vollständige Dokument.
cid: übersetzte einen Header in eine Linksyntax
RFC 2392 gab Message-ID und Content-ID ihre URL-Formen. Eine CID-URL besteht aus cid: und einem URL-kodierten addr-spec. Zum Vergleich mit dem Header entfernt eine Implementierung den Präfix, dekodiert Prozentsequenzen und ergänzt die spitzen Klammern. Der wiederhergestellte Wert lässt sich anschließend direkt mit den Content-ID-Feldern im MIME-Baum abgleichen.
Die URL-Form schrieb kein Transportprotokoll vor. Das Schema beschrieb eine Auflösung über MIME-Header. Viele Nachrichtenspeicher indexierten ganze Nachrichten, aber nicht jeden eingeschlossenen Teil. Daher definierte RFC 2392 die lange Form mid:message-id/content-id und verlangte ihre Unterstützung. Der erste Bezeichner findet die Nachricht, der zweite die Entität darin.
Eine kurze cid:-Referenz bleibt üblicherweise in derselben Nachricht. Ein Speicher kann seine Suche unter Ausnutzung der Eindeutigkeitskonvention erweitern, doch daraus entsteht kein universeller Dienst. Auch die begrenzte Mehrfachverwendung derselben Content-ID innerhalb einer Nachricht blieb möglich; die Regeln der einschließenden Entität bestimmen dann, welcher Teil gemeint ist.
Ein Ort blieb eine andere Art von Aussage
RFC 2557 ersetzte 1999 RFC 2110 und unterschied Content-ID, Content-Location und Message-ID ausdrücklich. Content-Location konnte eine absolute oder relative URI tragen, ohne deren Abrufbarkeit für den Empfänger zu versprechen. Die URI konnte nur in einem geschlossenen Bereich gelten oder für die interne Auflösung eines Pakets sogar fiktiv sein.
Das Feld war deshalb nicht bedeutungslos. Es konnte eine Referenz im Ursprungsdokument mit einem beigepackten Teil verbinden und den konzeptionellen Herkunftsort einer Darstellung nennen. Es war nur keine Quittung über einen erfolgreichen externen Abruf.
RFC 2557 trennte außerdem die URI eines MHTML-Aggregats von der URI seiner Wurzel. Der Abruf des Aggregats liefert ein Paket. Der Abruf der Wurzel kann nur die Seite liefern und weitere Netzabfragen auslösen. Bei verschiedenen Zeitpunkten können beide Wege sogar unterschiedliche Zustände zeigen.
Content-ID war gerade deshalb nützlich, weil es weniger behauptete. Die interne Beziehung konnte stabil bleiben, während Reihenfolge, Ort und Abrufzeit sich änderten. Der Empfänger musste weiterhin den Nachrichtenkontext bestimmen, den Container analysieren, eine zulässige Alternative auswählen, dekodieren, Sicherheitsregeln anwenden und über die Darstellung entscheiden.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten