
Résumé
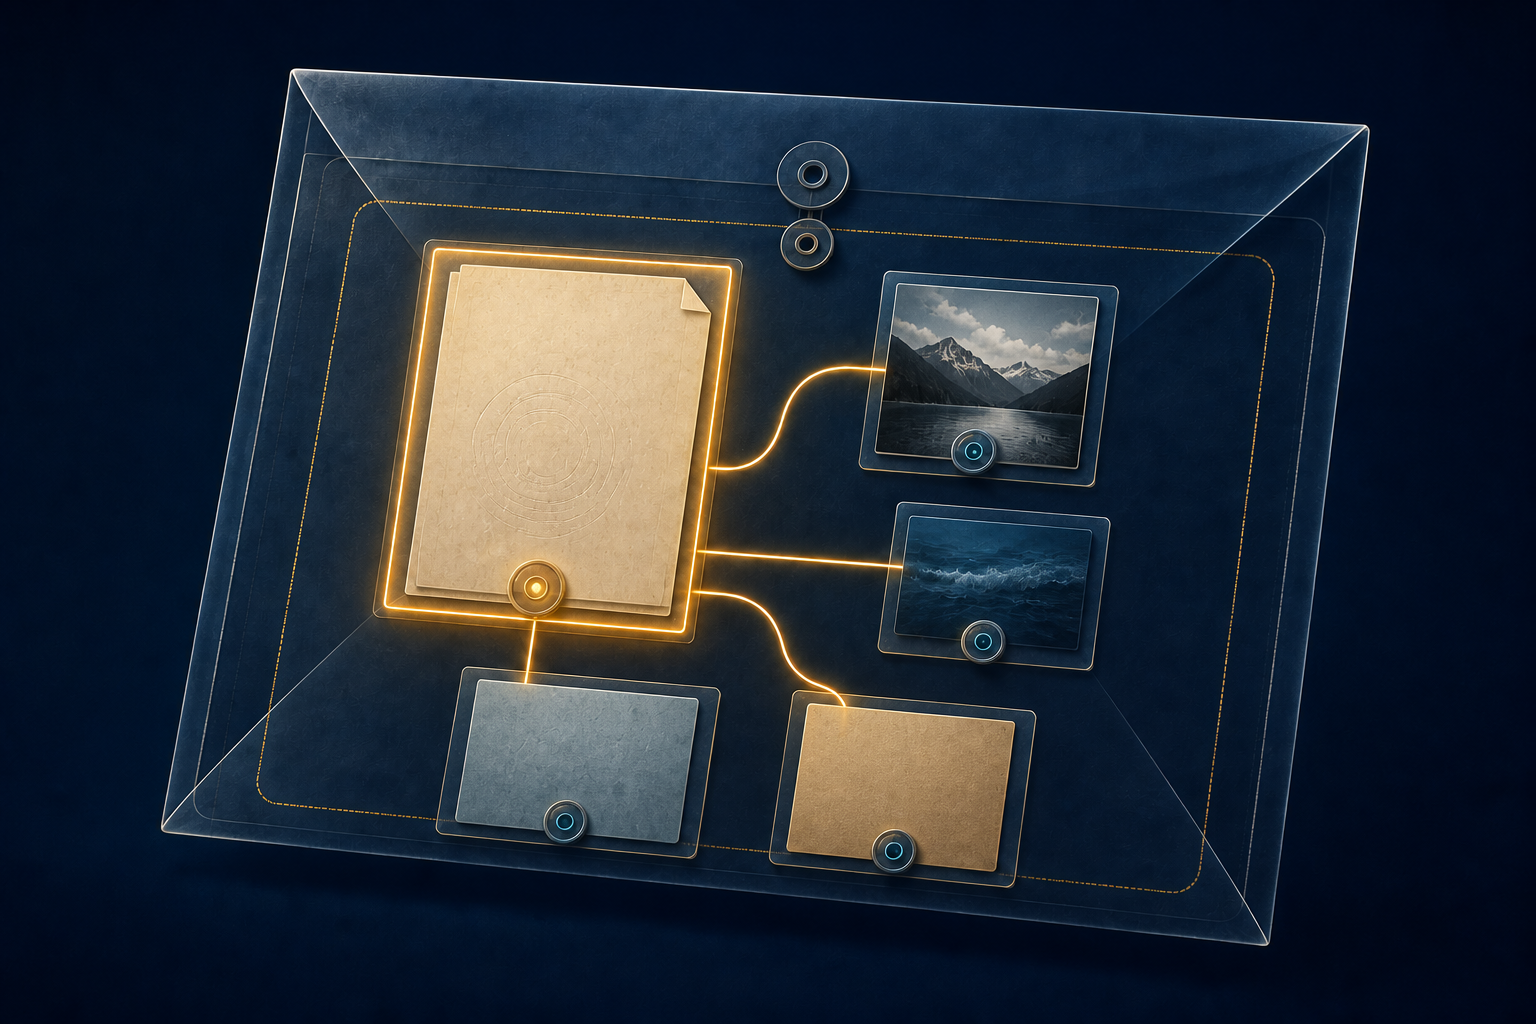
Content-IDdonnait à une entité MIME une étiquette au format Message-ID afin qu'une autre partie puisse la citer sans dépendre de son rang dans le message.multipart/relatedutilisait cette étiquette pour choisir la racine d'un objet composé ;cid:et la forme longue demid:la rendaient utilisable dans un lien.- L'unicité mondiale demandée à la génération n'en faisait ni une empreinte, ni une authentification, ni une ressource récupérable partout. Le conteneur et l'application gardaient le pouvoir de résoudre et d'afficher.
Une adresse tournée vers l'intérieur
Dans un document Web, une balise d'image évoque normalement une sortie : le navigateur suit l'adresse et demande un autre objet. Le courrier MIME a rendu possible le mouvement inverse. Le document et l'image voyageaient ensemble ; le lien ne servait qu'à retrouver une entité dans l'arbre reçu.
Le problème n'était pas seulement de transporter plusieurs fichiers. Une passerelle pouvait réordonner les parties, un stockage pouvait extraire les pièces jointes, et une structure récursive pouvait contenir plusieurs objets composés. Un numéro de position ou un nom de fichier ne constituait pas une référence assez stable.
RFC 1341 a introduit en 1992 Content-ID parmi les champs MIME facultatifs. La grande nouveauté du document était d'étendre le corps ASCII plat vers des entités typées et multipartites. Mais cette petite étiquette ouvrait une couche séparée : Content-Type décrivait l'interprétation des octets décodés, Content-Transfer-Encoding leur représentation durant le transport, la frontière multipart leur découpage, et Content-ID l'entité visée par une référence.
RFC 2045 a précisé le contrat en 1996. La valeur reprend la syntaxe de Message-ID et doit être produite de manière à être unique au monde. La ressemblance ne confond pas les objets. Message-ID nomme un message complet ; Content-ID étiquette une entité MIME, éventuellement profondément imbriquée.
Le texte cite notamment la mise en cache. Une entité message/external-body décrit des données accessibles par un mécanisme extérieur ; tout générateur de ce type devait fournir un Content-ID afin qu'un cache puisse reconnaître l'objet. Cette identité restait déclarative. La valeur n'était pas calculée à partir des octets. Deux valeurs égales ne constituaient donc pas une preuve cryptographique d'égalité, et une valeur correctement formée ne créait pas de service mondial de récupération.
L'exception révélait la vraie portée de l'identifiant
Un analyseur pourrait être tenté d'imposer une contrainte de base de données : une valeur, un seul nœud. RFC 2046 montre pourquoi ce serait trop fort. Dans multipart/alternative, plusieurs parties représentent la même information selon des formats différents ; le destinataire choisit généralement la dernière représentation qu'il sait traiter.
Lorsque la conversion fait perdre de l'information, les variantes devraient porter des Content-ID différents. En revanche, plusieurs parties message/external-body donnant des méthodes d'accès distinctes au même contenu peuvent partager la valeur afin d'alimenter un même cache. Le choix appartient alors aux règles du conteneur. L'identifiant qualifie l'identité attendue du contenu, pas l'unicité physique de chaque bloc sérialisé.
Cette nuance protège deux directions. Refuser tout doublon invalide des alternatives légitimes. Accepter le même identifiant sans examiner le parent permet à un message ambigu de détourner un lien. La preuve exploitable comprend donc la valeur et la place logique où elle apparaît.
Une collection de pièces avait besoin d'une racine
Un document HTML accompagné d'images n'est pas une simple liste de pièces jointes : une partie organise les autres. RFC 2110 a décrit en 1997 le premier cadre MHTML reliant HTML, Content-ID, URL CID et Content-Location.
L'année suivante, RFC 2387 a défini multipart/related pour les objets composés dont les éléments ne se comprennent pas isolément. Le paramètre type annonce le type de la racine. start, s'il existe, pointe par Content-ID vers la partie à traiter d'abord. Sinon, la première partie sérialisée devient la racine.
L'ordre fournit donc une valeur par défaut, mais l'étiquette peut la remplacer. Déplacer la racine sans préserver start change le sens du paquet. À l'inverse, start ne donne pas carte blanche : sa cible doit exister dans le bon objet composé. Si type contredit le Content-Type réel de la racine, le comportement du client reste indéfini.
La relation peut aussi primer sur la présentation ordinaire d'une pièce jointe. Un nom de fichier suggère comment enregistrer une image ; les règles de l'objet composé décident si cette image est un élément indispensable du rendu. Conserver les octets sans la relation ne préserve pas complètement le document.
cid: n'était pas une promesse de réseau
RFC 2392 a donné aux identifiants leurs formes URL. cid: est suivi de l'addr-spec encodée pour une URL. Pour retrouver le champ, le client retire le préfixe, décode les séquences %hh et remet la valeur entre chevrons. La valeur ainsi reconstituée peut alors être comparée directement aux champs Content-ID de l'arbre MIME.
Le format URL n'impose aucun transport. La résolution compare une référence avec les en-têtes d'une structure MIME. De nombreux stockages indexent les messages mais pas chaque partie ; la forme longue mid:message-id/content-id fournit alors le contexte. La spécification impose sa prise en charge, tandis que l'extension d'un cid: court à tout le magasin reste un choix d'implémentation.
RFC 2392 conserve également l'exception des représentations multiples. Dans des cas limités, plusieurs parties d'un message peuvent partager un Content-ID ; les règles du parent sélectionnent celle que désigne le lien. Même une valeur destinée à être unique mondialement a besoin de son arbre local pour produire un résultat déterminé.
Le lieu était une autre affirmation
Le travail MHTML a été repris par RFC 2557, qui a remplacé RFC 2110 en 1999. Content-ID, Content-Location et Message-ID y restent des étiquettes différentes. Content-Location peut être absolu ou relatif, désigner un espace interne, voire ne pas être récupérable par le destinataire. Il aide à faire correspondre des liens au contenu emballé ; il ne prouve pas une disponibilité externe.
Le document distingue aussi l'URI de l'agrégat, celle de sa racine et celles de ses composants. Récupérer le paquet MHTML peut rendre un instantané ancien. Charger séparément la page racine et ses dépendances peut produire un état plus récent. Identité interne, provenance de localisation et résultat de récupération ne sont donc pas interchangeables.
La force de Content-ID venait de cette retenue. Il pouvait maintenir une relation pendant que l'ordre, le lieu et le mode d'accès changeaient. Ensuite seulement, le client devait choisir une variante, décoder les octets, appliquer les contrôles de sécurité et décider d'afficher.
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance