
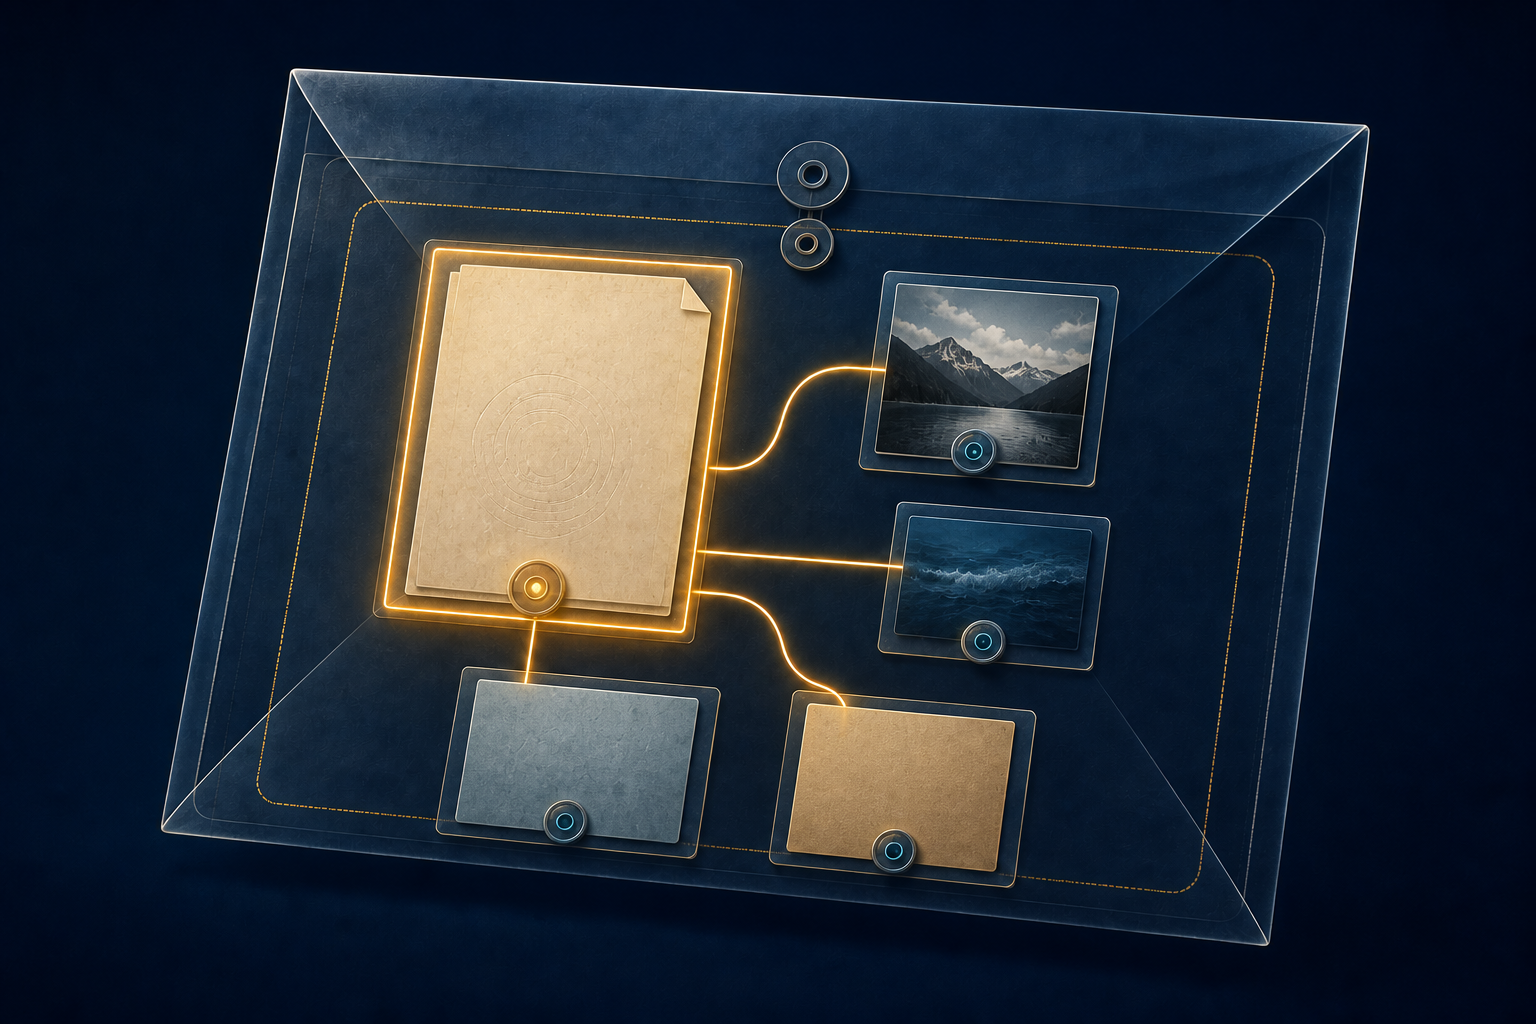
الخلاصة
- منحت MIME كياناً في جسم الرسالة
Content-IDبصيغة تشبه Message-ID، فأمكن لجزء آخر الإشارة إليه من دون الاعتماد على ترتيبه أو على عنوان خارجي. - استخدم
multipart/relatedالمعرّف لتعيين جذر الكائن المركّب، بينما حوّلcid:والصيغة الطويلة منmid:القيمة نفسها إلى مرجع داخل رابط. - اشتراط توليد قيمة فريدة عالمياً لا يجعلها بصمة للمحتوى ولا إثباتاً للهوية ولا مورداً متاحاً في كل مكان؛ فالحاوية والتطبيق المستقبل يظلان صاحبي قرار الاختيار.
عنوان يتجه إلى داخل الرسالة
يوحي الرابط في الويب عادة بحركة إلى الخارج: يقرأ العميل عنواناً ثم يطلب مورداً من مكان آخر. أما رسالة MIME المركّبة فأتاحت مساراً مختلفاً. كان مستند HTML والصورة يسافران معاً، ولم يكن حل المرجع سوى بحث في شجرة الأجزاء التي وصلت بالفعل.
لم يكن رقم الجزء أو اسم الملف كافياً. فقد تعيد بوابة البريد ترتيب الأجزاء، وقد يستخرج مخزن الرسائل المرفقات، كما يمكن لبنية multipart متداخلة أن تضم أكثر من كائن مركّب. وكان المطلوب اسماً يبقى مفهوماً بعد النقل وإعادة الترتيب من دون أن يدّعي أنه عنوان على الشبكة.
قدمت RFC 1341 عام 1992 رسائل MIME ذات الكيانات المعرّفة بالنوع والقابلة للتداخل، وأدخلت الحقلين الاختياريين Content-ID وContent-Description. كان الثاني صالحاً لوصف المحتوى بلغة بشرية، أما الأول فيحدد الكيان المقصود بمرجع آخر. وهكذا عمل كل حقل في طبقة مستقلة: يشرح Content-Type معنى البايتات بعد فك الترميز، ويشرح Content-Transfer-Encoding تمثيلها أثناء النقل، ويقسم boundary التسلسل إلى أجزاء، بينما يجيب Content-ID عن سؤال «أي كيان نعني؟».
حددت RFC 2045 عام 1996 العقد بدقة أكبر. تستعمل القيمة صيغة Message-ID ويجب توليدها بحيث تكون فريدة عالمياً. لكن تشابه الصيغة لا يوحّد الشيئين: يعرّف Message-ID الرسالة كلها، أما Content-ID فيسم كيان MIME واحداً، سواء كان الجسم الأعلى أو جزءاً عميقاً في شجرة متداخلة.
ذكرت الوثيقة التخزين المؤقت ضمن الاستخدامات. يصف النوع message/external-body بيانات يمكن بلوغها بآلية خارج الجسم المباشر، ولذلك كان على مولّد هذا النوع أن يضع Content-ID. يستطيع المخزن المؤقت عندئذ أن يتعرف إلى المحتوى نفسه خلف تعليمات وصول متعددة. ومع ذلك، لا تُشتق القيمة من البايتات. تساويها ادعاء من المنشئ عن وحدة المحتوى وليس برهاناً تشفيرياً، وفرديتها لا تنشئ فهرساً عالمياً أو سجلاً في DNS أو خادماً ملزماً بإعادة الكائن.
الاستثناء المحدود للتكرار كشف معنى المعرّف
قد يعامل المصمم Content-ID كمفتاح أساسي لا يقبل التكرار بين العقد المتسلسلة. لكن RFC 2046 تبين سبب خطأ ذلك في multipart/alternative. تضم هذه الحاوية تمثيلات مختلفة للمعلومة نفسها، ويختار المستقبل عادة آخر تمثيل يستطيع عرضه.
إذا أفقد التحويل بعض المعلومات، ينبغي أن تحصل البدائل على Content-ID مختلفة. أما عدة أجزاء من message/external-body تعرض طرقاً مختلفة للوصول إلى بيانات متطابقة فيمكن أن تشترك في القيمة. يرى المخزن المؤقت كائناً واحداً، ثم تختار قواعد الحاوية التمثيل الملائم.
إذن لم يكن Content-ID رقماً فريداً لكل كتلة يفصلها boundary، بل دليلاً على هوية المحتوى المقصودة كما تُفهم داخل بنية. رفض كل تكرار يفسد بدائل مشروعة، وقبول التكرار في كل موضع يفتح باب الغموض أو تحويل المرجع. لا تكتمل دلالة القيمة من دون نوع الكيان الأب.
الكائن المركّب احتاج إلى جذر
صفحة HTML مع صورها ليست كيساً من المرفقات المنفصلة. فالصفحة تنظم المكونات، وعرض كل جزء منفرداً يفقد العلاقة التي صممها المرسل. وضعت RFC 2110 عام 1997 إطاراً مبكراً لتغليف مستندات HTML المجمعة في MIME، وربطت Content-ID بعناوين CID وبالحقل Content-Location.
ثم عرّفت RFC 2387 عام 1998 الحاوية العامة multipart/related. يعلن المعامل type نوع الوسائط للجزء الجذر. ويشير المعامل الاختياري start، بواسطة Content-ID، إلى الجزء الذي يجب أن يبدأ التطبيق بمعالجته. إذا غاب start أصبح الجزء الأول هو الجذر.
كان للترتيب إذاً سلطان افتراضي يستطيع المعرّف الصريح تجاوزه. إذا نقلت بوابة الجذر من موضعه ولم تحفظ علاقة start أو تعدلها، تغير معنى الحزمة حتى لو بقيت البايتات كلها. وفي المقابل، لا يمنح start حق البحث في أي مكان؛ يجب أن يصل إلى جزء داخل الكائن المرتبط الصحيح. وإذا خالف type نوع Content-Type الفعلي للجذر، تركت RFC 2387 سلوك وكيل المستخدم غير محدد.
وقد تتقدم قواعد العلاقة على اقتراح العرض العادي للمرفق. يساعد اسم الملف في الحفظ، لكنه لا يقرر إن كانت الصورة مرفقاً مستقلاً أو مكوّناً لا يستغني عنه المستند. الاحتفاظ بالأجزاء مع إسقاط علاقاتها يعني حفظ المواد لا حفظ الكائن المركّب كاملاً.
حوّل cid: قيمة الترويسة إلى صيغة رابط
عرّفت RFC 2392 صيغ URL لكل من Message-ID وContent-ID. يتكون عنوان CID من cid: ثم addr-spec مرمّز وفق قواعد URL. تزيل البرمجية البادئة، وتفك ترميز النسب المئوية، وتعيد القوسين الزاويين، ثم تقارن القيمة المستعادة مباشرة بحقول Content-ID في شجرة MIME.
لم تحوّل صيغة URL المرجع إلى بروتوكول نقل. فهي تصف طريقة حل داخل بنية MIME لا أمراً بفتح اتصال. تفهرس مخازن كثيرة الرسائل ولا تفهرس كل جزء فيها، ولهذا عرّفت RFC 2392 الصيغة الطويلة mid:message-id/content-id وأوجبت دعمها: يحدد القسم الأول الرسالة، ويحدد الثاني الكيان داخلها.
يظل cid: القصير في العادة محصوراً في أجزاء الرسالة نفسها. يمكن للمخزن توسيع البحث مستفيداً من اتفاق الفردية، لكن ذلك قرار تنفيذي وليس خدمة عامة على الإنترنت. كما أبقت الوثيقة الحالات المحدودة التي تحتوي فيها رسالة واحدة على أكثر من جزء يحمل Content-ID نفسه؛ عندئذ تقرر قواعد الكيان الحاوي أي مرشح يعنيه الرابط.
الموقع ادعاء من نوع آخر
حلت RFC 2557 محل RFC 2110 عام 1999، وميزت بين Content-ID وContent-Location وMessage-ID. قد يحمل Content-Location عنوان URI مطلقاً أو نسبياً من دون أن يكون قابلاً للاسترجاع لدى كل مستلم. ربما يعمل داخل نطاق مقيد فقط، بل يمكن أن يكون افتراضياً لخدمة حل المراجع داخل الحزمة.
لا يفقد الحقل قيمته بذلك. فهو يساعد على مطابقة عنوان ورد في المستند مع جزء مرفق، ويمكن أن يسجل الموقع التصوري الذي جاء منه التمثيل. لكنه لا يثبت نجاح استرجاع خارجي.
وفصلت RFC 2557 أيضاً URI الخاص بحزمة MHTML عن URI الخاص بجذرها. قد يعيد طلب الحزمة مجموعة مكتملة، بينما يعيد طلب الجذر الصفحة وحدها ثم يجلب العميل الاعتمادات كلّاً على حدة. وإذا حدث الطلبان في وقتين مختلفين فقد يعرضان لقطتين مختلفتين.
كانت قوة Content-ID في أنه ادعى أقل من غيره. حافظ على علاقة داخلية بينما تغير الترتيب والموقع وزمن الاسترجاع. وبعد العثور على الجزء، بقي على المستقبل أن يثبت سياق الرسالة، ويحلل الحاوية، ويختار البديل المدعوم، ويفك الترميز، ويطبق سياسة الأمان، ثم يقرر ما سيعرضه.
إحاطة الأعضاء
سياق أعمق للملف الشخصي
سجّل الدخول بمستوى العضوية المناسب لفتح الإحاطة الكاملة وملاحظات المصادر.
للدائرة الاستراتيجية فقط
الدائرة الاستراتيجية
مفتوح لجميع القراء. افتح إحاطات الملف الشخصي بعد الانضمام وتسجيل الدخول.
انضم إلى الدائرة الاستراتيجيةلأعضاء تحالف القيادات فقط
تحالف القيادات
لأصحاب الأصول الفكرية المؤهلين وللإدارة؛ سجّل الدخول للوصول إلى إحاطات التحالف.
انضم إلى تحالف القيادات