
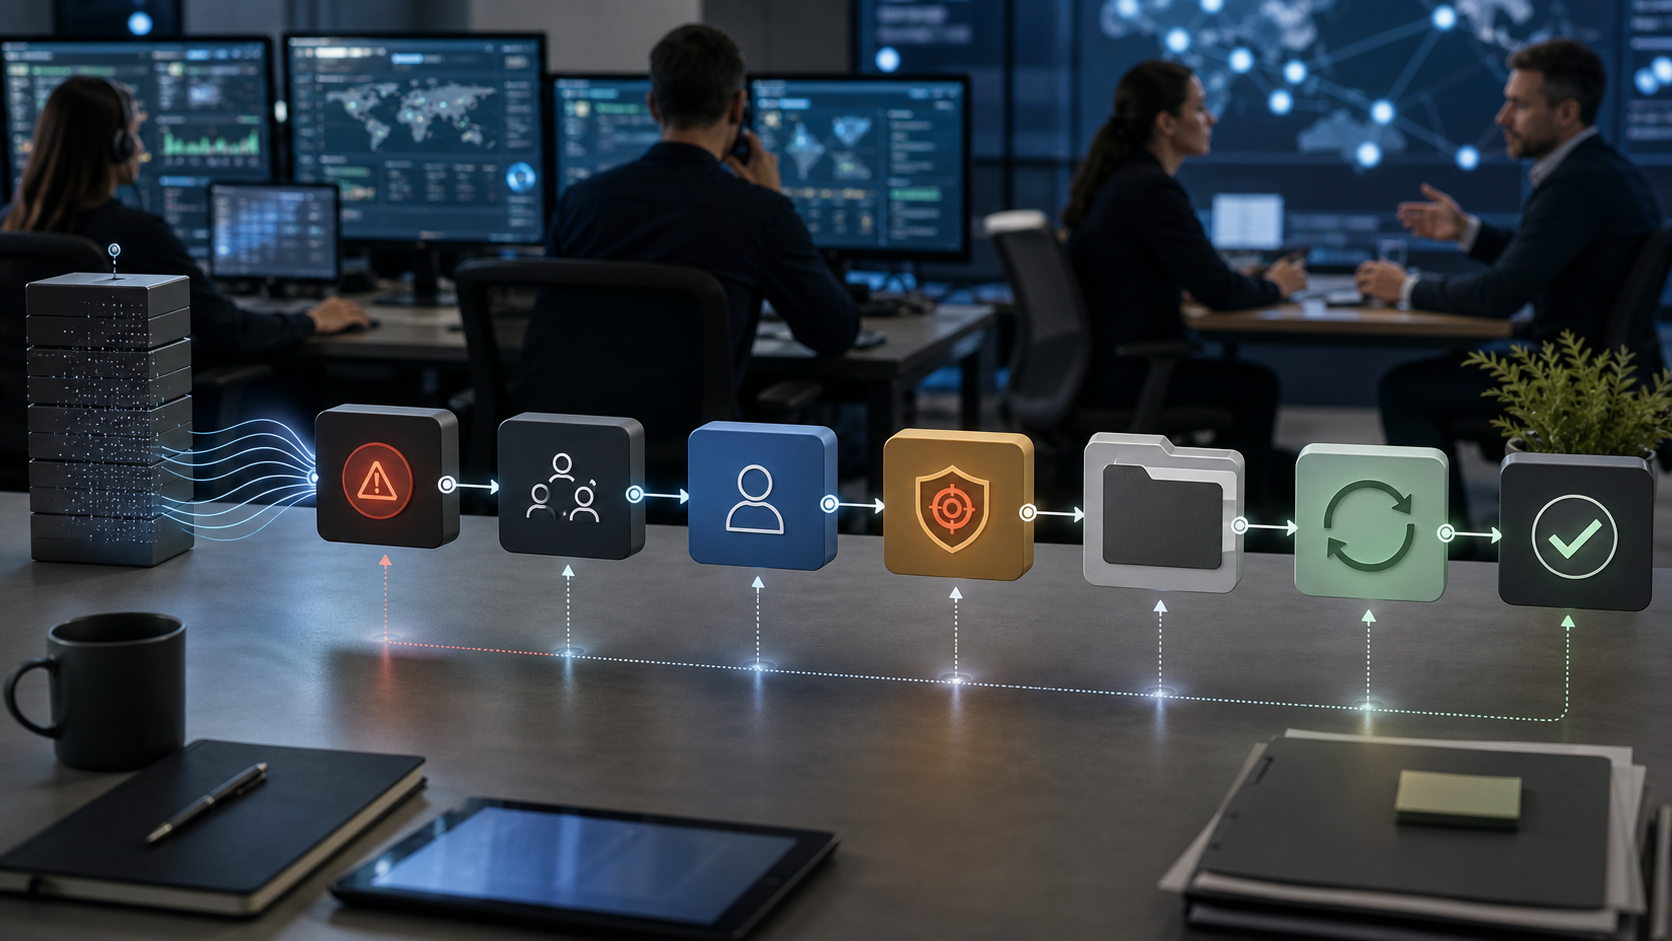
Zusammenfassung
- Arctic Wolf ist am stärksten, wenn seine gemanagten Betriebsabläufe Telemetrie, Analysten-Triage, Expositionskontext und kundenspezifisches Wissen in Sicherheitsmaßnahmen umwandeln, die das IT- oder Sicherheitsteam eines Kunden tatsächlich akzeptieren, zuweisen, ausführen und später verteidigen kann.
- Die öffentlichen Belege stützen ein breites Modell gemanagter Sicherheitsoperationen über MDR, Expositionsmanagement, Cloud-Erkennung, Incident Response, Endpunkt- und Sensibilisierungsdienste, aber sie belegen nicht unabhängig universelle Reaktionszeiten, Erkennungsgenauigkeit, Behebungsabschluss oder Kundeneinsparungen.
Die nützliche Einheit ist nicht der Alarm, sondern die akzeptierte Maßnahme
Der sinnvollste Weg, Arctic Wolf zu bewerten, ist nicht zu fragen, ob es einen gemanagten Erkennungs- und Reaktionsalarm erzeugen kann. Viele Sicherheitsanbieter können das. Die schwierigere Frage ist, ob Arctic Wolf einen Kunden von einem Signal zu einer akzeptierten Maßnahme führen kann: diesen Host isolieren, dieses Konto zurücksetzen, dieses System patchen, diese Identität deaktivieren, diese Route blockieren, diesen Eigentümer anrufen, diese Beweise sichern, dieses Ticket wiedereröffnen, überprüfen, ob die Exposition geschlossen ist, oder den Vorfall eskalieren, weil der Kunde nicht schnell genug gehandelt hat.
Diese Unterscheidung ist wichtig, weil gemanagte Sicherheit oft gekauft wird, um eine betriebliche Lücke zu schließen, nicht nur eine technologische Lücke. Ein Unternehmen kann bereits über Endpunkt-Tools, Cloud-Protokolle, Identitätsalarme, Schwachstellenscanner und E-Mail-Verteidigungen verfügen und dennoch in dem Moment scheitern, in dem jemand entscheiden muss, was zu tun ist. Der Alarm kann mehrdeutig sein. Der Asset-Eigentümer kann unklar sein. Das Sicherheitsteam hat möglicherweise keine Berechtigung, Produktionssysteme zu ändern. Der Helpdesk sieht das Ticket, versteht aber nicht das Risiko.
Der Anbieter eskaliert, aber der Kunde behandelt die Eskalation wie einen weiteren Hinweis. Eine Seite voller Erkennungen reduziert das Risiko nicht, wenn niemand den nächsten Schritt akzeptiert.
Arctic Wolfs aktuelle öffentliche Geschichte ist um diese Betriebslücke herum aufgebaut. Es beschreibt ein gemanagtes Modell, bei dem Sicherheitstelemetrie aus internen Netzwerken, externen Netzwerken, Endpunkten und Cloud-Umgebungen gesammelt; mit Bedrohungsinformationen, Open-Source-Informationen, Schwachstellendaten und Kontoübernahmekontext angereichert; dann von einem benannten Concierge-Sicherheitsteam und einer breiteren Sicherheitsoperationsorganisation untersucht wird. Die Produktseiten stellen den Dienst auch eher als Partnermodell dar, nicht nur als Tool-Bereitstellung. Das ist der richtige Rahmen für das Segment.
Kunden, die gemanagte Erkennung kaufen, bitten den Anbieter normalerweise nicht, ein weiteres Dashboard hinzuzufügen. Sie bitten um Hilfe, um verstreute Signale in wiederholbare Arbeit umzuwandeln.
Die Schwierigkeit besteht darin, dass „wiederholbare Arbeit“ der Punkt ist, an dem gemanagte Sicherheit enttäuschend werden kann. Wenn Arctic Wolf Sichtbarkeit, aber nicht genügend Kontext hat, kann es laute oder generische Tickets senden. Wenn es Kontext, aber keine Autorität hat, kann es die richtige Maßnahme kennen, aber immer noch auf den Kunden warten. Wenn es Autorität, aber schwache Rollback- oder Genehmigungskontrollen hat, kann es Betriebsrisiken schaffen. Wenn es Tickets schließt, ohne nachzuweisen, dass die Exposition behoben wurde, kann der Kunde das Gefühl von Aktivität ohne Risikominderung bekommen.
Die akzeptierte Maßnahme ist daher ein strengerer Test als die Erkennung.
Eine akzeptierte Maßnahme hat mehrere Eigenschaften. Sie benennt das betroffene Asset, Konto, den Benutzer, die Schwachstelle oder den Geschäftsprozess. Sie erklärt, warum die Maßnahme jetzt und nicht später erforderlich ist. Sie trennt bestätigte Fakten von Vertrauensurteilen. Sie sagt, wer den nächsten Schritt verantwortet. Sie hält fest, ob Arctic Wolf die Maßnahme durchführen, empfehlen, koordinieren oder nur beobachten kann. Sie erfasst die Bestätigung des Kunden. Sie hinterlässt Beweise, die ein späterer Prüfer einsehen kann. Sie hat einen Weg für Ausnahmen, Rollbacks oder Eskalationen, wenn die Maßnahme bestritten wird.
Dies ist die Linse, durch die Arctic Wolf beurteilt werden sollte. Das Unternehmen hat ein breites öffentliches Portfolio aufgebaut, das Alarm-Triage, Expositionspriorisierung, Cloud-Überwachung, Ticket-Synchronisation, Incident Response, Sensibilisierungsschulungen und Endpunktschutz abdeckt. Die Frage ist nicht, ob diese Bezeichnungen existieren. Die Frage ist, ob der tägliche Betrieb des Kunden sie als einen kohärenten Maßnahmen-Workflow erlebt.
Ein gemanagtes SOC versagt, wenn die Verantwortung zwischen Erkennung und Behebung verschwindet
Managed Detection and Response hat ein in die Kategorie eingebautes Eigentumsproblem. Der Anbieter kann überwachen und untersuchen, aber der Kunde besitzt normalerweise die Umgebung, das Geschäftsrisiko, die Anmeldeinformationen, die Entscheidungen über Ausfallzeiten und die endgültige Behebung. Diese Grenze ist unvermeidlich. Sie ist auch der Ort, an dem viele MDR-Programme an Wert verlieren.
Betrachten Sie ein Signal für einen Diebstahl von Anmeldeinformationen. Arctic Wolf kann eine anomale Authentifizierung, Cloud-Aktivität, Endpunktverhalten, verdächtige E-Mails oder ein damit verbundenes Bedrohungsinformationsmuster sehen. Die Plattform und die Analysten können das Signal anreichern, Dringlichkeit zuweisen und einen Fall eröffnen. Aber die Maßnahme kann erfordern, dass der Kunde Passwörter zurücksetzt, Konten deaktiviert, Sitzungen widerruft, Postfachregeln überprüft, Cloud-Aktivitäten inspiziert, einen Geschäftsinhaber benachrichtigt oder sich mit Rechts- und Kommunikationsabteilungen abstimmt.
Wenn der Kunde nicht im Voraus vereinbart hat, wer welche Maßnahmen autorisieren kann, kann die Erkennung korrekt sein und dennoch zu spät kommen, um eine Rolle zu spielen.
Das gleiche Problem tritt bei Schwachstellen- und Expositionsarbeit auf. Arctic Wolfs Materialien zum Expositionsmanagement betonen Asset-Sichtbarkeit, Schwachstellenmanagement, Angriffsflächenmanagement, Priorisierung, Behebungsanleitungen, ITSM-Integration, anpassbare Behebungs-Service-Level-Ziele und Validierung. Das ist genau der Punkt, an den das Expositionsmanagement gehen muss. Eine Schwachstellenliste allein ist keine Sicherheitsmaßnahme. Die akzeptierte Maßnahme ist die Kombination aus Priorität, Eigentümer, Frist, Patch- oder Minderungspfad, Ausnahmebehandlung und Nachweis, dass sich die Exposition tatsächlich geändert hat.
Dies macht die Bereitschaft auf Kundenseite zum Nenner des Produkts. Ein Kunde mit ausgereifter Asset-Verwaltung, Endpunktkontrolle, Identity Governance, Patch-Disziplin und klaren Eskalationsregeln kann mehr Wert aus Arctic Wolf ziehen als ein Kunde mit unvollständigem Inventar und IT-Gruppen, die jedes dringende Ticket anfechten. Arctic Wolf kann die Koordinationslast reduzieren, aber es kann nicht bewirken, dass eine Organisation Maßnahmen akzeptiert, die sie strukturell nicht ausführen kann.
Das Concierge-Modell des Unternehmens soll dies adressieren, indem es benannte Sicherheitsberater zuweist, die die Umgebung des Kunden verstehen und Strategie, Lageberichte, Berichterstattung, Compliance-Unterstützung und Behebungsunterstützung bieten. Öffentliches FAQ-Material besagt, dass das Concierge-Sicherheitsteam Alarm-Triage, Risiko- und Patch-Priorisierung, Behebungsunterstützung, Berichterstattung, Compliance-Aktivitäten, Empfehlungen und strategische Beratung übernimmt. Das ist bedeutsam, weil die akzeptierte Maßnahme oft keine einmalige Analystenentscheidung ist.
Sie hängt von angesammeltem Wissen über die Systeme des Kunden, die Toleranz gegenüber Störungen, den Geschäftskalender und frühere Ausnahmen ab.
Aber benannte Berater sind nur wertvoll, wenn sie genutzt werden, um Maßnahmen schärfer zu machen. Der Käufer sollte fragen, wie Arctic Wolf kundenspezifischen Kontext aufzeichnet, wie dieser Kontext zur Triage gelangt, wie oft Playbooks überprüft werden und wie veraltete Annahmen entfernt werden. Ein benanntes Team kann zu einer Stärke werden, wenn es weiß, dass ein bestimmter Server geschäftskritisch ist, dass eine bestimmte Lieferantendomäne legitim ist, dass eine Fabrik während eines Produktionsfensters nicht neu gestartet werden kann oder dass ein bestimmtes Identitätssystem einen bekannten Migrationspfad hat.
Es wird zur Show, wenn das Ticket immer noch wie eine allgemeine Empfehlung aussieht.
Die Verantwortung sollte auch in der Berichterstattung sichtbar sein. Ein nützlicher gemanagter SOC-Bericht sollte nicht nur Alarme oder Vorfälle zählen. Er sollte zeigen, welche Maßnahmen empfohlen, welche akzeptiert, welche ausgeführt, welche Fristen versäumt, welche vom Unternehmen risikoakzeptiert und welche wiederholt wurden, weil die Grundursache nicht beseitigt wurde. Ohne diese Maßnahmenbuchhaltung können sowohl der Anbieter als auch der Kunde beschäftigt erscheinen, während dieselben Risiken durch die Warteschleife laufen.
Telemetriequalität ist die erste Einschränkung für jede nachgelagerte Entscheidung
Arctic Wolfs MDR-Dokumentation beschreibt Sicherheitstelemetrie aus Netzwerken, Endpunkten und Cloud-Umgebungen, angereichert mit Bedrohungsfeeds, OSINT, CVE-Informationen, Kontoübernahmedaten und anderem Kontext. Die Cloud-Erkennungsdokumentation listet eine breite Palette unterstützter SaaS-, Identitäts-, Infrastruktur-, E-Mail-, Netzwerk- und Sicherheitstool-Integrationen auf, darunter Cloud-Plattformen, Identitätsanbieter, SASE-Tools und E-Mail-Sicherheitsquellen. Die öffentlichen Materialien betonen auch eine offene XDR-Haltung, aktuelle Integrationen und die Verarbeitung großer Ereignismengen.
Diese Breite ist wichtig, aber Telemetriebreite ist nicht gleich Telemetriequalität. In gemanagten Operationen ist die erste Fehlerquelle oft eine unvollständige oder schlecht normalisierte Sichtbarkeit. Wenn die Endpunktabdeckung teilweise ist, Identitätsprotokolle verzögert sind, Cloud-Sensoren falsch konfiguriert sind, Netzwerksensoren wichtige Pfade verpassen oder Ticketdaten nicht die richtigen Felder bewahren, sieht der Analyst ein verzerrtes Bild. Ein schwaches Signal kann als niedrige Priorität eingestuft werden, weil das fehlende Stück nie gesammelt wurde.
Ein Ticket mit hohem Schweregrad kann übermäßig eskaliert werden, weil dem System der Geschäftskontext fehlt. Eine Exposition kann als geschlossen aussehen, weil der Scanner sie nicht mehr sieht, obwohl sich das Asset bewegt hat oder die Kontrolle gebrochen ist.
Deshalb sind Onboarding und technische Bereitschaft wichtiger, als das Marketing normalerweise zugibt. Arctic Wolfs Produktseiten verweisen auf Service-Einrichtung, technische Bereitschaft und essentielle Protokollkonfiguration als Teil der MDR-Bereitstellung. Das sind keine administrativen Vorarbeiten; sie sind Teil der Steuerung. Die anfängliche Entscheidung darüber, welche Protokolle gesammelt werden, wie Identitäten zugeordnet werden, wie Assets benannt werden, wie Endpunkte gruppiert werden, wie Cloud-Konten abgegrenzt werden und wie Alarme geroutet werden, bestimmt die Qualität jeder späteren Maßnahme.
Der Käufer sollte die Telemetrie-Einrichtung als gemeinsames Sicherheitsdesign behandeln, nicht als Beschaffungs-Checkliste. Welche Signale sind obligatorisch? Welche sind optional? Welche Integrationen bieten einen Echtzeit-Ereignisfluss und welche liefern verzögerte Batch-Daten? Welche Quellen können Containment oder Identitätsreaktion auslösen, und welche liefern nur Kontext? Wie werden ausgefallene Kollektoren erkannt? Wer ist für die Behebung einer unterbrochenen Erfassung verantwortlich? Sind Protokollquellenlücken in monatlichen Überprüfungen sichtbar?
Wie weiß Arctic Wolfs Team, wann ein Sensor ausgefallen ist, ein API-Zertifikat abläuft oder ein Kunde einen neuen Cloud-Mandanten außerhalb des überwachten Bereichs hinzugefügt hat?
Öffentliche Produktaktualisierungen zeigen, dass Arctic Wolf weiterhin Daten- und Aktionsflächen hinzufügt, darunter Unterstützung für zusätzliche Cloud- und Identitätsüberwachungsquellen, Benachrichtigungsdienste für Anmeldeinformationen, Blocklisten- und Berichts-APIs sowie Data Explorer-Funktionen. Diese Aktualisierungen sind gute Zeichen für eine aktiv gewartete Plattform, aber sie zeigen auch, warum die Integrationswartung eine dauerhafte Aufgabe ist. Jede neue Quelle, API, Berechtigung oder Berichtsfunktion fügt nur dann potenziellen Wert hinzu, wenn die Umgebung des Kunden aktuell gehalten wird.
Telemetrie ist auch mit der Beweisqualität verbunden. Wenn ein Analyst eine Eindämmung oder Schwachstellenbehebung empfiehlt, muss der Kunde die Grundlage für diese Maßnahme sehen. Ein vages „verdächtiges Verhalten beobachtet“ ist weniger nützlich als ein Fall, der zeigt, welches Konto geändert wurde, welcher Host kommuniziert hat, welcher Cloud-Dienst die Aktion protokolliert hat, welche Schwachstelle im Ausland ausgenutzt wird, welches Asset exponiert ist und welcher Geschäftsdienst betroffen sein könnte. Je konkreter die Beweise, desto einfacher ist es für den Kunden, die Empfehlung zu akzeptieren und schnell auszuführen.
Die zentrale Frage des Artikels beginnt daher vor dem Alarm. Arctic Wolf kann ein Signal nur dann in eine akzeptierte Maßnahme umwandeln, wenn das Signal mit ausreichender Abdeckung, Aktualität, Identitätszuordnung und Asset-Kontext eintrifft, um die Maßnahme vertretbar zu machen.
Triage muss Rauschen reduzieren, ohne Unsicherheit zu verbergen
Auf Arctic Wolfs MDR-Seite heißt es, der Dienst solle Ergebnisse liefern, nicht mehr Alarme. Die öffentlichen Materialien beschreiben Triage, Untersuchungen, Reaktionsmaßnahmen, proaktive Lagebeurteilungen, kundenspezifischen Kontext und ein Modell, in dem automatisierte Analyse mit menschlicher Validierung gepaart wird. Das ist der richtige Anspruch, denn die Weiterleitung von Alarmen ist eine der am wenigsten wertvollen Formen gemanagter Sicherheit. Wenn ein Anbieter einfach alles an den Kunden sendet, hat er Rauschen ausgelagert, anstatt Risiken zu reduzieren.
Triage schafft Wert, wenn sie rohe Ereignisse in eine kleinere Anzahl erklärbarer Fälle umwandelt. Sie sollte verwandte Signale verknüpfen, bekanntes gutartiges Verhalten unterdrücken, den plausibelsten Angriffspfad identifizieren, alternative Erklärungen bewahren und Dringlichkeit zuweisen. Sie sollte auch Unsicherheit explizit machen. Ein Fall ist selten entweder perfekt bestätigt oder bedeutungslos. Eine gute Triage-Notiz sagt, was bekannt ist, was vermutet wird, was fehlt, welche Maßnahme empfohlen wird und was die Empfehlung ändern würde.
Arctic Wolfs öffentliche Beispiele sind hier nützlich, insbesondere seine Incident-Response-Zeitlinien. Sie zeigen die Form eines Workflows, bei dem ein Signal erkannt, mit anderen Aktivitäten korreliert, an die Triage eskaliert, eingedämmt oder behoben und anschließend zusätzliche Sicherheitsreise-Arbeit durchgeführt wird. Diese Zeitlinien sollten nicht als universelles Versprechen der Reaktionszeit gelesen werden. Es sind kuratierte Beispiele. Ihre wichtigere Lektion ist prozedural: Die Maßnahme wird glaubwürdig, wenn der Fall Quelle, Beweise, Eskalation, Behebung und spätere Härtung verbindet.
Das Risiko besteht darin, dass KI- und Automatisierungssprache die Triage sicherer erscheinen lassen kann, als sie ist. Arctic Wolf beschreibt eine Aurora-Plattform mit spezialisierter Automatisierung, kundenspezifischem Kontext, einem Security Operations Graph, Schutzmaßnahmen, Protokollierung, Rollback und menschlicher Genehmigung für Maßnahmen mit hohen Auswirkungen. Es heißt auch, dass Menschen für Beurteilung, Aufsicht und kritische Entscheidungen im Kreislauf bleiben. Dieser Vorbehalt ist keine Schwäche; er ist zentral für das Vertrauen. In Sicherheitsoperationen kann Geschwindigkeit ohne Urteilsvermögen teure Fehler verursachen.
Eine falsche Eindämmung, eine fälschliche Kontodeaktivierung oder ein schlecht getimter Patch können den Betrieb stören.
Der Test der akzeptierten Maßnahme fragt, ob die Automatisierung die Fähigkeit des Analysten zum Handeln verbessert, nicht ob sie die Verantwortung ersetzt. Sammelt die Automatisierung Beweise schneller? Reduziert sie Doppelarbeit? Identifiziert sie ähnliche Fälle? Bereitet sie ein Ticket vor, das ein Mensch validieren kann? Schlägt sie eine Behebung mit Konfidenz und Einschränkungen vor? Hält sie fest, warum eine Maßnahme ergriffen oder verschoben wurde? Verhindert sie, dass Maßnahmen mit geringer Konfidenz oder irreversiblen Auswirkungen ohne Überprüfung ausgeführt werden?
Kunden sollten nach Triage-Qualität in täglichen Artefakten suchen, nicht nur in Plattformbeschreibungen. Ein qualitativ hochwertiger Arctic-Wolf-Fall sollte für den Sicherheitsverantwortlichen des Kunden, einen IT-Eigentümer und einen Prüfer lesbar sein. Er sollte eine kohärente Geschichte erzählen. Er sollte die betroffenen Systeme nennen. Er sollte zeigen, warum die empfohlene Maßnahme angemessen ist. Er sollte bestätigte Kompromittierung von verdächtiger Aktivität unterscheiden. Er sollte genügend Metadaten für spätere Suchen aufbewahren.
Er sollte den Kreislauf nicht mit „Überwachung läuft weiter“ schließen, wenn der Kunde immer noch ein ungepatchtes System, einen exponierten Dienst oder ein ungelöstes Identitätsproblem hat.
Rauschreduzierung muss lokal gemessen werden. Wenn Arctic Wolf behauptet, die Alarmlast zu reduzieren, sollte der Kunde die Arbeitsbelastung vor dem Dienst mit der Maßnahmen-Warteschlange nach dem Dienst vergleichen. Wie viele Alarme wurden zu Tickets? Wie viele Tickets erforderten Kundenarbeit? Wie viele waren Fehlalarme? Wie viele wurden wiedereröffnet? Wie viele wurden zu Incident-Response-Fällen? Wie viele führten zu einer dokumentierten Kontrolländerung? Die nützliche Messgröße ist nicht die absolute Anzahl der vom Anbieter verarbeiteten Ereignisse.
Es ist die Anzahl der gültigen Maßnahmen, die der Kunde ausführen kann, ohne in Ausnahmen zu ertrinken.
Reaktionsautorität ist das Scharnier zwischen Beratung und Risikominderung
Arctic Wolfs FAQ sagt, dass kundenorientierte Eskalationen und Maßnahmen mit hohen Auswirkungen menschliche Aufsicht und Genehmigung beinhalten und dass Reaktionsmaßnahmen innerhalb definierter Grenzen arbeiten. Die Dokumentation verweist auch auf Active Response und Endpunkt-Intelligenz als Teil der MDR-Lizenzierung, während Produktaktualisierungen spezifische Identitätsreaktions-Aktionsintegrationen für unterstützte Dienste auflisten. Hier bewegt sich der gemanagte Dienst von der Beratung hin zum Eingreifen.
Die Reaktionsautorität muss mit Sorgfalt ausgehandelt werden. Zu wenig Autorität führt dazu, dass der Anbieter Empfehlungen sendet, die in der Kundenwarteschlange liegen bleiben. Zu viel Autorität kann betriebliche und rechtliche Risiken schaffen. Ein gemanagter Sicherheitsanbieter mag wissen, dass die Deaktivierung eines Kontos die sicherste Cybermaßnahme ist, aber der Kunde mag wissen, dass das Konto einen kritischen Prozess ausführt. Ein Anbieter mag die Isolierung eines Hosts empfehlen, aber der Host kann in einer Produktionskette stehen, wo Ausfallzeiten schädlicher sind als kurzfristige Überwachung.
Ein Anbieter mag auf Notfall-Patching drängen, aber der Kunde kann eine Änderungssperre mit regulatorischen oder sicherheitstechnischen Auswirkungen haben.
Das richtige Modell ist nicht einfach „mehr automatisieren“. Es ist abgestufte Autorität. Maßnahmen mit geringem Risiko können vorautorisiert werden. Maßnahmen mit mittlerem Risiko können eine Kundenbestätigung innerhalb eines definierten Fensters erfordern. Maßnahmen mit hohen Auswirkungen können eine explizite Genehmigung, Eskalation an benannte Rollen und Rollback-Planung erfordern. In allen Fällen sollte das System aufzeichnen, wer die Maßnahme autorisiert hat, welche Beweise sie gestützt haben, was getan wurde und wie das Ergebnis überprüft wurde.
Arctic Wolfs öffentliche Betonung von Schutzmaßnahmen, Least Privilege, Berechtigungen, Überwachung, Protokollierung, Erklärbarkeit, Rollback und menschlicher Genehmigung für Maßnahmen mit hohen Auswirkungen ist mit diesem Modell ausgerichtet. Der Käufer muss trotzdem testen, wie diese Kontrollen im tatsächlich gekauften Servicepaket funktionieren. Eine Produktseite kann die Designphilosophie beschreiben, aber der Vertrag, die Integrationen und die Runbooks des Kunden bestimmen die tatsächliche Autoritätsgrenze.
Eine häufige Fehlerquelle ist eine unklare Zuständigkeit für die Eindämmung. Wenn Arctic Wolf verdächtige Endpunktaktivitäten erkennt, kann es den Host isolieren? Ist diese Funktion in der Lizenz des Kunden verfügbar? Hängt sie von Arctic-Wolf-Endpunktsoftware, einem Drittanbieter-Endpunkt-Tool oder beiden ab? Wer genehmigt die Isolierung? Wie wird eine geschäftskritische Ausnahme behandelt? Wie wird der Host wiederhergestellt? Was passiert, wenn die Isolierung fehlschlägt? Wie wird der Fehler dem Team des Kunden mitgeteilt?
Die Identitätsreaktion wirft ähnliche Fragen auf. Wenn verdächtige Aktivitäten einen Identitätsanbieter oder ein Cloud-Konto betreffen, kann Arctic Wolf den Benutzer deaktivieren, Gruppen entfernen, Anmeldeinformationen zurücksetzen oder eine erneute Authentifizierung erzwingen? Öffentliche Produktaktualisierungen zeigen Fortschritte in diese Richtung für bestimmte Integrationen, aber die Verfügbarkeit einer Integration ist nicht gleichbedeutend mit betrieblicher Bereitschaft.
Das Identitätsteam des Kunden muss wissen, welche Aktionen erlaubt sind, welche eine Genehmigung erfordern und wie Notfalländerungen mit der normalen Identity Governance abgeglichen werden.
Incident Response fügt eine weitere Grenze hinzu. Arctic Wolf bietet Incident-Response- und Incident-Readiness-Dienste an, darunter Wiederherstellung, Behebung schwerwiegender Vorfälle und digitale Forensik. Bei einem größeren Ereignis ist die akzeptierte Maßnahme möglicherweise kein einzelnes Ticket mehr. Sie kann Geschäftswiederherstellung, Beweissicherung, rechtliche Koordinierung, Kommunikation, Versicherung, Verhandlungsstrategie und einen Plan zur Nachbearbeitung umfassen. Der Anbieter kann Teile dieser Arbeit leiten oder durchführen, aber der Kunde behält die Geschäftsentscheidungen.
Die wertvollste gemanagte Beziehung ist eine, in der diese Rollen vor dem Vorfall geklärt sind.
Die Reaktionsautorität ist daher das Scharnier des kommerziellen Versprechens. Erkennung findet Risiken. Triage erklärt sie. Autorität entscheidet, ob der Dienst sie reduzieren kann.
Expositionsmanagement ist nur wertvoll, wenn Erkenntnisse in Abschluss münden
Arctic Wolfs Materialien zum Expositionsmanagement präsentieren einen erweiterten Umfang: Asset-Sichtbarkeit, Schwachstellenmanagement, Angriffsflächenmanagement, Priorisierung, Behebung, Validierung, Patch-Management über Resolve, ITSM-Integrationen, KI-gestützte Anleitungen, anpassbare Behebungs-Service-Level-Ziele und Berichterstattung auf Abruf. Die Richtung ist kommerziell sinnvoll. Viele Organisationen scheitern nicht, weil ihnen Schwachstellenbefunde fehlen. Sie scheitern, weil sie nicht bestimmen können, welche Befunde wichtig sind, welche Assets real sind, wer sie besitzt und ob die Behebung stattgefunden hat.
Die akzeptierte Maßnahme im Expositionsmanagement unterscheidet sich von der akzeptierten Maßnahme im MDR. Ein Erkennungsfall fordert den Kunden normalerweise auf, auf eine vermutete oder bestätigte Bedrohung zu reagieren. Ein Expositionsfall fordert den Kunden auf, die Wahrscheinlichkeit oder den Schadensradius einer zukünftigen Bedrohung zu reduzieren. Das macht es leichter, ihn aufzuschieben. Eine kritische Schwachstelle auf einem internetzugewandten Dienst wird möglicherweise behandelt. Eine Fehlkonfiguration in einem System mit niedrigerem Profil kann wochenlang liegen bleiben. Ein veraltetes Asset kann bestritten werden.
Ein Patch kann eine Anwendung beschädigen. Ein Scanner kann weiterhin einen Befund melden, nachdem ein Workaround implementiert wurde.
Arctic Wolfs bester Weg ist, Expositionsarbeit mit betrieblichem Kontext zu verbinden. Die öffentlichen Seiten sagen, dass Aurora Vulnerability Management Befunde mit Asset-Kontext, Bedrohungsinformationen und Ausbeutungswahrscheinlichkeit anreichert und dass Attack Surface Management Bedrohungsinformationen, Geschäftskontext, Asset-Kritikalität, Schweregrad und Ausbeutbarkeit korreliert und gleichzeitig Behebungen überprüft. Das sind die richtigen Eingaben. Ein generischer CVSS-Score ist nicht genug.
Eine Schwachstelle auf einem unverwalteten, öffentlich zugänglichen Asset, das von einem privilegierten System verwendet wird, hat eine andere Maßnahmenpriorität als dieselbe Schwachstelle auf einem Labor-Host hinter kompensierenden Kontrollen.
Aber das Expositionsmanagement ist auch der Bereich, in dem die Arbeit auf Kundenseite am sichtbarsten ist. Der Anbieter kann priorisieren. Der Kunde patcht, ändert Konfigurationen, ersetzt Assets, akzeptiert Risiken oder finanziert Behebungen. Arctic Wolfs Resolve Patch-Management-Add-on kann einen Teil dieser Last für unterstützte Endpunkte und Betriebssysteme reduzieren, und öffentliche Aktualisierungen zeigen, dass im Juni 2026 macOS- und Linux-Unterstützung für Resolve hinzugefügt wurde.
Aber selbst dann hat Patch-Management Voraussetzungen: Abdeckung, Terminplanung, Rollback-Toleranz, Wartungsfenster, Anwendungstests und Ausnahmebehandlung.
Der Käufer sollte Arctic Wolf bitten, den vollständigen Workflow von Risiko zu Behebung zu demonstrieren. Ein Befund erscheint. Die Plattform dedupliziert ihn. Sie ordnet das Asset zu. Sie priorisiert basierend auf Bedrohungs- und Geschäftskontext. Sie eröffnet oder synchronisiert ein Ticket. Sie weist einen Eigentümer zu. Sie setzt ein Zieldatum. Sie bietet Behebungsanleitungen. Sie verfolgt den Status. Sie scannt erneut oder validiert anderweitig. Sie berichtet, ob das Risiko reduziert wurde. Sie eskaliert verfehlte Ziele. Sie bewahrt Ausnahmen und Risikoakzeptanzen auf.
Die gefährlichste Version des Expositionsmanagements ist eine, die Dashboards verbessert, ohne die Realität zu ändern. Wenn derselbe exponierte Dienst weiterhin erreichbar ist, dieselbe ungepatchte Schwachstelle wiederkehrt oder dasselbe unverwaltete Asset immer wieder auftaucht, hat der Kunde das Risiko nicht reduziert. Arctic Wolfs Berichterstattung sollte Wiederholungen sichtbar machen, nicht in aggregierten Verbesserungen begraben. Der Unterschied zwischen „wir haben 5.000 Risiken entdeckt“ und „wir haben die 40 Risiken geschlossen, die am wahrscheinlichsten relevant sind“ ist der Unterschied zwischen Aktivität und Ergebnis.
Die kommerzielle Frage des Artikels sitzt auch hier. Expositionsmanagement kann MDR wertvoller machen, weil es die Anzahl vermeidbarer Vorfälle reduziert. Es kann auch die Arbeitslast des Kunden erhöhen, wenn jeder priorisierte Befund zu einem umstrittenen Ticket wird. Arctic Wolfs Wert hängt davon ab, ob seine Priorisierung vertrauenswürdig genug ist, dass Kundenteams darauf reagieren.
Ticketing, APIs und Berichterstattung entscheiden, ob die Maßnahme die Übergabe überlebt
Sicherheitsmaßnahmen scheitern oft, nachdem der Analyst gute Arbeit geleistet hat. Der Fall ist klar, aber das Arbeitssystem des Kunden ist woanders. Das Ticket verliert bei der Synchronisation Felder. Das verantwortliche Team sieht die Dringlichkeit nicht. Kommentare teilen sich zwischen Portalen auf. Doppelte Tickets verwirren den Status. Ein Behebungsschritt wird im ITSM-Tool abgeschlossen, aber nicht im Sicherheitsportal widergespiegelt. Ein Dashboard zeigt ein geringeres Risiko an, während der Asset-Eigentümer denkt, die Arbeit sei noch ausstehend.
Arctic Wolfs Dokumentation adressiert einen Teil dieser Oberfläche. Es unterstützt die ITSM-Ticket-Synchronisation zwischen dem Arctic Wolf Unified Portal und der ITSM-Software des Kunden, mit Webhook-Integrationen für ConnectWise und ServiceNow und einem generischen Zwei-Wege-Pull-Modell über die Arctic Wolf Ticket API. Die Dokumentation weist darauf hin, dass kundenspezifische Integrationen technisches Personal des Kunden erfordern, da Kunden ihre eigenen Tools kennen. Das ist eine wichtige Einschränkung. Die Verfügbarkeit von Integrationen beseitigt nicht den Implementierungsaufwand.
Der Workflow der akzeptierten Maßnahme hängt von dieser Übergabe ab. Wenn der Kunde in ServiceNow, ConnectWise oder einem anderen ITSM-System lebt, muss Arctic Wolfs Fall als nutzbares Arbeitselement ankommen. Er sollte Schweregrad, Beweise, Fälligkeitsdatum, empfohlene Maßnahme, Eigentümer, betroffenen Dienst, Asset-Identifikatoren, Kommentare, Anhänge, Eskalationshistorie und Abschlusskriterien bewahren. Wenn ein Sicherheitsanalyst Details manuell neu eingeben oder Zustände abgleichen muss, verliert der gemanagte Dienst an der Grenze an Wert.
Die Ticket-API und die Berichts-API sind ebenfalls relevant, weil reife Kunden oft Sicherheitsoperationen in ihrer eigenen Berichtsumgebung messen möchten. Sie müssen möglicherweise Arctic-Wolf-Maßnahmen mit Änderungsmanagement, Asset-Inventar, Schwachstellenbehebung, Incident-Registern, Compliance-Kontrollen, Versicherungsanforderungen und Executive-Dashboards verknüpfen. APIs können dies unterstützen, aber nur, wenn Felder stabil, dokumentiert, Ratenlimits verstanden, die Authentifizierung sicher gehandhabt und Statussemantiken klar sind.
Der Käufer sollte die Berichterstattung über den Abschluss von Maßnahmen testen, nicht nur über die Anzahl der Alarme. Kann der Kunde alle Fälle mit hohem Schweregrad für ein Quartal exportieren? Kann er identifizieren, welche empfohlenen Maßnahmen akzeptiert, abgelehnt, abgeschlossen oder überfällig waren? Kann er sehen, welche Geschäftseinheiten wiederholt Behebungsziele verpassen? Kann er ein abgeschlossenes Ticket mit Validierungsnachweisen verknüpfen? Kann er unterscheiden zwischen „von Arctic Wolf empfohlen“, „vom Kunden durchgeführt“ und „Risiko akzeptiert“?
Kann er Prüfern den Ereignisablauf zeigen, ohne Screenshots manuell zusammenzustellen?
Öffentliche Produktaktualisierungen zeigen fortlaufende Verbesserungen bei Berichterstattung und Datenerkundung, darunter Berichtssynchronisation und suchbezogene Funktionen. Diese sind nützlich, aber die Berichterstattung ist nur so stark wie der zugrunde liegende Prozess. Wenn ein Ticket ohne validierte Behebung geschlossen werden kann, kann der Bericht falsche Sicherheit schaffen. Wenn Kundenkommentare nicht zurück synchronisiert werden, kann Arctic Wolfs Team mit veraltetem Status arbeiten. Wenn die Duplikatsvermeidung schwach ist, können zwei Teams dasselbe Risiko unterschiedlich bearbeiten.
Deshalb ist die Maßnahme die richtige Bewertungseinheit. Eine Maßnahme ist nicht abgeschlossen, wenn ein Fall erstellt wird. Sie ist abgeschlossen, wenn der richtige Eigentümer sie akzeptiert hat, der vereinbarte Schritt durchgeführt wurde, das Ergebnis überprüft oder explizit risikoakzeptiert wurde und die Beweise für eine spätere Überprüfung verfügbar sind. Ticketing, APIs und Berichterstattung sind die Schienen, die dies im Maßstab ermöglichen.
Kundenseitige Wirtschaftlichkeit entscheidet, ob gemanagte Sicherheit günstiger ist als der Aufbau eigener Fähigkeiten
Arctic Wolfs kommerzielle Anziehungskraft ist am klarsten für Organisationen, die kein vollständiges internes Sicherheitsoperationszentrum aufbauen können oder wollen. Das Unternehmen sagt, es bediene Tausende von Kunden in verschiedenen Branchen und Regionen, mit 24x7-Überwachung, Sicherheitsexperten und geführter Risikominderung. Es positioniert seinen Dienst auch gegen Fachkräftemangel, Tool-Vielfalt und steigende Sicherheitskosten.
Das sind echte Käuferprobleme. Die Einstellung, Schulung und Bindung erfahrener Analysten ist teuer. Die Aufrechterhaltung einer 24x7-Abdeckung ist schwierig. Die Pflege von Erkennungen, Integrationen, Eskalationen, Bedrohungsjagd und Incident-Playbooks erfordert ein spezialisiertes Betriebsmodell. Für viele Mid-Market- und Enterprise-Teams kann ein gemanagter Dienst eine bessere Baseline liefern als ein dünnes internes Team, das einen Stapel von Tools überwacht.
Aber gemanagte Sicherheit ist nach dem Kauf nicht kostenlos. Der Kunde zahlt weiterhin Servicegebühren, integriert Telemetrie, nimmt am Onboarding teil, nimmt an Überprüfungen teil, führt Behebungen durch, behandelt Ausnahmen, aktualisiert Kontakte, verwaltet Identitäts- und Endpunktabdeckung, beteiligt sich an der Incident Response und finanziert Kontrollverbesserungen. Wenn die Umgebung des Kunden unorganisiert ist, kann der gemanagte Dienst mehr Arbeit offenlegen, als das Team erwartet hat. Das ist nicht unbedingt schlecht; ein zuvor verborgenes Risiko ist immer noch ein Risiko. Aber es verändert die Wirtschaftlichkeit.
Der Käufer sollte die Kosten der akzeptierten Maßnahme berechnen, nicht nur die Kosten der Überwachung. Angenommen, Arctic Wolf reduziert das Alarmrauschen, erzeugt aber einen kleineren Strom qualitativ hochwertiger Maßnahmen. Wer führt diese Maßnahmen durch? Wie viele Stunden verbraucht das Patchen? Wie viel Geschäftsunterbrechung entsteht durch Notfalländerungen? Wie viel interne Zeit wird für monatliche Überprüfungen benötigt? Wie viel Aufwand fließt in die Wartung von Konnektoren? Wie oft benötigt der Kunde Incident-Response-Unterstützung außerhalb des Kerndienstes? Welche Versicherungs-, Compliance- oder Board-Reporting-Vorteile gibt es?
Welche Arbeit kann vermieden werden, weil Arctic Wolfs Team Triage, Recherche, Anreicherung und Empfehlungen durchführt?
Die Auswahl von Arctic Wolf durch Chubb als bevorzugten MDR-Anbieter für qualifizierte Cyber-Versicherungsnehmer ist ein bedeutendes Marktsignal, da Versicherer an betrieblichen Kontrollen interessiert sind, die die Wahrscheinlichkeit und Schwere von Schadensfällen reduzieren. Es beweist nicht, dass jeder Arctic-Wolf-Kunde Verluste reduzieren wird, aber es zeigt, dass ein Versicherungsakteur Wert in dem Kontrollmuster sieht: breite Sichtbarkeit, kontinuierliche Überwachung, Bedrohungserkennung und geführte Implementierung kritischer Kontrollen.
Die Ausrichtung auf Versicherungen kann die Wirtschaftlichkeit beeinflussen, wenn sie die Versicherbarkeit, Preisgestaltung, Kontrollnachweise oder die Erneuerungsposition verbessert.
Gartner Peer Insights-Material und Arctic Wolfs eigene Verweise auf hohe Weiterempfehlungsraten und Kundenbewertungen liefern zusätzlichen Marktsignalkontext. Sie sind nützlich, aber nicht entscheidend. Die Bewertungspopulationen sind selbstselektierend, und die Umgebungen der Käufer unterscheiden sich. Ein kleines IT-Team schätzt möglicherweise Arctic Wolfs Alarmfilterung und Beratungsmodell, weil ihm interne Analysten fehlen.
Ein reifes Enterprise-SOC kümmert sich möglicherweise mehr um die Integrationstiefe, die Kontrolle über Playbooks, die API-Treue und wie Arctic Wolf mit bestehenden SIEM-, SOAR-, Endpunkt- und Cloud-Sicherheitsinvestitionen koexistiert.
Der stärkste wirtschaftliche Fall ergibt sich, wenn Arctic Wolf dem Kunden hilft, Arbeit zu erledigen, die er sonst nicht gut erledigen würde: kontinuierliche Überwachung aufrechterhalten, Identitäts- und Cloud-Signale verbinden, verdächtige Aktivitäten triagieren, Expositionsarbeit priorisieren, Incident Response koordinieren, Board-berichte erstellen und Druck auf die Behebung aufrechterhalten. Der schwächste Fall ergibt sich, wenn der Kunde bereits über starke interne Abläufe verfügt und Arctic Wolf eine weitere Schicht von Alarmen, Portalen und Besprechungen wird.
Die Schlussfolgerung ist pragmatisch. Arctic Wolf sollte nicht gekauft werden, um Verantwortung zu vermeiden. Es sollte gekauft werden, wenn der Kunde bereit ist, den Dienst als Betriebspartner zu nutzen und zu messen, ob akzeptierte Maßnahmen schneller, mit besseren Beweisen und weniger internem Aufwand erfolgen, als der Kunde allein erreichen könnte.
Vorfallbeispiele zeigen die Workflow-Form, nicht die universelle Leistung
Die Incident-Response-Zeitlinienseiten von Arctic Wolf gehören zu den klarsten öffentlichen Artefakten, um das bevorzugte Betriebsmodell des Unternehmens zu verstehen. Die Ransomware-Zeitlinie zeigt Aktivitäten, die von Active Directory und einem Arctic-Wolf-Sensor erkannt wurden, Korrelation von Command-and-Control-Verkehr mit PowerShell Empire-Aktivität, Eskalation zur Triage und anschließende Behebung.
Die Zeitlinie zur Microsoft Exchange-Schwachstelle zeigt Onboarding, Erkennung, Untersuchung, Eskalation, Eindämmung, Behebungsschritte, einen Kundenanruf und anschließende Sicherheitsreise-Arbeit wie Patch-Bewertung, Kontozurücksetzungen, Firewall-Blockierungsregeln und zusätzliche Härtung.
Diese Beispiele sollten sorgfältig behandelt werden. Es sind kuratierte öffentliche Darstellungen, keine randomisierten Leistungstests. Sie beweisen nicht, dass jeder Kunde die gleiche Geschwindigkeit erhält, jedes Signal erkannt wird, jede Eindämmung erfolgreich ist oder jede Behebung abgeschlossen wird. Der Artikel verwendet sie nicht so.
Ihr Wert liegt darin, dass sie die Art von Workflow offenbaren, den Arctic Wolf von Käufern erwarten möchte. Der Dienst ist nicht nur „wir haben einen Alarm gesehen“. Es ist eine Sequenz: Quellsignal, Plattformkorrelation, Triage-Eskalation, Analystenprüfung, Kundenkontakt, Eindämmung, Behebung, Nachverfolgung und Verbesserung der Haltung. Das ist die richtige Form für gemanagte Sicherheitsoperationen. Es zeigt auch die Stellen, an denen Fehler auftreten können.
In der Quellphase kann Telemetrie fehlen. In der Korrelationsphase können Signale nicht verknüpft sein. In der Triage-Phase kann die Dringlichkeit falsch sein. In der Kundenkontaktphase kann der richtige Eigentümer nicht erreichbar sein. In der Eindämmungsphase kann die Autorität unzureichend sein. In der Behebungsphase kann dem Kunden die Patch-Kapazität fehlen. In der Nachverfolgungsphase kann die Organisation den unmittelbaren Vorfall schließen, aber die systemische Schwäche ignorieren.
Gute gemanagte Sicherheit verwandelt diese Fehlerpunkte in explizite Kontrollen. Kontaktlisten werden gepflegt. Eskalationswege werden getestet. Playbooks definieren Autorität. Tickets bewahren Beweise. Kundenspezifischer Kontext wird aktualisiert. Schwachstellenscans und Lagebeurteilungen fließen in zukünftige Prioritäten ein. Lehren aus Vorfällen ändern Erkennungs- und Behebungspläne. Die Zeitlinie wird zu einer Betriebsschleife, nicht zu einer Geschichte über ein einzelnes Ereignis.
Der Käufer sollte Arctic Wolf bitten, anhand aktueller anonymer Beispiele, die der eigenen Umgebung des Kunden ähneln, durchzugehen. Ein Krankenhaus, ein Hersteller, eine lokale Regierung, ein Einzelhändler, ein Softwareunternehmen und ein Finanzdienstleister haben nicht die gleichen Einschränkungen. Geschäftskritische Ausfallzeiten, Datenschutzanforderungen, Cyber-Versicherungspflichten, rechtliche Koordinierung und Abhängigkeiten von Dritten unterscheiden sich. Ein relevantes Beispiel ist eines, bei dem die Übergabe, Autorität und Behebungsbeschränkungen vertraut wirken.
Die wichtigere Sorgfaltsübung ist, einen Vorfall zu proben, bevor er eintritt. Wer beim Kunden erhält um 2 Uhr morgens die Eskalation von Arctic Wolf? Wer kann die Host-Isolierung autorisieren? Wer kann eine privilegierte Identität deaktivieren? Wer kann Notfall-Firewall-Änderungen genehmigen? Wer kann Führungskräfte kontaktieren? Wer ist für die Beweissicherung verantwortlich? Wer kommuniziert mit Versicherern? Wer entscheidet, wann die Geschäftswiederherstellung Vorrang vor der forensischen Vollständigkeit hat? Arctic Wolf kann Fachwissen liefern, aber die Entscheidungskarte des Kunden muss existieren.
Vorfallbeispiele stützen das Vertrauen in die Richtung des Modells. Sie heben nicht die Notwendigkeit einer lokalen Probe auf.
KI ist nur nützlich, wenn sie Aufsicht und Prüfbarkeit bewahrt
Arctic Wolfs aktuelle Plattformsprache umfasst fortschrittliche KI-Workflows, spezialisierte Automatisierung, ein Swarm of Experts-Framework, einen Security Operations Graph, die Verarbeitung großer Ereignismengen, kundenspezifischen Kontext und eine AI Trust Engine mit Kontrollen für Tests, Berechtigungen, Überwachung, Protokollierung, Erklärbarkeit, Rollback und menschliche Genehmigung. Das Unternehmen sagt auch, dass aktuelle generative KI-Funktionalität nicht auf Kundendaten trainiert wird, während relevante Kunden- und Sicherheitsdaten zum Zeitpunkt des Aufrufs verwendet werden können, um den Kontext zu verbessern.
Für den Blickwinkel dieses Artikels ist KI nicht das Kernstück. Die akzeptierte Maßnahme ist es. KI ist nur insoweit nützlich, wie sie hilft, bessere akzeptierte Maßnahmen zu produzieren. Wenn sie Beweise anreichert, Signale bündelt, verwandte Ereignisse durchsucht, klarere Tickets entwirft, ähnliche vergangene Fälle identifiziert, große Datenmengen zusammenfasst oder fehlenden Kontext hervorhebt, kann sie die Zykluszeit und die Analystenermüdung reduzieren. Wenn sie selbstbewusste, aber dünne Empfehlungen produziert, Unsicherheit verbirgt oder verschwimmen lässt, wer eine Maßnahme genehmigt hat, wird sie zu einem Risiko.
Sicherheitsoperationen haben eine höhere Rechenschaftspflicht als viele andere Software-Workflows. Eine fehlerhafte Empfehlung kann ein kritisches Konto deaktivieren, einen Produktionsserver isolieren, einen aktiven Einbruch übersehen, private Daten offenlegen oder einen Prüfpfad erstellen, der sich später als irreführend erweist. Deshalb ist Arctic Wolfs öffentliche Betonung von Grenzen, Least Privilege und menschlicher Genehmigung wichtig. Der Käufer sollte diese Kontrollen als Inspektionspunkte behandeln, nicht als Slogans.
Die Fragen sind konkret. Welche Maßnahmen können KI-Workflows initiieren? Welche können sie nur empfehlen? Welche Maßnahmen erfordern eine Analystenvalidierung? Welche erfordern eine Kundenfreigabe? Wie werden Modelleingaben, abgerufene Beweise, Systemempfehlungen und manuelle Überschreibungen protokolliert? Wie verhindert das System das Auslaufen von Kontext zwischen Kunden? Wie werden Fehlempfehlungen erkannt und zurückgemeldet? Welches Rollback gibt es für automatisierte oder halbautomatisierte Aktionen? Wie kann ein Kunde die Beweise hinter einer vorgeschlagenen Eindämmung oder Behebung überprüfen?
Die glaubwürdigste KI-Nutzung in diesem Umfeld ist begrenzte Unterstützung. Ein Fall beginnt mit einem Signal. Automatisierte Workflows sammeln verwandte Ereignisse, wenden Bedrohungsinformationen an, prüfen kundenspezifischen Kontext und erstellen ein Beweispaket. Ein menschlicher Analyst validiert die Schlussfolgerung und schließt den Fall entweder, eskaliert ihn oder empfiehlt eine Maßnahme. Der Kunde erhält ein Ticket mit ausreichender Erklärung zum Handeln. Schritte mit hohen Auswirkungen erfordern eine Genehmigung. Das System protokolliert die Entscheidung und das Ergebnis. Zukünftige Fälle profitieren vom Ergebnis.
Dieses Modell unterstützt den Workflow der akzeptierten Maßnahme. Es erhöht die Geschwindigkeit, ohne so zu tun, als sei Cybersicherheit ein vollständig autonomes Problem geworden. Es respektiert auch die zurückbehaltene Verantwortung des Kunden. Selbst wenn Arctic Wolf mehr Analysen automatisch durchführt, behält der Kunde weiterhin die Systeme, das Geschäftsrisiko und viele Behebungsentscheidungen.
Der Käufer sollte vorsichtig sein mit jeder KI-Behauptung, die nicht auf ein tägliches betriebliches Artefakt zurückgeführt werden kann. „Mehr Automatisierung“ ist kein Geschäftsergebnis. „Dieser Fall erreichte den richtigen Eigentümer mit klaren Beweisen, die Maßnahme wurde genehmigt, die Behebung wurde verifiziert und der Prüfpfad ist vollständig“ ist ein Geschäftsergebnis. Die Plattformgeschichte von Arctic Wolf sollte nach dem zweiten Standard bewertet werden.
Die Kundenerfahrung hängt davon ab, ob Beratung zu einem gemeinsamen Betriebsrhythmus wird
Arctic Wolfs Concierge-Modell ist darauf ausgelegt, Rhythmus zu schaffen: Überprüfungen, Lagebeurteilungen, strategische Beratung, Überwachung, Berichterstattung, Behebungsunterstützung und Planung der Sicherheitsreise. Die beste Version dieses Modells gibt einem Kunden einen Sicherheitsbetriebsrhythmus, den er allein nicht aufrechterhalten könnte. Die schlechteste Version wird zu einem monatlichen Meeting, in dem offene Punkte überprüft werden, ohne genügend Autorität, um den Rückstand zu ändern.
Der Unterschied ist die Agenda-Disziplin. Eine nützliche Überprüfung sollte mit dem Maßnahmenstatus beginnen: kritische Vorfälle, ungelöste hochprioritäre Befunde, überfällige Behebungen, wiederholte Expositionen, Integrationslücken, laute Erkennungen, Fehlalarme, verpasste Eskalationen und Ausnahmen. Sie sollte dann diese Punkte mit Geschäftsentscheidungen verbinden. Muss der Kunde die Endpunktabdeckung finanzieren? Ein defektes Patch-Tool ersetzen? Identitätsreaktions-Runbooks aktualisieren? Die Backup-Richtlinie ändern? VPN-Kontrollen verschärfen? Veraltete internetzugewandte Assets ausmustern? Eine Cloud-Integration hinzufügen?
Eine Geschäftseinheit schulen, die wiederholt auf Phishing-Simulationen klickt?
Arctic Wolf kann die Daten und Empfehlungen liefern, aber der Kunde muss sie in Entscheidungen umsetzen. Deshalb ist die Linse der akzeptierten Maßnahme auch eine Management-Linse. Ein Unternehmen, das MDR kauft und dann wiederholte Behebungsempfehlungen ignoriert, erhält keinen schlechten Wert, weil dem Anbieter Alarme fehlen. Es erhält schlechten Wert, weil die Betriebsschleife unterbrochen ist.
Sicherheitssensibilisierung fügt sich in diesen Rhythmus ein. Arctic Wolfs öffentliche Lösungsnavigation rahmt Sensibilisierung und Schulung so ein, dass Mitarbeiter eingebunden werden, um Social-Engineering-Angriffe zu erkennen und zu neutralisieren, mit Phishing-Simulationen und relevantem Mikrolernen. Sensibilisierung wird oft anhand der Abschlussrate oder Klickrate bewertet. Für den Zweck dieses Artikels ist die Maßnahmenfrage schärfer: Wenn ein Muster auftritt, verändert das Training das Verhalten, die Meldung, die Richtlinie oder das Kontrolldesign?
Wenn eine Abteilung wiederholt simulierte oder reale Bedrohungen falsch behandelt, hilft das Concierge-Team dem Kunden, Abwehrmaßnahmen und Schulungen anzupassen? Wenn Training Benutzermeldungen produziert, werden diese Meldungen triagiert und in Erkennungs-Workflows eingespeist?
Cloud-Erkennung und -Reaktion hängen ebenfalls vom Rhythmus ab. Die Liste der unterstützten Integrationen ist breit und umfasst wichtige Cloud-, SaaS-, Identitäts-, E-Mail- und Netzwerkquellen. Aber Cloud-Umgebungen ändern sich schnell. Neue Mandanten, unverwaltete SaaS-Tools, temporäre Anmeldeinformationen, Entwicklerexperimente und Berechtigungsdrift können Lücken schaffen. Der gemanagte Dienst sollte dem Kunden helfen, die Sichtbarkeit aufrechtzuerhalten, während sich die Umgebung ändert. Sonst wird eine einmal gute Integrationskarte veraltet.
Das Gleiche gilt für die Incident-Readiness. Ein Retainer- oder Incident-Response-Dienst ist am wertvollsten, wenn die Vorbereitung dem Ereignis vorausgeht. Kontaktlisten, Autoritätsmatrizen, Beweiserwartungen, Versicherungsanforderungen und Wiederherstellungsprioritäten sollten vor der Krise bekannt sein. Arctic Wolfs öffentliche Vorfallmaterialien und Dienstbeschreibungen unterstützen diese Ausrichtung, aber Kunden müssen trotzdem proben.
Der gemeinsame Rhythmus sollte zu weniger Überraschungen führen. Nicht zu keinen Vorfällen, keinen Fehlalarmen und keinen dringenden Tickets; diese Versprechen wären unrealistisch. Sondern zu weniger Momenten, in denen der Kunde sagt: „Wer ist dafür verantwortlich?“ oder „Warum haben Sie uns nicht gesagt, dass dies wichtig ist?“ oder „Warum wurde dieses Ticket geschlossen?“ Ein starker gemanagter Betriebspartner macht diese Fragen seltener.
Wo Arctic Wolfs öffentliche Beweise stark sind und wo sie begrenzt bleiben
Die öffentlichen Beweise stützen mehrere Schlussfolgerungen mit moderatem Vertrauen. Arctic Wolf hat ein breites, aktuelles Portfolio gemanagter Sicherheitsoperationen. Die MDR-Dokumentation deckt kontinuierliche Überwachung, Telemetrieanreicherung, Endpunkt-Intelligenz, Active Response und ein benanntes Concierge-Team ab. Die Expositionsmanagement-Seiten adressieren Asset-Sichtbarkeit, Schwachstellenpriorisierung, Behebungsanleitungen, ITSM-Integration, Validierung und Patch-Management-Unterstützung. Die Cloud-Erkennungsdokumentation zeigt eine breite Integrationsoberfläche über SaaS, Identität, IaaS, E-Mail, SASE und Sicherheitstools.
Die ITSM- und API-Dokumentation zeigt, dass Maßnahmenübergabe und Berichterstattung Teil des Betriebsmodells sind. Die Vorfallbeispiele zeigen die beabsichtigte Sequenz vom Signal zur Behebung und Nachverfolgung. Die Versicherungs- und Überprüfungsmarktsignale deuten auf Marktakzeptanz für den Ansatz gemanagter Operationen hin.
Die öffentlichen Beweise belegen mehrere Dinge nicht, die Käufer am meisten interessieren könnten. Sie verifizieren nicht unabhängig die Erkennungsgenauigkeit in verschiedenen Kundenumgebungen. Sie belegen keine Fehlalarmraten, Falsch-negativ-Raten, Eindämmungserfolge, Behebungsabschlüsse, Alarm-zu-Maßnahmen-Latenz, Analystenkonsistenz, kundenspezifische Kosteneinsparungen oder die Qualität jeder Integration. Sie zeigen nicht, wie oft Kunden empfohlene Maßnahmen nicht durchführen. Sie zeigen nicht, wie viel Arbeit Kunden nach dem Abonnement behalten müssen.
Sie zeigen nicht, ob sich jede Produktoberfläche im täglichen Betrieb einheitlich anfühlt.
Diese Unterscheidung sollte nicht als Ablehnung verstanden werden. Gemanagte Sicherheit ist aus öffentlichen Quellen schwer zu bewerten, weil die Arbeit in Kundenumgebungen stattfindet. Ein Anbieter kann Dokumentation, Fallstudien und Beispiele veröffentlichen, aber die endgültige Antwort hängt von Datenqualität, Autorität, Playbooks, Kundenreaktionsfähigkeit und Geschäftsbeschränkungen ab. Arctic Wolfs öffentliche Materialien sind stark genug, um eine ernsthafte Prüfung für Kunden zu rechtfertigen, die gemanagte Sicherheitsoperationen suchen. Sie sind nicht stark genug, um einen lokalen Nachweis zu überspringen.
Der Käufer sollte eine strukturierte Bewertung anhand akzeptierter Maßnahmen durchführen. Während einer Proof-of-Concept- oder frühen Onboarding-Phase wählen Sie mehrere repräsentative Szenarien aus: verdächtige Identitätsaktivität, Endpunkt-Malware-Signal, Cloud-Fehlkonfiguration, Hochrisikoschwachstelle, Phishing-Meldung, exponiertes Asset und Vorfalle Skalation. Messen Sie für jedes, ob Arctic Wolf Beweise sammeln, Priorität zuweisen, Maßnahmen empfehlen, das Ticket weiterleiten, Kontext bewahren, mit dem Kunden koordinieren, den Abschluss überprüfen und das Ergebnis melden kann.
Die gleiche Bewertung sollte die Fehlerbehandlung umfassen. Was passiert, wenn Telemetrie fehlt? Was passiert, wenn ein Ticket angefochten wird? Was passiert, wenn ein empfohlener Patch fehlschlägt? Was passiert, wenn ein Asset-Eigentümer die Frist versäumt? Was passiert, wenn eine Eindämmung die Arbeit stört? Was passiert, wenn Arctic Wolfs Vertrauen gering ist? Was passiert, wenn der Kunde eine Ausnahme wünscht? Diese Fälle offenbaren die Reife des Betriebsmodells mehr als eine saubere Demo.
Arctic Wolfs These ist glaubwürdig, weil sie mit der wirklichen Schwäche vieler Sicherheitsprogramme übereinstimmt: der Lücke zwischen dem Wissen über Risiken und dem richtigen Handeln schnell genug. Das Unternehmen sollte danach beurteilt werden, wie oft es diese Lücke schließt, nicht danach, wie viele Signale es verarbeiten kann.
Die Bewertungstafel des Käufers sollte der Maßnahme vom Signal zum Nachweis folgen
Eine praktische Bewertungstafel für Arctic Wolf beginnt mit der Sichtbarkeit. Sind die erforderlichen Quellen angeschlossen? Sind Endpunkt-, Identitäts-, Netzwerk-, Cloud- und SaaS-Signale echten Assets und Eigentümern zugeordnet? Werden Kollektorausfälle erkannt? Werden neue Umgebungen zur Überwachung hinzugefügt? Werden Integrationsanmeldeinformationen gepflegt? Weiß der Kunde, was Arctic Wolf nicht sehen kann?
Das nächste Maß ist die Triage-Qualität. Sind Fälle verständlich? Enthalten sie Beweise und empfohlene Maßnahmen? Sind Vertrauen und Unsicherheit klar? Sind Fehlalarme handhabbar? Sind verwandte Ereignisse verknüpft? Werden wiederkehrende Probleme erkannt? Kennt das Concierge-Team den kundenspezifischen Kontext, oder wirken Fälle generisch?
Das dritte Maß ist die Autorität. Welche Maßnahmen kann Arctic Wolf direkt ergreifen? Welche erfordern eine Genehmigung? Welche erfordern das IT-Team des Kunden? Sind Notfallgenehmigungen getestet? Sind irreversible Maßnahmen kontrolliert? Ist ein Rollback geplant? Sind Aufzeichnungen nach der Aktion vollständig?
Das vierte Maß ist der Behebungsabschluss. Erreichen Tickets den richtigen Eigentümer? Kennt der Kunde die Frist? Verfolgt Arctic Wolf den Abschluss? Ist die Risikominderung überprüft? Sind Ausnahmen dokumentiert? Werden versäumte Fristen eskaliert? Zeigen Berichte offene Risiken ehrlich?
Das fünfte Maß ist die Wirtschaftlichkeit. Ist das Alarmrauschen gesunken? Hat sich die Arbeitslast der Analysten verändert? Werden Vorfälle früher erkannt? Werden hochprioritäre Expositionen schneller geschlossen? Reduziert der Dienst den Bedarf an interner Einstellung oder 24x7-Abdeckung? Schafft er handhabbare Arbeit oder legt er einen Behebungsrückstand offen, den der Kunde nicht finanzieren kann? Sind Versicherungs-, Prüfungs- und Board-Reporting-Vorteile real genug, um zu zählen?
Das letzte Maß ist das Lernen. Verbessert jeder Vorfall, jeder Fehlalarm, jedes übersehene Signal und jede überfällige Exposition den nächsten Workflow? Passt Arctic Wolf Erkennungen an, aktualisiert Playbooks, verfeinert den Kundenkontext und passt Haltungsempfehlungen an? Ändert der Kunde als Reaktion Kontrollen, Eigentumsverhältnisse und Prozesse? Eine gemanagte Sicherheitsbeziehung, die nicht lernt, wird allmählich zu einem weiteren Alarmkanal.
Unter dieser Bewertungstafel ist Arctic Wolfs Wert weder automatisch noch mysteriös. Das Unternehmen bringt Skalierung, Sicherheitsbetriebskompetenz, eine breite Plattform, gemanagte Triage, Expositionspriorisierung, Incident Response und kundenorientierte Beratung mit. Der Kunde bringt Umgebungszugang, Geschäftskontext, Behebungsautorität und Handlungsbereitschaft mit. Das gemeinsame Produkt ist die akzeptierte Maßnahme.
Das ist die richtige Kaufentscheidungsfrage. Nicht „hat Arctic Wolf MDR?“ Es hat. Nicht „verarbeitet Arctic Wolf viele Ereignisse?“ Es sagt, dass es dies tut, und öffentliche Materialien unterstützen einen groß angelegten Betrieb. Die wichtigere Frage ist, ob der Kunde auf ein Sicherheitssignal verweisen kann, das zu einer dokumentierten Maßnahme, dann zu einer verifizierten Behebung und dann zu einer messbaren Risikominderung wurde. Wenn Arctic Wolf diese Sequenz zur Routine machen kann, hat der gemanagte Dienst Wert.
Wenn die Sequenz an der Übergabe, Autorität, Behebung oder dem Nachweis bricht, hat der Kunde Überwachung ohne ausreichenden betrieblichen Abschluss gekauft.