摘要
- W3C 10 月 1 日的 DID Resolution 草案还把 DID URL 解引用放在 HTTP(S) 绑定中,并设有“合规的网络 DID URL 解引用器”类别。24 日草案撤掉这两项,26 日文本沿用。
- DID 文档仍可按标准的 HTTPS 绑定取得。客户端负责选解析器、处理返回内容,并按完整 URL 的片段或服务参数找到最终资源。
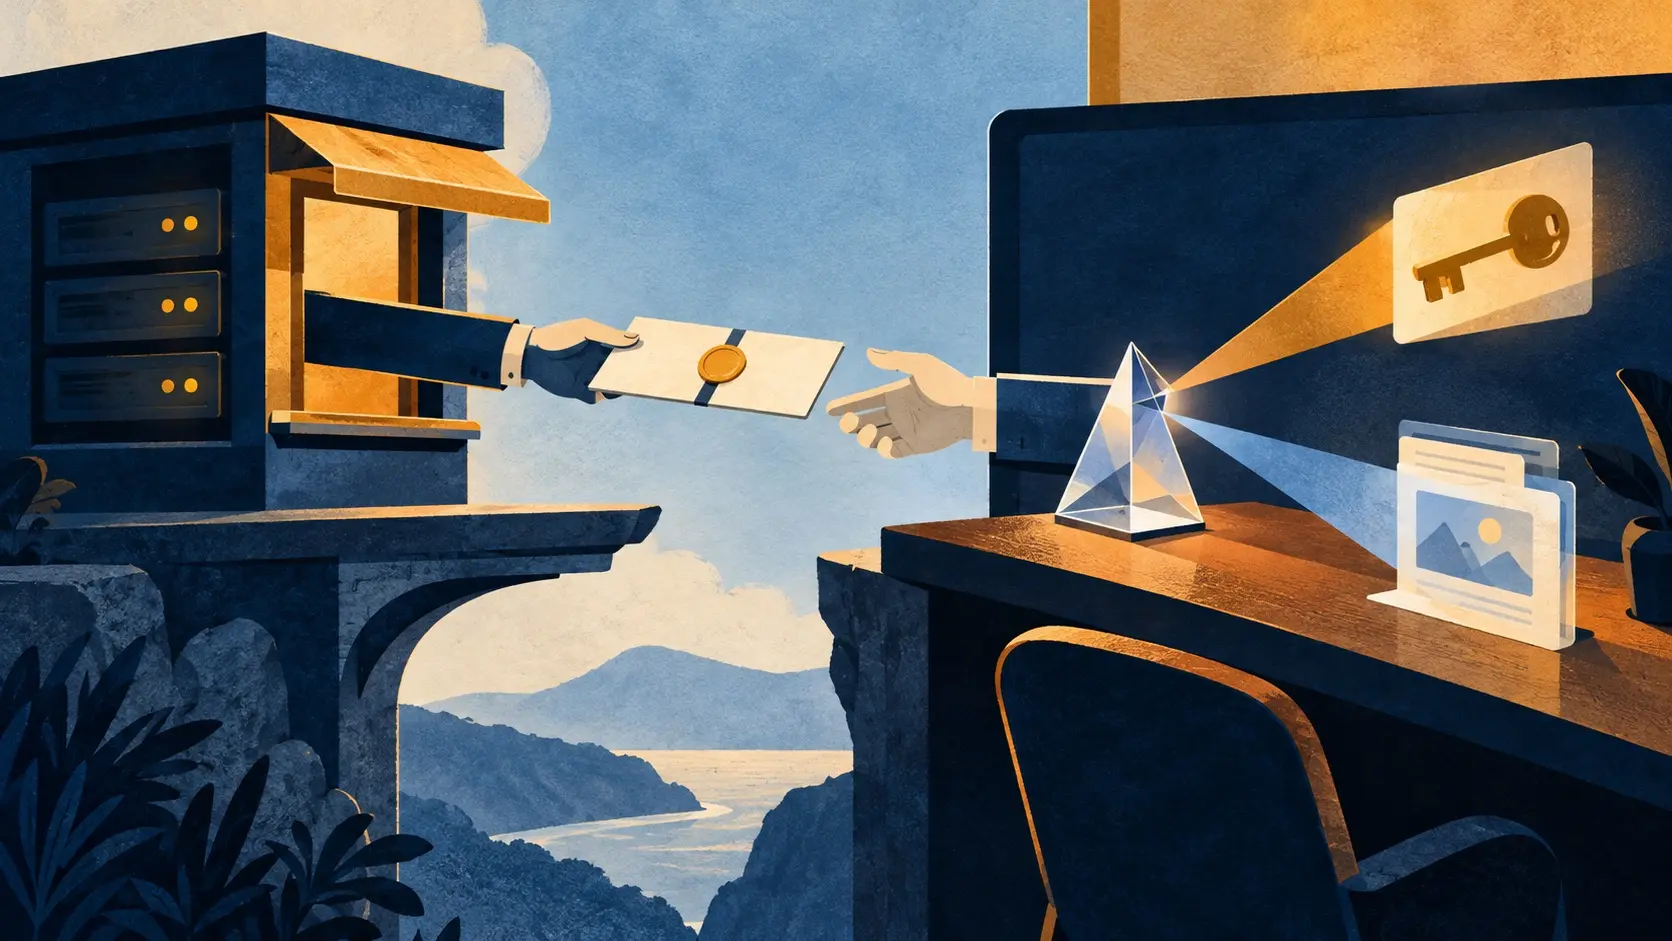
快递显示“已送达”,包裹里的钥匙却还没拿出来。对 did:example:123#key-1 来说,服务器返回 DID 文档只相当于前半句。#key-1 指向什么、该怎样使用,轮到客户端说话。
这条分工线在 W3C 的10 月 26 日候选推荐标准草案中变得清楚。对照10 月 1 日版本,当时 HTTP(S) 绑定既覆盖 DID 解析,也覆盖 URL 解引用,正文还给出网络解引用器的符合性类别和请求示例。10 月 24 日版本撤掉了后半部分。26 日修订记录明确写到,相关 OpenAPI 定义也不再承载解引用。
HTTP 绑定没有消失。现行草案仍为 DID 解析定义网络接口:合规解析器必须支持 HTTPS GET,POST 可以选择实现。它返回 DID 文档及解析元数据。这个接口回答的是“这个 DID 对应什么文档”,让不同方法的客户端有共同的起点。
完整 DID URL 的下半场另有规则。草案中的解引用算法要求客户端让用户按 DID 方法选择解析器,再根据返回结果决定处理策略并调用相应处理器。草案给出的片段示例由客户端完成;指向服务的 URL 还要走服务选择与资源处理。应用所处的业务场景决定最后拿到什么、怎样使用。
这不是文字游戏。W3C 议题 306早在 3 月就提出:片段的最终处理无法交给远程解引用服务包办。10 月 15 日会议纪要则记录了抽象算法如何接上可测试接口的讨论。采购或审计若只看 HTTP 200 和一份 DID 文档,就只检验了第一站;完整 URL 的测试还要看谁选了处理器,以及实际得到了哪份资源。
W3C 仍将解引用标为候选阶段的“存在变动风险”功能。现阶段最实用的记录是两笔:哪台解析器给了文档,哪段客户端逻辑把 URL 变成了可用结果。把第二笔写在第一笔收据背面,账会很难查。
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance