
摘要
- RFC 3722 规定 Unicode 映射、NFKC 规范化及禁用字符检查,使 iSCSI 实现能够逐字节比较经过准备的 UTF-8 名称。
- 这套规则回应了人工抄录与简易设备实现之间的张力,却没有消除冒充风险:相似字形仍然不同,配置也以 Unicode 3.2 为界。
在存储控制台里,两个名称看起来可能没有区别;对目标设备而言,它们却可能是不同的字符串。当管理员从标签、邮件或操作手册抄入一个名称,而精简型发起端必须判断收到的字节是否对应配置中的目标时,这个落差便具有实际后果。2004 年 4 月发布的 RFC 3722,处理的正是 Internet Small Computer Systems Interface(iSCSI)名称中的这一边界。
设计者面对两种不同诉求。人抄写国际化名称时,希望大小写和等价字符有稳定、容易预期的处理方式;小型或嵌入式设备则希望只实现一条明确规则:先准备字符串,再编码成 UTF-8,最后比较字节。如果各实现可以自行决定哪些拼写等价,同一个看似相同的输入就可能产生不同协议值。反过来,如果要求设备进行依赖语言或地区的宽松匹配,协议实现会更复杂,也更难预测。
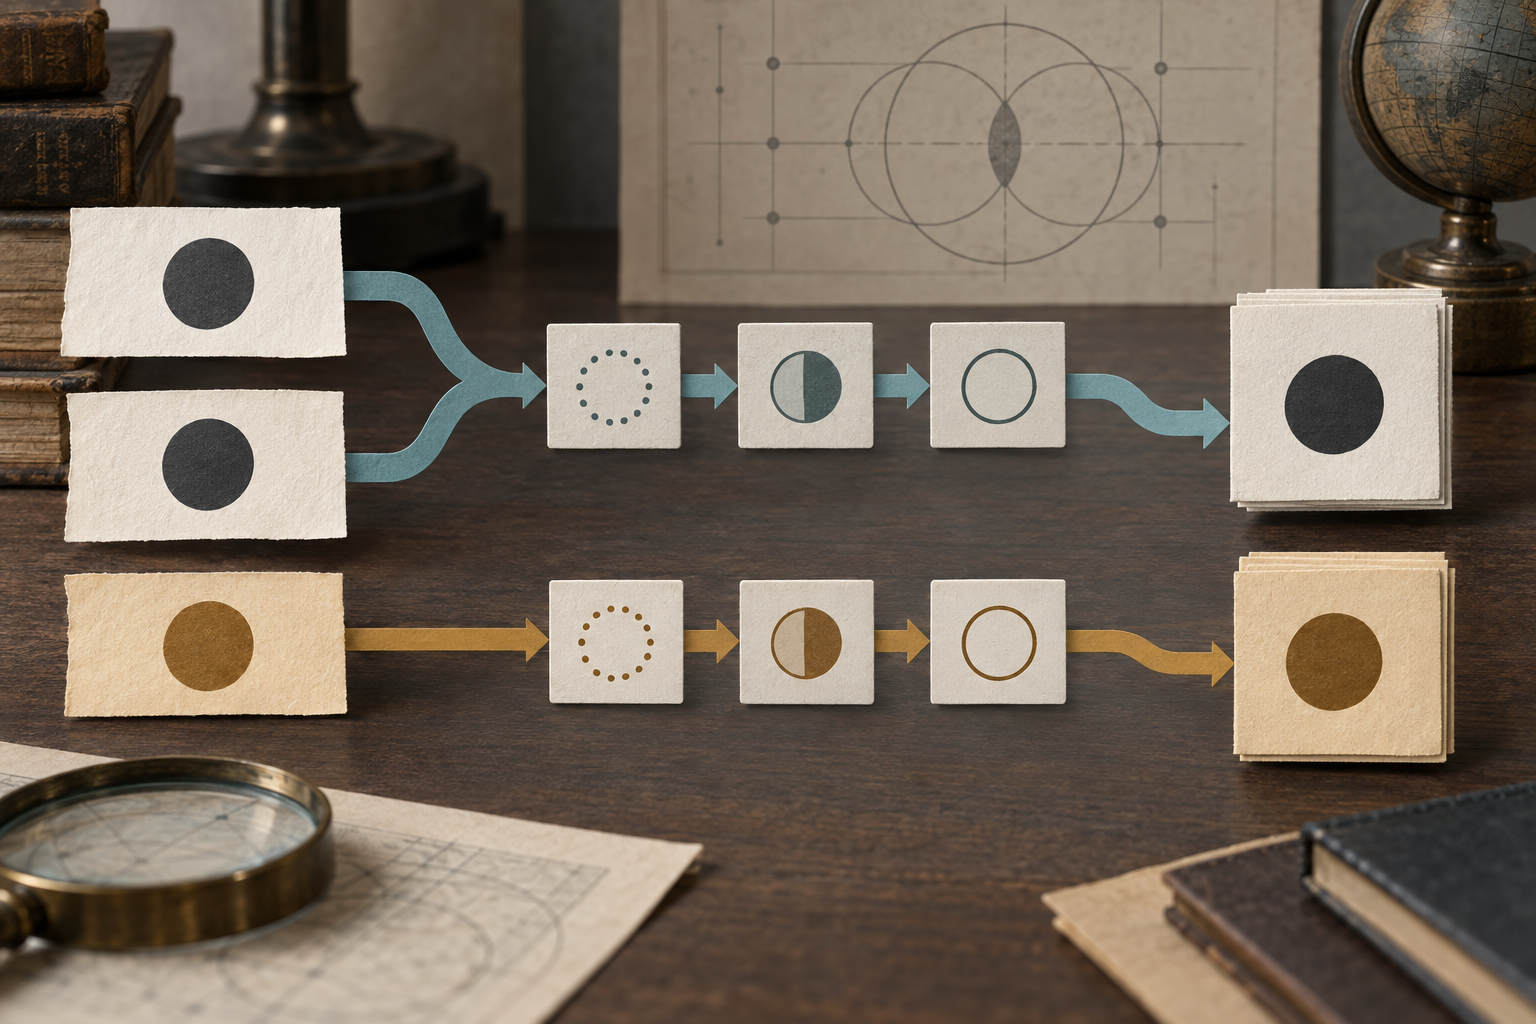
RFC 3722 选择的是一个有边界的 profile,而非开放式文本清理。它固定使用 Unicode 3.2 字符范围,采用 Stringprep 框架表 B.1 和 B.2 的映射,再执行 NFKC 规范化;之后检查 C.1.1 至 C.9 的禁用输出,并执行双向文本检查。这一顺序的意义在于,收到名称后,实现不能再临时创造一套对自己有利的等价关系。
有些差异会被消除,有些则必须保留。用户界面中输入的大写 ASCII 字母必须转换为小写。允许的 ASCII 集合包括小写字母、数字、连字符、句点和冒号;空白字符不允许出现。一个容易忽略的例子是 U+3002 表意句号:RFC 3722 禁止它,即使某些域名输入系统会把它当成 ASCII 句点 U+002E。换言之,iSCSI 名称不会自动继承别的应用所做的替换。
这并不是把“所有 Unicode 清理干净”。输出只是依据明确指定的字符范围和表格得到的规范表示。UTF-8 编码由另一份规范定义;iSCSI 名称自身的语法和命名权威规则也要另行核验。RFC 3721 讨论名称与发现机制的整体关系,RFC 3722 规定字符串如何准备。名称通过准备流程,并不能证明访问已获授权、某组织现在仍控制该名称,或目标可在某个地址到达。
最容易被忽略的限制,是 RFC 3722 不会合并视觉上相似的字符。拉丁字母与形状相近的希腊或西里尔字母,不会因为读者看错就变成相同的值。安全章节指出,操作人员或系统采用不一致解释时,发起端可能访问了非预期目标,也可能无法访问本来要访问的目标。这是对一种潜在失效方式的分析,不是已发生攻击的证据。
因此,Stringprep 能让规范定义的变体汇聚到同一表示,拒绝协议禁止的输出,并检查混合方向文本;但它不能裁定谁控制命名权威、界面上显示的标签是否可信,也不能替人判断一个具有迷惑性的字符串是否应被接受。这些问题需要 profile 之外的控制措施。
RFC 3491 的 Nameprep 与此相关,因为它也是 Stringprep profile,但适用于国际化域名,并非 iSCSI profile。RFC 3454 提供框架,RFC 3722 则为自己的协议用途挑选规则。RFC 7143 后来整合了 iSCSI 协议文本,但这不会把 RFC 3722 的 Unicode 3.2 基线变成适用于所有新标识符系统的当代建议。
这项标准选择以可复现性换取解释自由度。实现者得到一份明确配方,运维人员也可以追查两次输入为何相等、为何被拒绝。但可复现的比较仍取决于实际送入的字符串,也无法解决视觉欺骗。它留下的历史教训并非“Unicode 已经适合存储名称”,而是协议必须明说:哪些差异会被抹去、哪些会被拒绝、哪些必须交给人和周边控制来处理。
来源
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance