
摘要
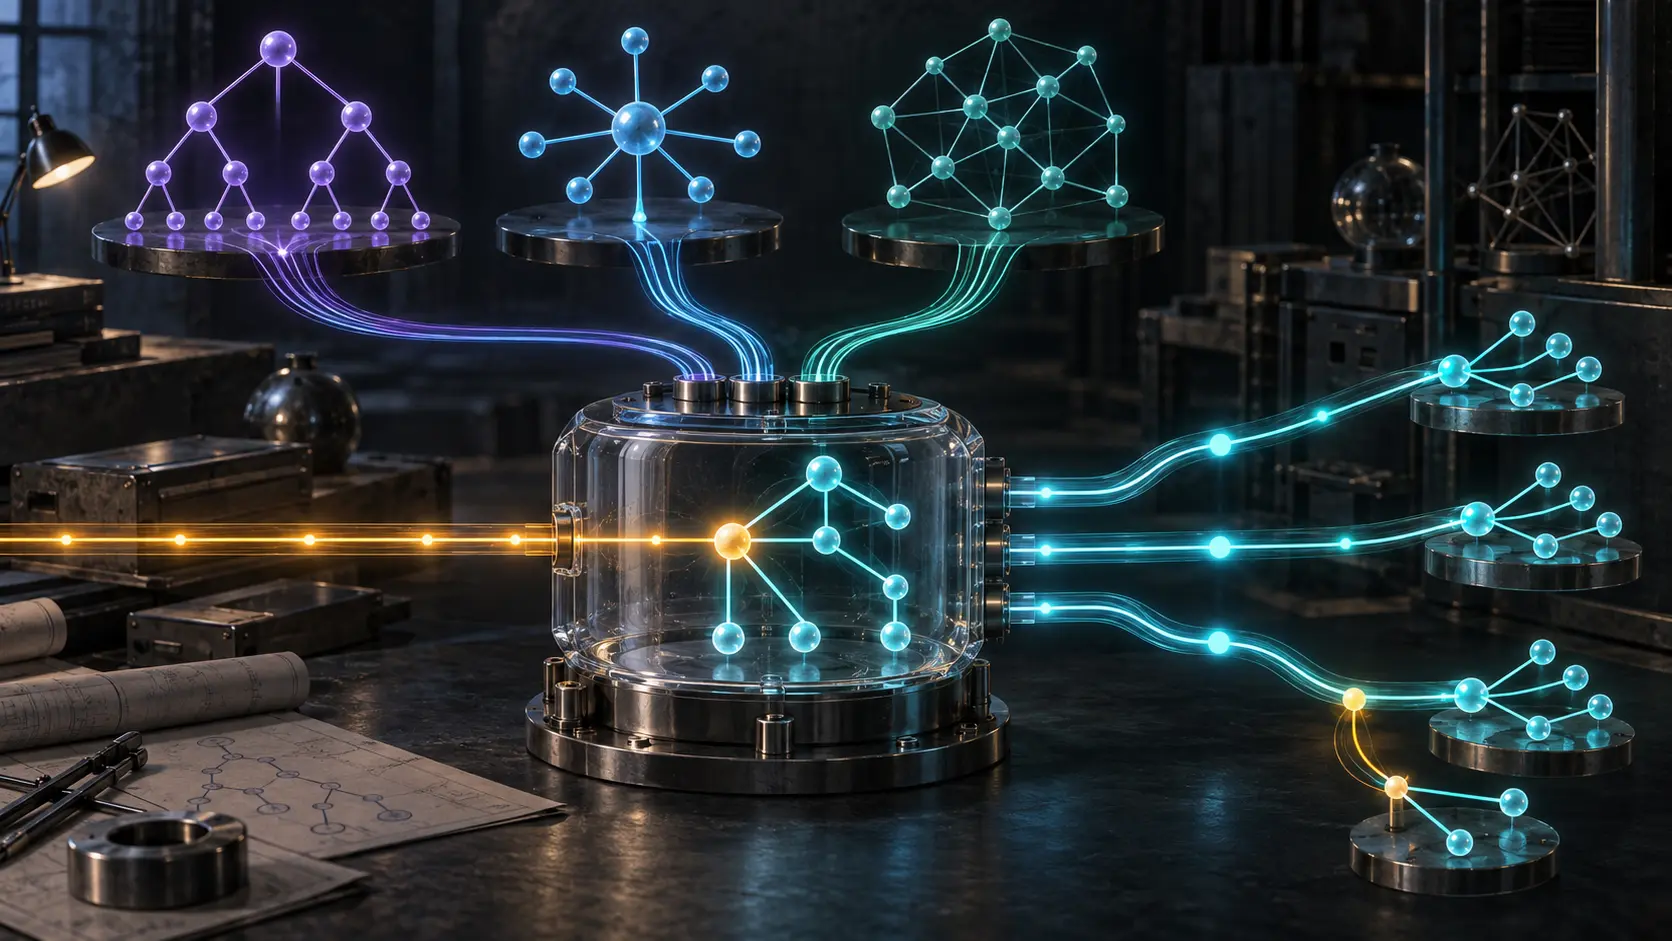
- 动态成员、状态创建者和树优化目标都有多种合理选择,RFC 2102 因此把组播路由生成与包转发机制一起留在 Nimrod core 之外。
- 不同实现仍可在同一棵交付树上合作,条件是它们对已安装状态的结构与转发含义达成一致。
- child list 中多出一个邻接,只能证明一个本地复制动作;它不证明成员、授权、完整覆盖、最短路径、资源预留或最终交付。
想象两个路由器收到同一个组播流。它们不必知道上游用的是同一种算法,也不必赞成那种算法的成本函数。真正不能含糊的是下一步:看到同一个 flow-id、parent、child 和 target 时,它们必须执行相同的复制含义。
这正是 RFC 2102 的重心。单播与组播都有“生成路由”和“转发数据”两个阶段。Nimrod 对单播规定若干转发模式,却把路由生成留给 routing agent;到了组播,连转发机制也不被写死。原因不是设计尚未完成这么简单,而是问题本身允许多组正当答案。
成员会加入和离开,交付树必须增长或剪枝。状态可以由发送者创建,可以由接收者发起,也可以由中间路由器从分布式信息中产生。树的优化目标也彼此冲突:总成本低的树可能让某些接收者承受较大时延;每个目的地的最短路径集合又可能消耗更多链路和状态。
五种方法,五种权力分配
DVMRP 用反向路径转发形成以源为根的树,逻辑简单,却可能把状态和控制工作扩散到许多节点。CBT 围绕 core 建立接收者发起的共享树,降低每源状态,但路径会绕行,core 的位置也变成关键。PIM 允许共享树与 source-specific tree 并存,并能在两者间切换。MOSPF 把链路状态与组成员信息分发给路由器,由各节点计算最短路径树。IDPR 则让发送端生成 policy route,再通过 path setup 把复制状态装进中间实体。
这些方法的差异不是“同一树算法的不同参数”。它们决定谁掌握组信息、谁计算、谁发起安装,以及谁承担动态成员带来的更新成本。
共同层收缩到可执行关系
RFC 2102 仍必须回答互操作问题。文档提出的共同层不是统一计算过程,而是统一 forwarding information 的结构。交付树最终由路由器内的转发信息定义,不由创建它的机制定义。只要状态可以被一致解释,多种实现就能共存。
Nimpim 示例把这句话写成动作。Join 到达已有 flow 时,路由器把前一节点加入 child list;若 flow 尚不存在,就安装 parent、child 与 target,再把请求送向 parent。Prune 删除一个 child,只有 child list 为空才删除 flow。数据包携带 flow-id,forwarding agent 按已安装状态复制。
于是,同一行状态可以有不同来历:发送者先建立主树,接收者随后在发送者不知情时把新分支接到树上的某个节点;共享树也可以在流量出现后切换成源根树。RFC 2102 明确允许多种方法同时存在,并随组分布改变而切换。
一条分支没有说出的事实
child entry 并不是成员名册。RFC 1112 所代表的 IGMP 层只在直连网络上表达接收兴趣,并带有自己的计时和汇聚规则。转发状态是这一证据链的下游结果,不能倒过来替代成员证据。
它也不是政策许可。RFC 2102 指出,目的地特定的 transit 限制甚至可能迫使同一个组使用多棵树服务不相交的目的地集合。某条分支存在,不代表所有目的地都已覆盖,也不代表访问限制仍成立。
它更不是最优性证明。CBT 共享树可能绕过最短路;PIM 的反向最短路径要依赖度量对称。MOSPF 与 IDPR 用完全不同的计算得到类似的可执行行。状态形状相同,只说明执行接口相同。
资源与质量也在别处。RFC 2102 要求提供树资源是否可共享的信息给 reservation 使用,并要求每条源到目的地路径满足质量和访问约束。已安装分支本身没有证明时延、抖动、预留成功或安全共享。它当然也没有证明源已发送、链路已承载、末跳已复制、应用已收到。文档甚至明确没有讨论安全问题。
历史意义是一条边界
RFC 1992 已让 Nimrod 接受多层地图、不同抽象和多种转发模式;RFC 1753 又区分 user state 与 service state。RFC 2102 把同一思想推进到组播:只把跨实现必须共同理解的部分放进共同层,其余选择继续留给运行系统的参与者。
Lu Heng 后来用“最小初始规范”和“本地化未来决策”描述类似的设计纪律:共同层只容纳互操作所需的确定规则,后续选择靠运行代码采用,而不是靠文件宣布。这里是解释上的平行,不是历史因果。RFC 2102 是 Informational 文档,也不证明 Nimrod 或 Nimpim 部署。
它留下的结论比部署故事更耐用:算法可以不同,执行语义不能含糊;一条分支只证明一条分支,更大的结论必须逐层取证。
来源
会员简报
档案背景详情
使用相应会员等级登录,即可解锁完整简报与来源注释。
仅限 Strategic Circle
Strategic Circle
所有读者均可浏览。加入并登录后可解锁档案简报。
加入 Strategic Circle仅限 Leadership Alliance
Leadership Alliance
符合条件的 IP 资产所有者和管理层可登录查看 Leadership Alliance 简报。
加入 Leadership Alliance