要約
- RFC 2130は、抽象文字と番号を結ぶCCS、番号をオクテットにするCES、転送用に変換するTESを、言語・ロケール・文化・レイアウトから区別した。文字を復元しても表示や理解まで証明されない。
- MIMEの登録値、ISO 10646とUTF-8の推奨デフォルトは、既存方式や互換性を消し去る命令ではなかった。報告はInformationalであり、新しい通信プロトコルや普及実績の記録ではない。
コマンドと人への説明
メールのやり取りに失敗したとき、機械が読むSMTPのMAIL FROMと、利用者が読むエラー文は同じ「文字列」でも役目が違う。RFC 2130は、コマンドそのものに翻訳版を増やすことが既存の解析器を危険にさらすと警告した。一方、人に向けた説明は、適切に定義された拡張があれば言語に合わせられる。多言語化の可否は文字列一般ではなく、それを誰が解釈し、どの互換性を守るかで決まる。
IABが招いたワークショップは1996年2月29日から3月1日に開かれ、報告は1997年4月に出た。分類はInformationalで、インターネット標準を新設した文書ではない。メール、ディレクトリ、Webで「文字集合」という言葉が別々の仕組みを指していたため、まず共通の問い方を作る必要があった。単一の万能な文字集合を義務化する構想は、既存プロトコルと用途の多様性にも合わなかった。
回線側の三層と人間側の四層
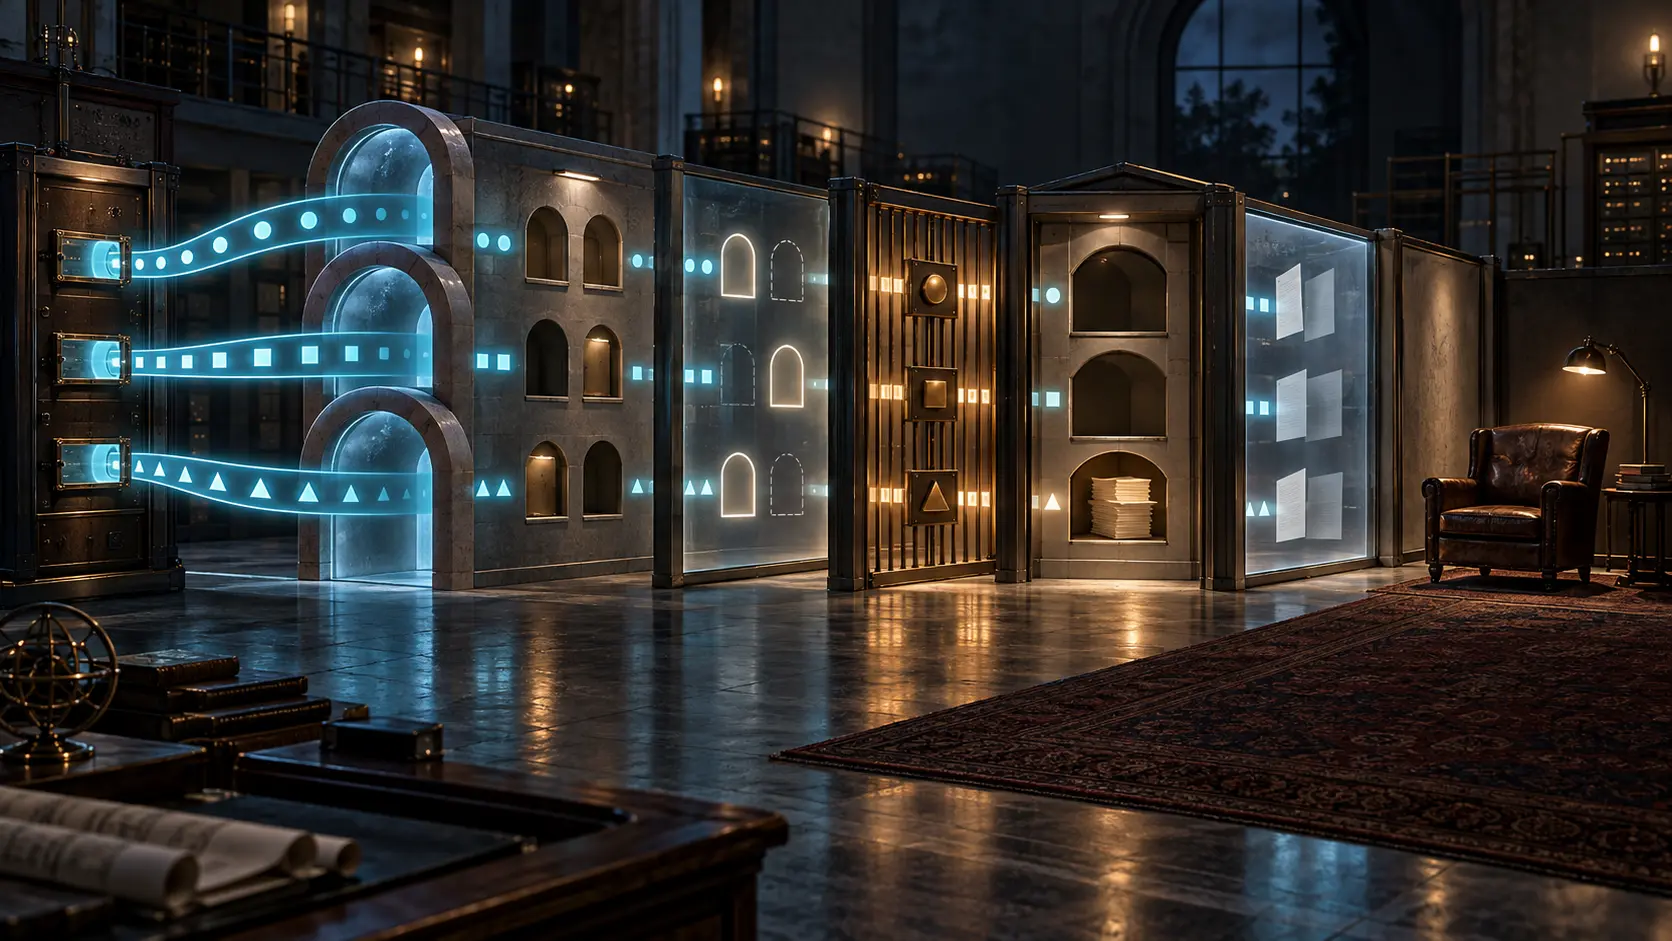
CCSは抽象文字に整数を割り当て、CESはその値をオクテットで表し、TESは転送路の条件に合わせて符号化済みデータを変換する。ISO 10646、UTF-8、Base64は、それぞれ異なる段階の例だ。転送の仕様には通常この三つが必要になる。MIMEのcharsetはCCSとCESをまとめて示す場合があり、Content-Transfer-Encodingは転送上の変換を示す。報告は、既存の登録名が概念上の境界を常に明瞭にしているわけではないとも認めた。
残る四層は言語、日付や通貨などのロケール、表記上の文化、字体や折り返しを含むレイアウトだ。報告が詳しく扱ったのは主に回線側で、表示問題の多くは対象外とした。ただし言語情報が漢字の字形選択や多言語文書の検索に役立つ場合も挙げている。正しいUTF-8を受け取った事実から、読者にふさわしい字形や書式、まして理解を推測してはならない。
符号化を当て推量に任せないことも重要だった。送信元の国だけを見て文字集合を推定する方法は信用できない。標準の規定、転送用の封筒に付いたラベル、データ内の印、事前の合意、通信開始時の交渉など、選択を知る経路は複数ある。既に信頼できる仕組みがないなら、MIMEの登録値で文字集合と言語を示すことが推奨された。ラベルが登録済みであっても、実際のバイト列と一致しているかは別の検証だ。
名前の範囲を見失わない
報告は、プロトコルの機構、識別子、データを別の課題として扱った。RFC 1958の考え方に沿い、広く見えるDNS名やテキスト形式のプロトコル要素には大文字小文字に依存しないASCIIを勧める。一方、私的なメールボックスのフォルダー名に同じ制限を機械的に課すのは不合理だ。従来ASCIIのみだった通信でUTF-8を使うなら、版や文字集合を交渉し、ASCII互換の退路を確保する必要がある。本文、データベース、HTMLのようなデータには複数方式と適切な文脈が欠かせない。
新しいテキスト系プロトコルへのISO 10646とUTF-8の推奨は、この条件を飛び越えない。後方互換性が必要なら古いデフォルトを保てるし、七ビットの経路には別の転送変換が要る場合がある。TESには共通のデフォルトさえ示していない。RFC 2044のUTF-8形式、RFC 2066のTelnet交渉、RFC 2070のHTML復号、RFC 2152の七ビットメールは、それぞれ狭い境界を扱う。RFC 2130はその境界を横断して、何がまだ未決定かを示した。
資料と限界
- RFC 2130本文、特に第0、2、3、8節。
- RFC Editorの書誌情報で日付と分類を確認。
- RFC 1958は、報告が引用する公開名の原則について参照。
Lu Hengの実際の運用と証拠を重んじる論考は、後年からの編集上の視角であり、ワークショップ著者の意図を立証する史料ではない。この報告から普及率や特定の利用者の読みやすさを導くこともできない。
会員向け解説
プロフィールの詳細
適切な会員レベルでログインすると、解説全文と出典メモをご覧いただけます。
Strategic Circle 限定
Strategic Circle
すべての読者に公開されています。参加してログインすると プロフィール解説 を閲覧できます。
Strategic Circle に参加Leadership Alliance 会員限定
Leadership Alliance
対象となる IP 資産の所有者・管理者向けです。ログインすると Leadership Alliance の解説を閲覧できます。
Leadership Alliance に参加