
Resumen
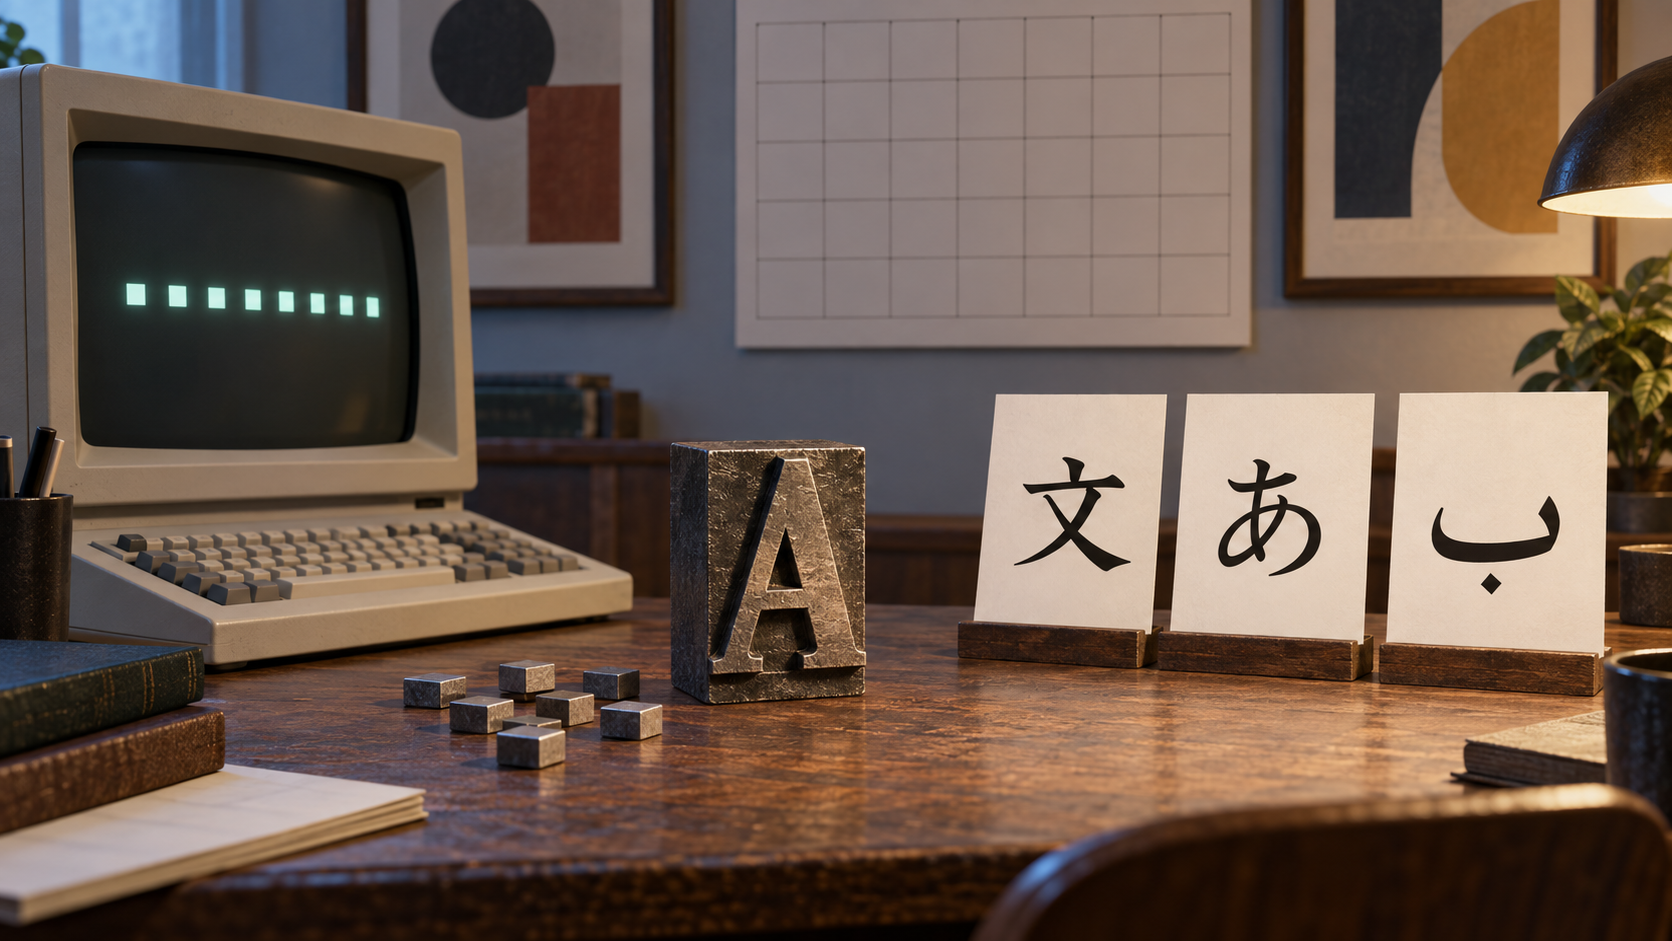
- El modelo de RFC 2130 separaba el conjunto de caracteres codificados (CCS), su representación en octetos (CES) y la transformación para el transporte (TES) del idioma, la configuración regional, la cultura y la disposición visual.
- Las etiquetas MIME registradas y los valores predeterminados ISO 10646/UTF-8 eran recomendaciones sujetas al contexto, a la negociación y a los sistemas existentes. El informe era informativo, no un protocolo nuevo ni una medición de adopción.
Una orden no es una explicación
Cuando falla una operación de correo, el servidor interpreta una orden y el usuario recibe una explicación. Es tentador llamar a ambas «texto». RFC 2130 advirtió que traducir una pieza de la maquinaria SMTP, como MAIL FROM, pondría en peligro la estabilidad de los analizadores; el mensaje destinado a una persona sí podía admitir otro idioma mediante una extensión bien definida. Esa diferencia entre quién debe leer cada cadena organiza el informe del taller patrocinado por el IAB, celebrado el 29 de febrero y el 1 de marzo de 1996 y publicado en abril de 1997.
Su categoría Informational importa. El texto ofrecía un marco y propuestas para los responsables de normas, no imponía una nueva regla de transmisión. Correo, directorios y páginas web habían desarrollado maneras distintas de tratar los juegos de caracteres. Para cooperar entre ellas no bastaba declarar que había llegado la era Unicode: había que decir qué elección quedaba fijada en cada etapa y cuál seguía abierta.
Tres pruebas del trayecto y cuatro del uso
Un CCS asigna números a caracteres abstractos. Un CES convierte esos valores en octetos. Un TES adapta los datos a un canal, por ejemplo cuando el transporte exige otra representación. ISO 10646, UTF-8 y Base64 permiten distinguir los tres papeles sin tratarlos como sinónimos. MIME podía declarar conjuntamente CCS y CES mediante charset y describir la transformación con Content-Transfer-Encoding. El taller observó que las etiquetas existentes no siempre reflejaban esa separación conceptual, por lo que pidió mayor claridad en el registro futuro.
La arquitectura tenía siete capas, pero las otras cuatro miraban hacia la persona: idioma, configuración regional para fechas o moneda, preferencias culturales y disposición con tipografía y saltos de línea. El informe se centraba en la transmisión; no resolvía todas las cuestiones de interfaz. Incluso un texto Han decodificado podía requerir información del idioma para elegir glifos de calidad. Una secuencia UTF-8 válida, por sí sola, no identifica el idioma ni certifica que una página se muestre o se entienda como se pretendía.
Las etiquetas registradas eran una respuesta a la incertidumbre. Adivinar la codificación porque el remitente procedía de cierto país figuraba entre los métodos examinados, pero era poco fiable. Una norma podía fijar una elección, el envoltorio podía declararla, la secuencia podía señalarla o las partes podían acordarla antes o durante la comunicación. El taller prefería los valores MIME registrados para caracteres e idiomas, salvo que otro mecanismo existente ya identificara esa información sin recurrir a conjeturas. La etiqueta no sustituye la comprobación de que los bytes enviados correspondan a ella.
El alcance de cada nombre
El informe dividía los problemas en maquinaria del protocolo, identificadores y datos. Remitía a RFC 1958 para la recomendación de conservar en ASCII independiente de mayúsculas los nombres públicos muy visibles, como los de DNS y elementos textuales del protocolo. No imponía la misma exigencia a un nombre privado de carpeta de correo. Para mejorar un protocolo que hasta entonces usaba ASCII, recomendaba negociar la versión o el juego antes de emplear UTF-8 y disponer de una representación compatible de respaldo. Los datos de mensajes, bases y HTML necesitaban soporte de varios juegos y contexto de aplicación.
El valor predeterminado ISO 10646 para CCS y UTF-8 para CES orientaba el diseño de protocolos nuevos. La compatibilidad podía exigir mantener el valor histórico, y un transporte limitado a siete bits planteaba su propia transformación; no había un TES predeterminado universal. El taller no descartaba otros conjuntos de caracteres. Por eso RFC 2044, RFC 2066, RFC 2070 y RFC 2152 cuentan historias vecinas —formato UTF-8, negociación Telnet, decodificación HTML y correo de siete bits— sin absorber la pregunta transversal de RFC 2130.
Fuentes y límites
- RFC 2130, informe del taller IAB, apartados 0, 2, 3 y 8.
- Registro del RFC Editor para fecha y categoría.
- RFC 1958, citado por el informe sobre nombres públicos.
Las notas de Lu Heng sobre la evidencia de la realidad y el código operativo se usan como perspectiva editorial posterior, no como prueba de la intención histórica del taller. Ninguna de estas fuentes demuestra despliegue general ni que un usuario concreto recibiera una presentación adecuada.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance