
Résumé
- Le RFC 3722 prescrit un enchaînement de mappage Unicode, de normalisation NFKC et de contrôles de caractères interdits afin que les implémentations iSCSI puissent comparer les octets UTF-8 préparés.
- Cette règle répond à la transcription humaine et aux contraintes d’implémentation, pas à l’usurpation : les caractères qui se ressemblent restent distincts, et le profil est ancré dans Unicode 3.2.
Dans une console de stockage, deux noms peuvent paraître équivalents et désigner pourtant des chaînes différentes pour la cible. L’écart devient décisif lorsqu’un administrateur recopie un nom depuis une étiquette ou une procédure, tandis qu’un initiateur compact doit déterminer si les octets reçus correspondent à la cible configurée. Publié en avril 2004, le RFC 3722 traite précisément de cette frontière pour les noms de l’Internet Small Computer Systems Interface (iSCSI).
Deux attentes s’opposaient. Pour la personne qui saisit un nom internationalisé, une gestion prévisible des variantes et de la casse facilite la transcription. Pour un équipement simple ou embarqué, une règle exacte est préférable : préparer la chaîne, l’encoder en UTF-8, puis comparer les octets. Si chaque implémentation choisit ses propres équivalences, un même nom apparent peut produire des valeurs différentes. Si l’on exige au contraire une comparaison linguistique souple, le protocole devient plus complexe et moins déterministe.
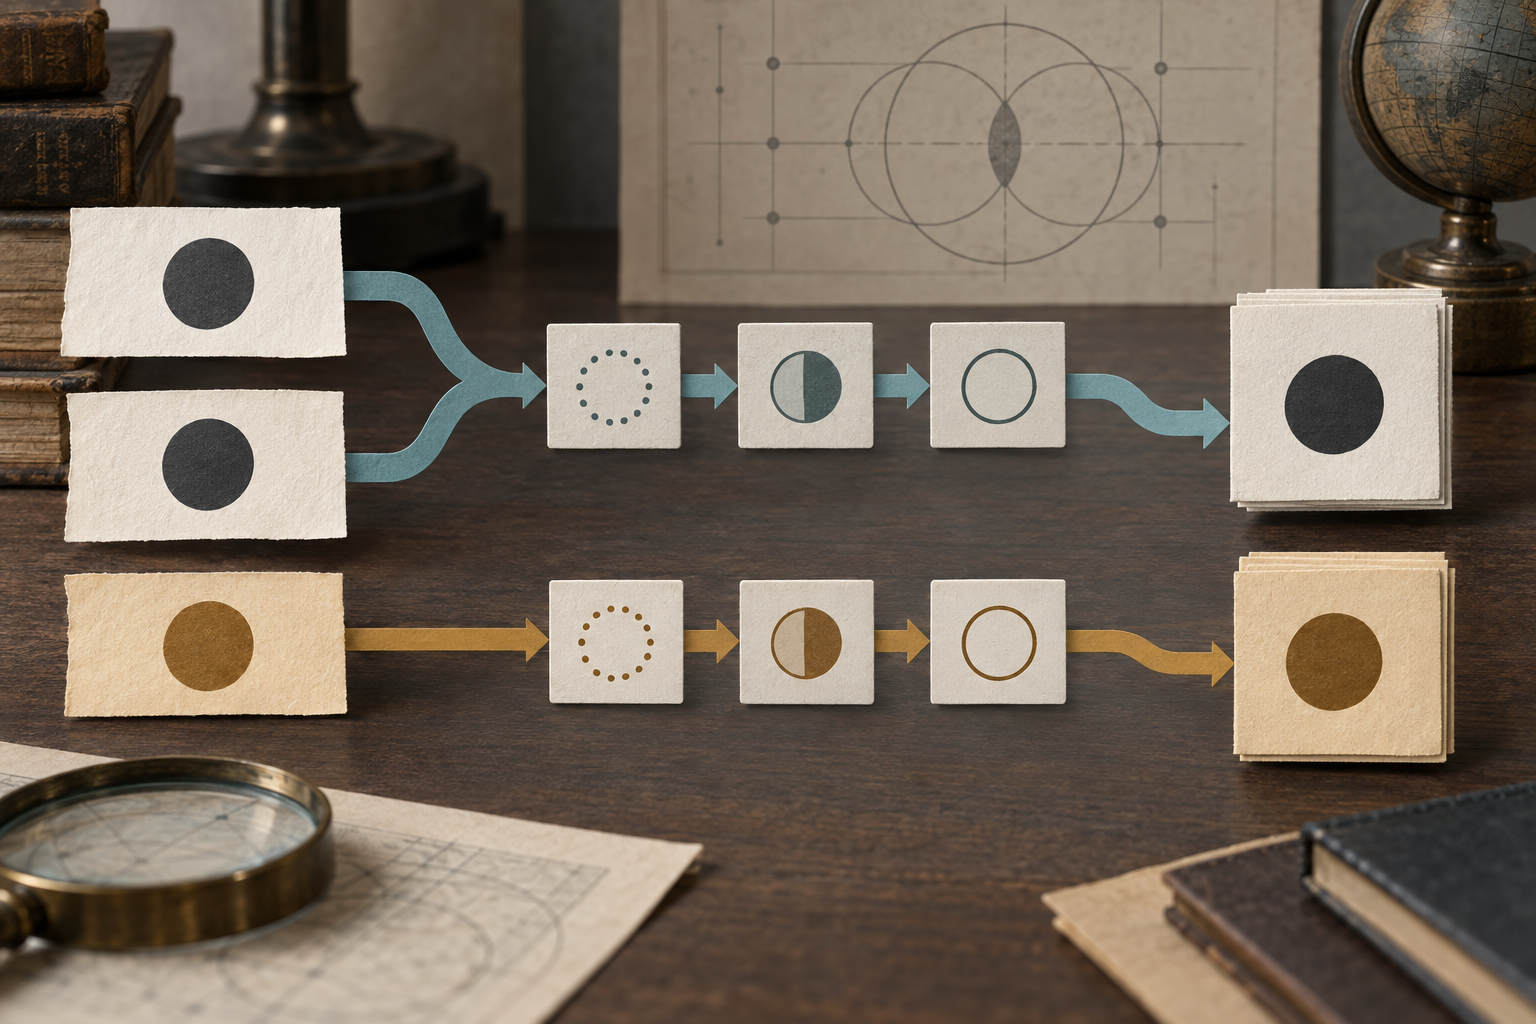
Le RFC ne propose donc pas un nettoyage au cas par cas, mais un profil. Il fixe le répertoire Unicode 3.2, applique les mappages Stringprep des tables B.1 et B.2, puis la normalisation NFKC. Il vérifie ensuite les sorties interdites des tables C.1.1 à C.9 et applique les contrôles bidirectionnels. Cette séquence évite que l’implémentation invente, après coup, une règle d’équivalence qui lui conviendrait.
Certaines différences disparaissent, d’autres non. Les lettres ASCII majuscules saisies dans une interface DOIVENT être converties en minuscules. Les caractères ASCII admis comprennent les minuscules, les chiffres, le trait d’union, le point et les deux-points ; les espaces sont exclus. Le point idéographique U+3002 est interdit, même si certains systèmes de saisie de noms de domaine le traitent comme équivalent du point ASCII U+002E. Le profil n’hérite donc pas automatiquement des substitutions d’une autre application.
Il ne s’agit pas de rendre « tout Unicode propre ». Le résultat est une représentation préparée selon un répertoire et des tables explicitement datés. UTF-8 relève d’une spécification distincte ; la grammaire complète des noms iSCSI et les règles d’autorité de nommage restent également à vérifier. Le RFC 3721 expose le contexte des noms et de la découverte ; le RFC 3722 traite de la préparation des chaînes. Une préparation réussie ne prouve ni l’autorisation d’accès, ni le contrôle actuel du nom par une organisation, ni l’adresse de la cible.
La limite la plus importante est parfois oubliée : RFC 3722 ne fusionne pas les caractères d’apparence similaire. Une lettre latine, son sosie grec ou cyrillique, ou deux glyphes rapprochés par une police, ne deviennent pas égaux parce qu’un lecteur les confond. La section de sécurité avertit qu’une interprétation incohérente peut conduire l’initiateur vers une autre cible que celle attendue, ou l’empêcher d’atteindre la bonne. C’est l’analyse d’un mode de défaillance possible, pas le récit d’une attaque observée.
La préparation peut faire converger des variantes définies, rejeter des caractères prohibés et appliquer des contraintes aux textes bidirectionnels. Elle ne détermine pas qui contrôle l’autorité de nommage, si une étiquette affichée est fiable, ni si une chaîne trompeuse doit convaincre une personne. Ces décisions nécessitent des contrôles extérieurs au profil.
Nameprep, défini par RFC 3491, est apparenté parce qu’il s’agit lui aussi d’un profil Stringprep, mais destiné aux noms de domaine internationalisés. Ce n’est pas le profil iSCSI. RFC 3454 fournit le cadre général ; RFC 3722 sélectionne ses propres règles pour les noms iSCSI. La consolidation ultérieure du protocole dans RFC 7143 ne transforme pas la base Unicode 3.2 en recommandation actuelle pour tout système d’identifiants.
Le compromis historique est donc celui de la reproductibilité contre la liberté d’interprétation. Les implémenteurs reçoivent une recette déterminée ; les opérateurs peuvent expliquer pourquoi deux entrées sont égales ou pourquoi l’une est rejetée. Mais une comparaison reproductible ne vaut que pour la chaîne présentée, et ne résout pas la tromperie par ressemblance visuelle. L’enseignement durable n’est pas qu’Unicode serait devenu sûr pour le stockage : c’est qu’un protocole doit préciser les différences qu’il efface, celles qu’il rejette et celles qu’il laisse aux personnes et aux contrôles environnants.
Sources
- RFC 3722 — profil de chaîne des noms iSCSI
- RFC Editor — fiche RFC 3722
- Errata du RFC 3722
- RFC 3721 — nommage et découverte iSCSI
- RFC 3720 — protocole iSCSI
- RFC 3454 — cadre Stringprep
- RFC 3491 — profil Nameprep
- RFC 3629 — UTF-8
- RFC 7143 — protocole iSCSI consolidé
- RFC 2396 — syntaxe générique des URI
- RFC 2732 — adresses IPv6 littérales dans les URL
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance