
Résumé
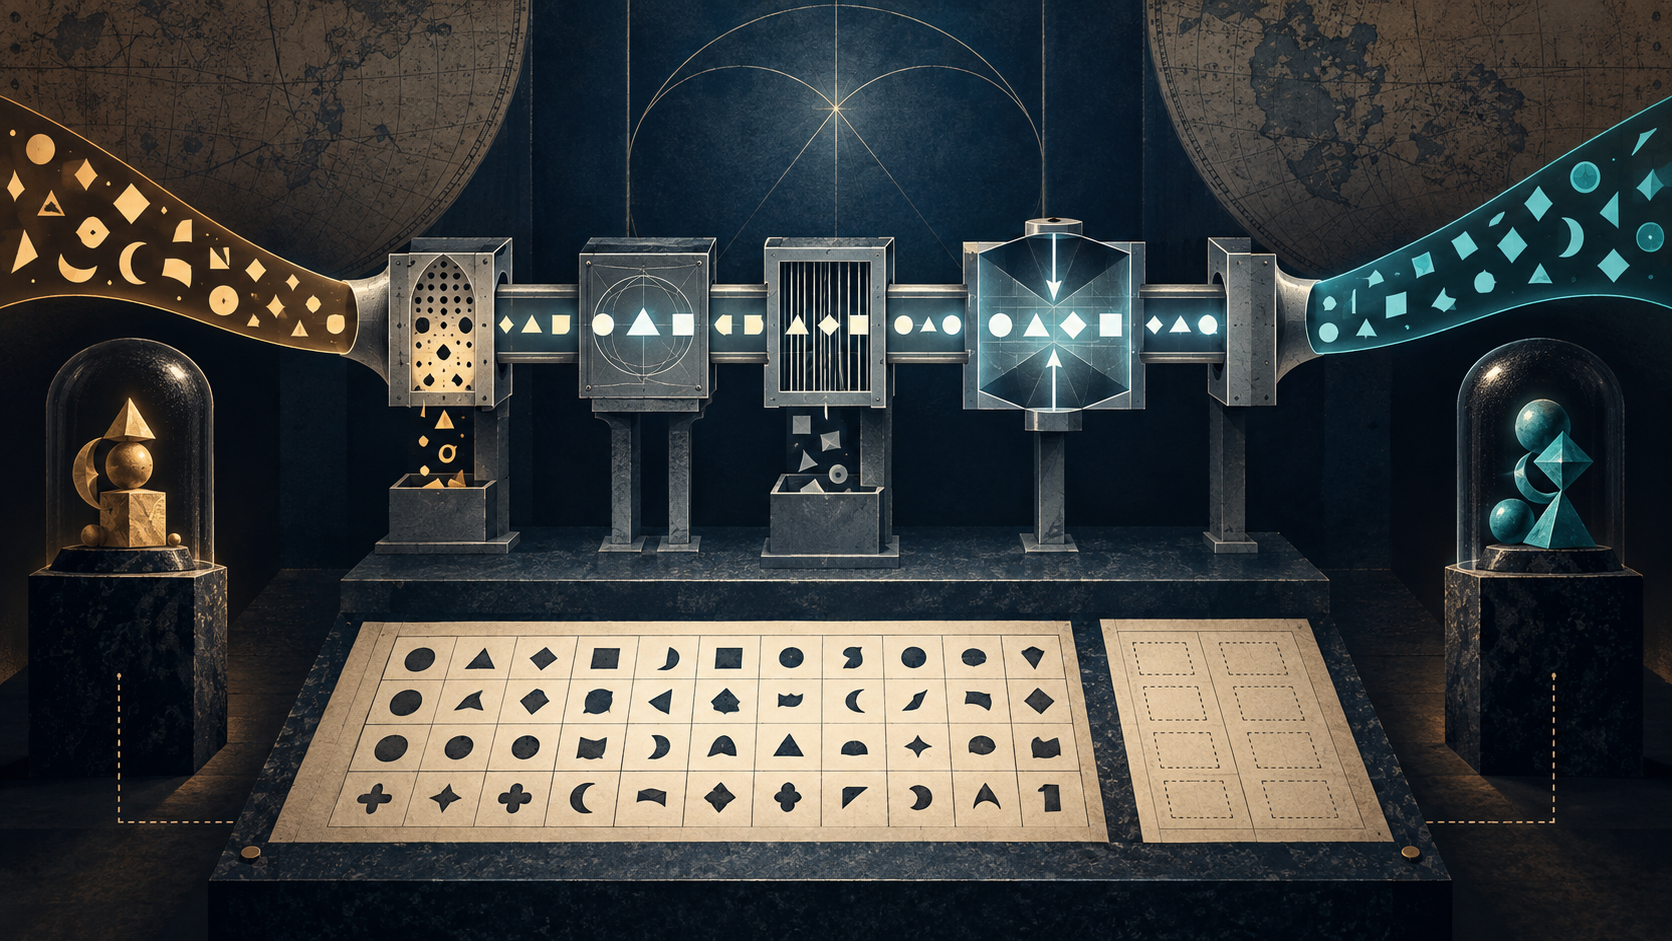
- RFC 3454 imposait l’ordre mapper, normaliser, interdire, puis vérifier les caractères bidirectionnels ; le protocole utilisateur devait encore choisir un profil complet.
- Une sortie identique prouvait une égalité dans ce profil et cette version Unicode, non une orthographe universelle, une apparence, une intention, un contrôle de compte ou une identité humaine.
Comparer ne voulait pas encore dire identifier
Unicode permettait enfin aux protocoles de transporter bien davantage que l’ASCII, mais plusieurs suites de points de code pouvaient représenter un texte perçu comme identique. Casse, caractères de compatibilité, marques invisibles et compositions différentes rendaient une comparaison brute fragile. Publié en décembre 2002, RFC 3454 proposa stringprep pour préparer une chaîne avant son stockage ou sa comparaison.
Le but était volontairement probabiliste : augmenter les chances que deux utilisateurs saisissant ce qu’ils croyaient être la même chaîne obtiennent une sortie identique caractère par caractère. Le document reconnaissait qu’aucun profil ne pouvait absorber toutes les variantes orthographiques de toutes les langues. Le texte brut, la notice RFC Editor, le dossier Datatracker, son historique, ses références, ses citations ultérieures et les errata établissent la norme. Ils ne révèlent pas l’intention du clavier ni le détenteur du compte obtenu.
Le profil détenait la politique
Stringprep n’était pas autonome. Chaque protocole devait nommer un profil précisant l’usage, le répertoire, les tables de mappage, la normalisation, les sorties interdites, le contrôle bidirectionnel et les exclusions supplémentaires. Deux profils pouvaient donc traiter légitimement la même entrée de façons différentes.
Le mappage pouvait supprimer un caractère, en remplacer un ou en produire plusieurs. Sa sortie n’était pas relue au cours de la même étape. Si un profil choisissait la normalisation, RFC 3454 exigeait NFKC, décrite dans l’annexe Unicode no 15. Davantage de formes convergeaient ainsi, sans devenir forcément visuellement identiques dans toutes les polices ni sémantiquement équivalentes dans toutes les langues.
L’ordre des opérations faisait partie de la preuve
Mapper, normaliser, interdire, vérifier bidi : cet ordre était obligatoire. Le modifier pouvait changer le résultat. Un caractère supprimé au début ne pouvait plus être rejeté ensuite ; une normalisation pouvait au contraire produire une séquence que l’étape d’interdiction devait refuser.
Le contrôle d’interdiction rendait soit une chaîne, soit une erreur, jamais les deux. Contrôles, usage privé, non-caractères, substituts et caractères de balisage pouvaient être exclus. Les règles bidi encadraient les chaînes comportant une écriture de droite à gauche afin de stabiliser leurs extrémités. Elles ne vérifiaient pas l’identité de l’auteur. Le rapport Unicode no 36 a ensuite développé le risque des caractères visuellement confondables : une normalisation correcte ne supprime ni tous les sosies ni l’écart entre ressemblance et propriété.
La version Unicode appartenait au reçu
RFC 3454 figeait ses tables à Unicode 3.2 et refusait leur application automatique aux versions futures. Ce choix rendait un calcul reproductible, mais obligeait à accompagner tout résultat du profil et de la version utilisés.
Les points de code non attribués montraient pourquoi. Une chaîne stockée ne devait pas en contenir, car une attribution future pouvait modifier son traitement. Une requête pouvait les tolérer afin qu’un client récent interroge une base plus ancienne. La même entrée pouvait donc échouer lors d’une création et passer lors d’une recherche. L’opération faisait partie du verdict.
Un journal qui ne conserve que la sortie finale détruit l’entrée, la version, les transformations et la distinction stockage-requête. Après une mise à jour, il devient impossible de savoir si l’utilisateur a changé de nom ou si la table a changé sous lui.
Nameprep a montré l’utilité et la dette
RFC 3491 fit de Nameprep un profil pour l’IDNA d’origine, intégré par RFC 3490. La revue RFC 4690 documenta ensuite les difficultés, tandis que le vocabulaire IDNA2008 de RFC 5890 abandonna stringprep.
La comparaison restait nécessaire ; c’est son cadre figé qui vieillissait. RFC 6885 formula le problème PRECIS, RFC 7564 remplaça RFC 3454, puis RFC 8264 remplaça ce premier cadre. Cette succession prouve une réparation continue, non un changement instantané de la signification de tous les identifiants existants.
La discipline des couches de réalité de Heng Lu sépare l’entrée, le profil, les tables, chaque transformation, la sortie ou l’erreur, le résultat de comparaison, le rattachement au compte et l’autorisation. La primauté du code en fonctionnement permet au programme d’attester son calcul, pas de désigner un propriétaire. La spécification initiale minimale explique pourquoi le cadre générique laissait identité et pouvoir au protocole utilisateur. C’est une lecture éditoriale ultérieure.
RFC 3454 n’a donc pas rendu la normalisation faible. Il l’a rendue forte à l’intérieur d’une frontière nommée. Comparer de façon déterministe n’est toujours pas identifier.
Sources
- RFC 3454
- Texte RFC 3454
- Notice RFC Editor
- IETF Datatracker
- Historique
- Références
- Cité par
- Errata
- RFC 7564
- RFC 8264
- RFC 6885
- RFC 4690
- RFC 3490
- RFC 3491
- RFC 5890
- Annexe Unicode no 15
- Rapport Unicode no 36
- Heng Lu — couches de réalité
- Heng Lu — primauté du code
- Heng Lu — spécification initiale minimale
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance