
Résumé
- La RFC 3234 traite la panne d’un intermédiaire comme un problème architectural distinct : une autre route IP peut contourner un routeur en panne sans recréer l’état détenu par la boîte intermédiaire.
- Dans son catalogue indicatif de 22 types d’intermédiaires, les auteurs en classent 16 comme conservant un état dur et 21 comme exigeant le redémarrage de la session après panne.
La connectivité revient, pas nécessairement la conversation
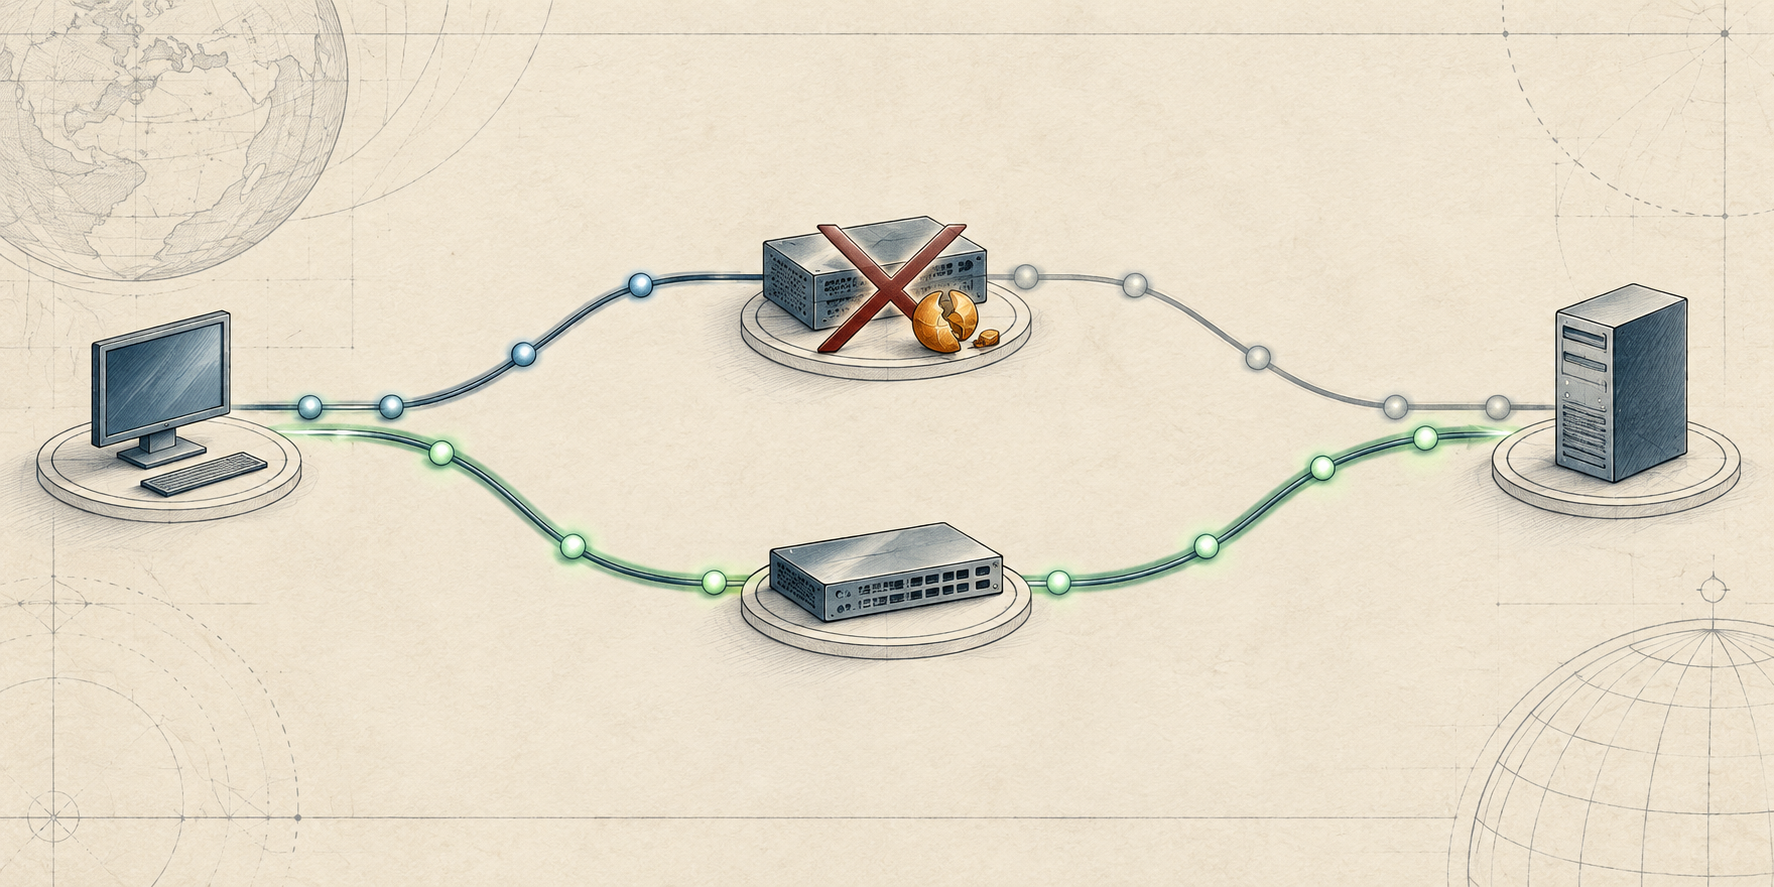
Le scénario classique de réparation commence par les routes. Un routeur tombe, le protocole de routage trouve un autre chemin et les paquets recommencent à circuler entre les extrémités. La session semble pouvoir continuer.
La RFC 3234, un mémo informatif de Brian Carpenter et Scott Brim, montre la limite de cette image. Elle appelle « middlebox » toute fonction sur le chemin qui dépasse le routage IP ordinaire, qu’elle soit un équipement séparé ou une fonction virtuelle intégrée ailleurs. Traduction d’adresses, filtrage, proxy ou autre service : ces fonctions ne sont pas l’extrémité de la session, mais elles peuvent être indispensables à son fonctionnement.
Une boîte qui termine un flux et en crée un autre change donc l’unité de panne. Le protocole de routage peut restaurer la joignabilité sans restaurer la correspondance d’adresses, la décision ou l’état de session que l’intermédiaire détenait. Le chemin fonctionne de nouveau ; la conversation existante, elle, peut rester bloquée.
La RFC distingue l’état souple, que l’on peut reconstruire pendant que la session continue éventuellement en mode dégradé, de l’état dur, dont la perte rend la fonction indisponible. Un cache illustre le premier cas : sa disparition devrait coûter de la performance, non interrompre l’application. Avec un état dur, un basculement rapide exige un serveur de secours déjà muni d’une copie. L’autre option est que les deux extrémités détectent la panne et relancent la session en passant par un équipement de rechange.
Ces stratégies répartissent différemment la responsabilité. L’état souple rend l’information reconstructible ; le basculement exige une copie à jour ; le redémarrage demande aux extrémités de reconnaître que l’ancienne session a disparu et d’en établir une nouvelle. « Avoir une redondance » ne précise donc ni qui possède l’état, ni comment le remplacement devient utilisable.
Un classement indicatif, pas une mesure du réseau
Les auteurs recensent 22 types de middlebox et en classent 16 comme conservant un état dur, 21 comme nécessitant un redémarrage de session. Ces nombres rendent leur inquiétude concrète, mais ils décrivent leur propre catalogue, qu’ils qualifient de subjectif et non définitif. Ce n’est ni un échantillon représentatif du réseau mondial, ni une mesure des pannes observées.
Leur recommandation est nette : chaque conception d’intermédiaire doit prévoir explicitement sa réponse à la panne. Ils avertissent aussi qu’aucune coordination entre couches ne peut être présumée. Une boîte de couche basse peut ignorer qu’un service de couche applicative est en panne, sans pouvoir déplacer la session vers le bon secours.
La RFC 8517, publiée bien plus tard, examine certains services de couche transport du point de vue des opérateurs et la visibilité des flux utile au diagnostic. Elle complète le contexte, mais ne prouve pas que les nombres de 2002 décrivent les déploiements actuels. La RFC 1958 fournit l’arrière-plan architectural ; la RFC 1812 décrit le rôle normal d’un routeur IPv4.
La leçon n’est pas que les intermédiaires seraient bons ou mauvais : la RFC 3234 écarte précisément cette opposition. C’est que rétablir une route et préserver une session sont deux affirmations différentes. Un test de joignabilité ne prouve pas que l’état a été restauré, répliqué ou remplacé par une nouvelle session cohérente.
Sources
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance