
Résumé
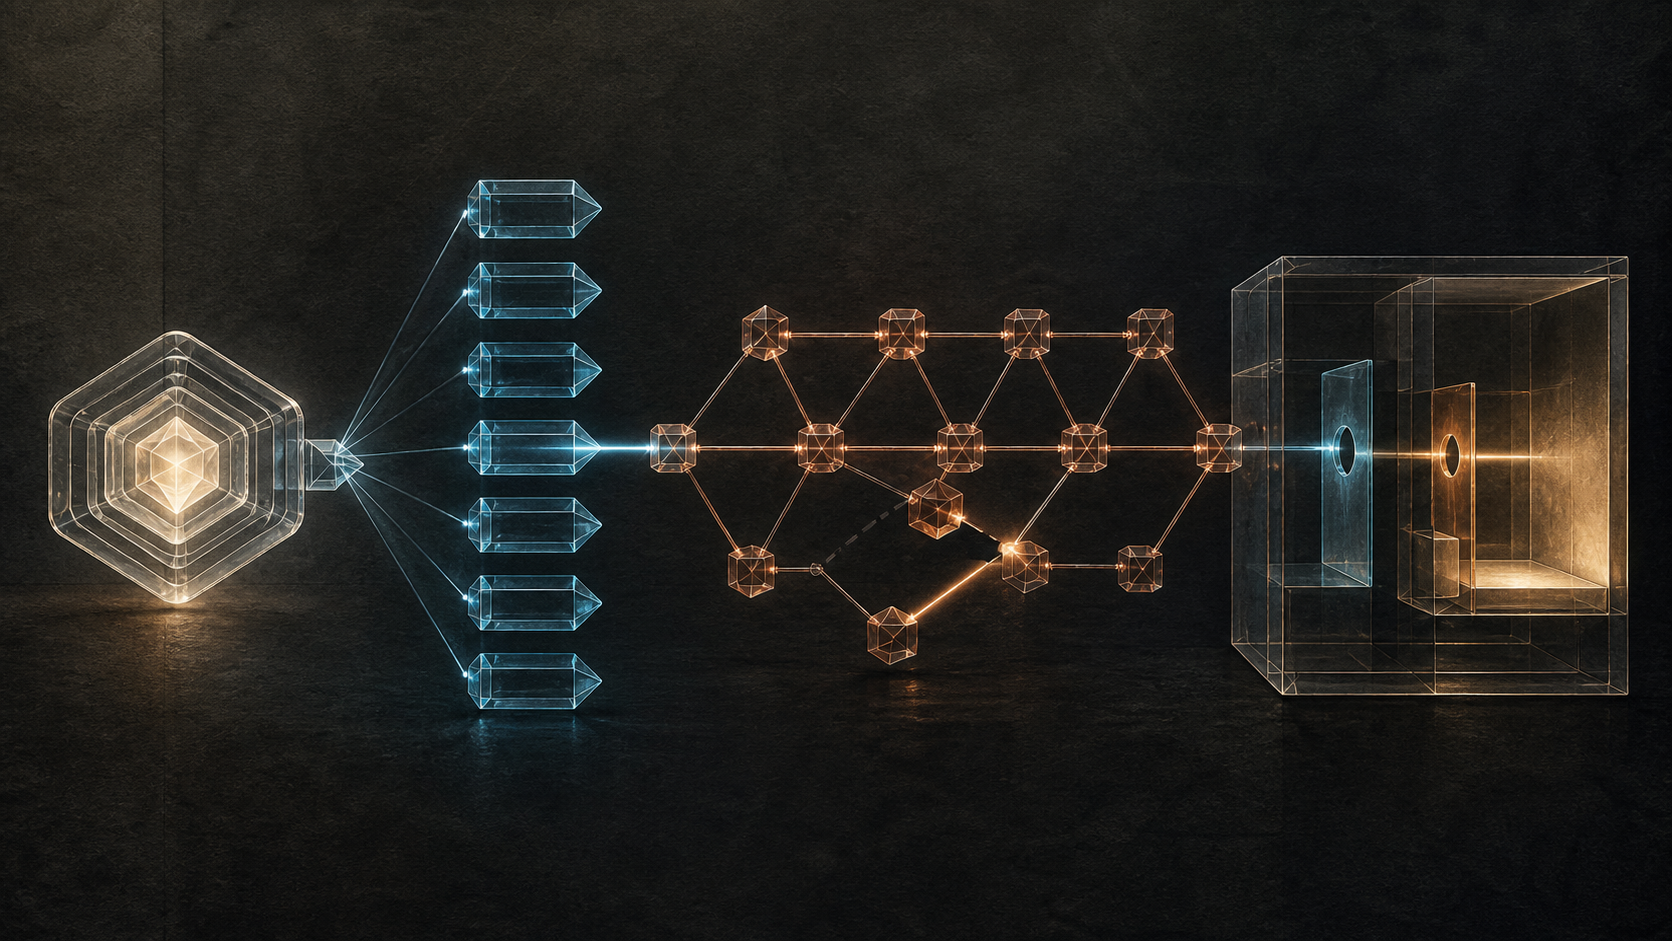
- RFC 814 organisait l’hôte Internet autour de traductions distinctes : le nom vers l’adresse, l’adresse vers la route, le nom de service vers le port propre au protocole de transport.
- La croissance rendait les tables exhaustives intenables. Clark proposait des serveurs de noms distribués, des caches proportionnés à l’usage et des interfaces remplaçables, tout en laissant la découverte initiale des passerelles au réseau local.
- Cette séparation limitait la portée de chaque preuve : une résolution n’était pas une route, une adresse ne désignait pas le processus final et un port enregistré n’authentifiait aucun trafic.
Une bonne adresse devenue fausse
Le cas le plus révélateur de RFC 814 n’était pas une panne de câble. Une copie locale de la table du NIC pouvait rester inchangée après le déplacement d’un hôte. L’adresse conservait une forme valide, IP acheminait correctement le paquet et une machine répondait. Pourtant, ce n’était plus celle que le nom devait désigner. Pour du courrier en attente, sans humain devant le terminal, l’erreur pouvait se prolonger sans signal clair.
David D. Clark en déduisait une architecture de références successives. Les chaînes lisibles nommaient réseaux, hôtes et services. Un nom d’hôte produisait une adresse Internet de 32 bits. Cette adresse décrivait un rattachement et permettait de choisir une route. Le nom d’un service produisait un identifiant de port dans TCP ou UDP. Chaque étape répondait à une question différente.
Dire que « la connexion a marché » efface cette différence. On peut joindre l’adresse tout en se trompant d’objet, atteindre l’hôte sans trouver le service, ouvrir le port sans authentifier le processus, puis obtenir une réponse sans accomplir l’opération attendue.
La totalité ne tenait plus dans chaque machine
L’Internet décrit en juillet 1982 comptait tout au plus environ 25 réseaux actifs et quelques centaines d’hôtes. Clark demandait déjà de concevoir pour un ordre de grandeur bien supérieur. Une estimation de travail envisageait 1 000 réseaux et 25 000 hôtes.
Copier toutes les correspondances partout ne pouvait durer. La table devenait trop grande, changeait trop vite et contenait surtout des noms qu’un hôte donné n’utiliserait jamais. La réponse prévue était distribuée : chaque réseau ou groupe maintiendrait ses noms, un serveur répondrait aux demandes et l’hôte ne conserverait que les résultats récemment utiles.
Le conseil le plus moderne concernait le code existant. La table devait être accessible par une sous-routine unique, non par des références dispersées. Le jour où le serveur de noms deviendrait disponible, on remplacerait l’implémentation derrière cette interface. Les applications continueraient à poser la même question sans connaître l’emplacement du registre.
La couche commune restait donc mince. Elle standardisait l’appel nécessaire à l’interopérabilité et laissait évoluer la méthode de réponse. C’est cette possibilité de remplacement, plus que la taille d’une table, qui empêchait l’ancien mécanisme de devenir une dépendance irréversible.
Le cache avait une date, pas une souveraineté
La distribution créait son propre risque. Un cache accélère la résolution, mais il retient une affirmation après que sa source a pu changer. RFC 814 voyait précisément le problème du nom déplacé et évoquait une vérification inverse auprès de l’adresse étrangère. Cette piste ne constituait ni signature ni preuve générale d’identité ; elle montrait que l’origine et l’âge de la correspondance comptaient.
RFC 1034 a plus tard donné une forme de production à cette séparation. DNS associait à un nom des données typées, distribuait la responsabilité entre zones et donnait au producteur des données le contrôle des compromis de rafraîchissement. Surtout, le nom n’avait pas à incorporer un identifiant de réseau, une adresse ou une route.
Un nom pouvait ainsi garder son orthographe pendant qu’une adresse changeait. Rien n’assurait cependant qu’il resterait délégué au même acteur, que la réponse serait authentique ou que l’adresse serait joignable. La séparation rend la continuité possible ; elle n’accorde pas au nom une vérité absolue.
L’adresse lançait une nouvelle décision
Une fois l’adresse obtenue, IP devait encore choisir le prochain saut. Si le réseau destinataire était directement attaché, l’envoi pouvait être direct. Sinon, il fallait une passerelle. Les anciennes tables statiques de 256 réseaux devenaient fragiles dès que les réseaux, les passerelles ou le format d’adressage évoluaient.
RFC 814 recommandait un cache de routes limité aux destinations actives. Faute d’entrée, l’hôte pouvait essayer une passerelle accessible. Un message ICMP Redirect pouvait indiquer un meilleur choix et modifier le cache. La route était un état opérationnel susceptible de changer sans que le nom ni même l’adresse changent.
La découverte de la première passerelle restait volontairement locale. Certains réseaux pouvaient diffuser une requête, d’autres offrir un mécanisme particulier, d’autres encore dépendre d’une configuration manuelle. L’architecture d’interconnexion ne transformait pas une capacité locale en obligation universelle.
RFC 1122 a ensuite conservé cette frontière en plaçant la complexité du routage dans les passerelles et en cherchant à isoler les logiciels hôtes des évolutions du routage. Un cache pouvait aussi porter la MTU ou le délai d’un chemin. Ces propriétés appartenaient à ce chemin observé, non au nom humain de la destination.
Le port restait au-dessus d’IP
L’adresse mène à l’hôte, mais les données visent un agent à l’intérieur de cet hôte. IP remet le datagramme au protocole supérieur ; TCP ou UDP termine la distribution à l’aide d’un port. RFC 814 refusait d’inscrire ce dispatch applicatif dans le cœur IP.
Les raisons étaient structurelles. Un futur protocole pouvait vouloir une autre taille d’identifiant. Les ports bien connus avaient un sens propre à chaque protocole. Et IP devait contenir les fonctions que les passerelles avaient besoin de comprendre. Imposer les ports à IP aurait laissé croire que toute passerelle devait connaître les services.
Clark examinait aussi un serveur de rendez-vous : le client enverrait une description textuelle du service, puis recevrait un port choisi pour cette instance. Cela convenait à un établissement de circuit. Pour un échange UDP d’un seul datagramme, le détour et le champ supplémentaire annulaient une grande partie de la simplicité recherchée. La décision devait donc rester dans le protocole supérieur.
Le registre actuel de l’IANA maintient cette distinction. Il relie noms de service, protocoles de transport et numéros de port. Il précise aussi qu’une attribution ne constitue pas une approbation et que le trafic observé sur un port enregistré n’est pas nécessairement le service annoncé.
Trente-deux bits pour livrer sans rendez-vous préalable
Un réseau à circuits virtuels peut transmettre une adresse longue lors de l’établissement, puis utiliser un identifiant court. Le datagramme Internet devait être acheminable sans phase préalable ; l’adresse devait donc voyager dans chaque paquet. RFC 814 présentait les 32 bits comme un compromis entre portée et taille d’en-tête, déjà difficile à étendre à tous les lieux imaginables.
Ce constat ne prédit pas CIDR, NAT, IPv6 ni les marchés contemporains. Il montre seulement que l’adresse est une coordonnée de livraison sous contrainte. L’inscrire dans l’identité aurait fait dépendre la référence humaine de chaque limite et de chaque déplacement de cette coordonnée.
La bonne preuve est une chaîne, pas un voyant
Une exploitation vérifiable conserve cinq éléments séparés : le nom demandé et la source de sa réponse ; les adresses et leur durée ; la route, l’interface et le prochain saut ; le protocole et ses ports ; enfin l’authentification, l’autorisation et le résultat applicatif.
Cette provenance permet d’expliquer les pannes. Le nom peut se résoudre sans route. La route peut atteindre un hôte qui n’expose plus le service. Le port peut être ouvert par un autre programme. Le bon programme peut refuser l’identité ou échouer après l’autorisation.
L’apport historique de RFC 814 est cette discipline : le nom n’était pas l’adresse, l’adresse n’était pas la route et la route n’était pas le service. Chaque traduction pouvait évoluer, être mise en cache et échouer selon ses propres règles. L’Internet restait adaptable parce qu’aucune coordonnée n’obtenait le droit de se faire passer pour tout le reste.
Sources
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance