
Résumé
OVERregroupait dans une réponse des résumés séparés par des tabulations, au lieu d’imposer la récupération successive des en-têtes de chaque article.LIST OVERVIEW.FMTne pouvait annoncer un champ absent du stockage ou représenté de façon incohérente ; une case vide dans une colonne annoncée acquérait ainsi un sens négatif précis.- Lors d’un changement d’index, le serveur devait retirer la colonne avant d’arrêter son alimentation et attendre le retour à la cohérence avant d’ajouter une nouvelle colonne.
Une case vide n’explique pas sa cause
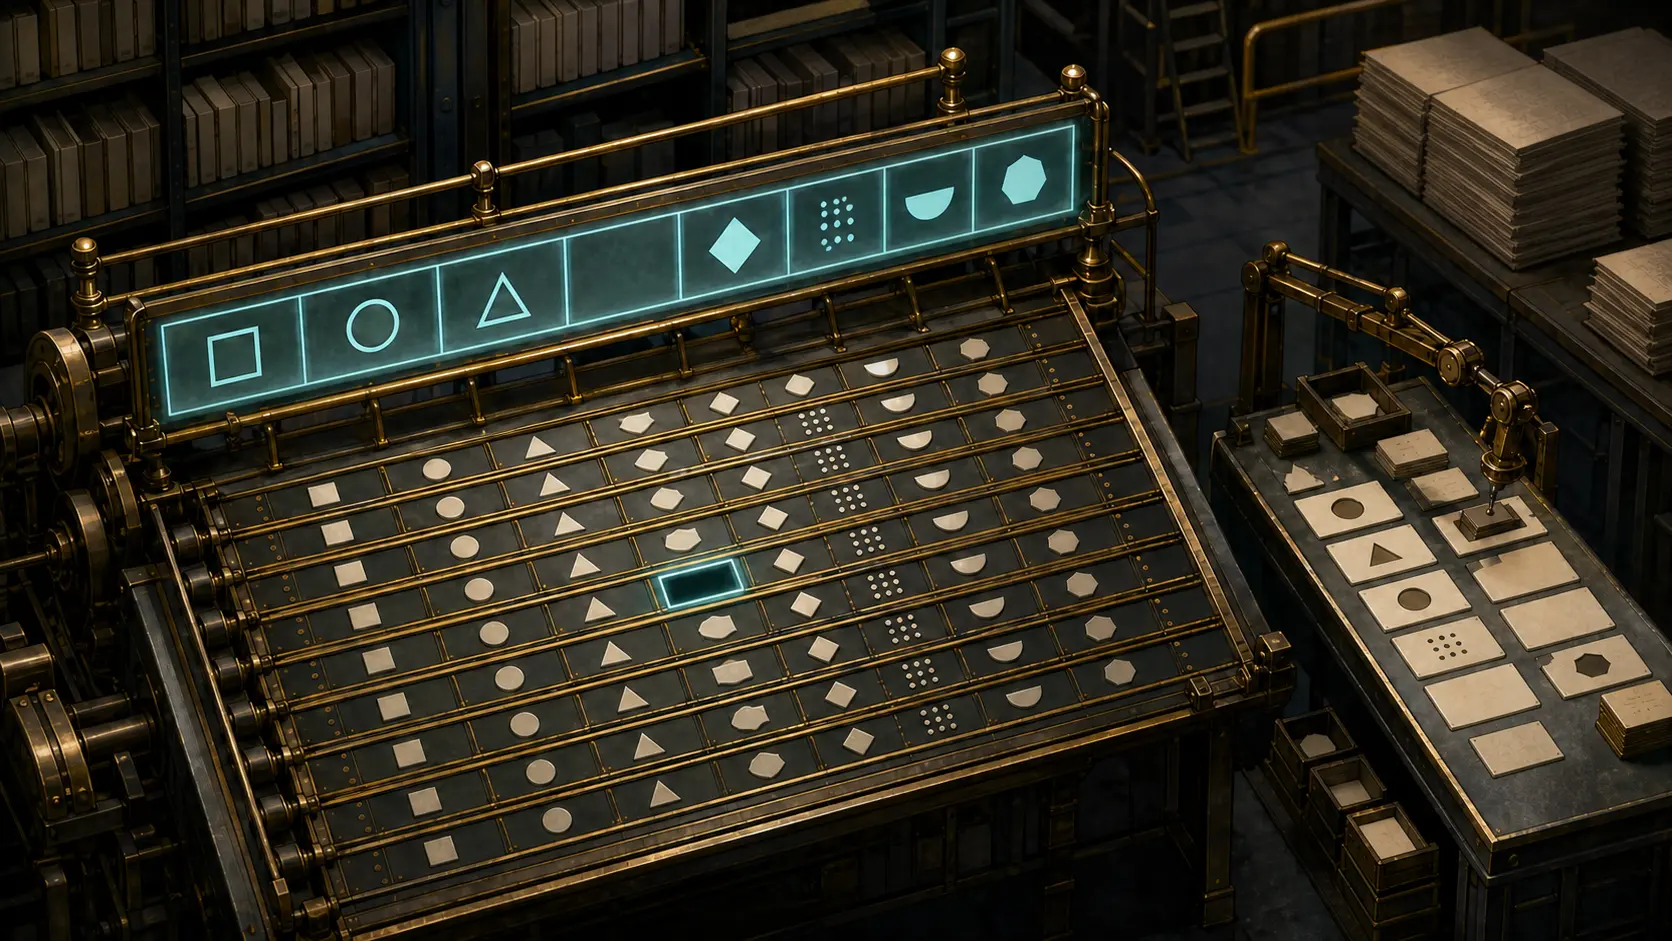
Le lecteur voit une ligne compacte. Après la date viennent deux tabulations adjacentes, puis la valeur suivante. La place a été conservée, mais rien ne l’occupe. Est-ce une propriété de l’article ou une lacune de l’index ?
Sans contrat extérieur, les deux hypothèses produisent exactement les mêmes octets. Un logiciel qui transforme automatiquement ce vide en « en-tête absent » peut donc fabriquer une conclusion. La valeur négative n’existe que si le serveur affirme avoir représenté, pour toute la collection concernée, aussi bien la présence que l’absence de ce champ.
RFC 3977 nomme cette propriété la cohérence de la base d’aperçu. Si certains articles contenant un en-tête sont enregistrés et d’autres non, la colonne est incohérente. Elle ne doit pas apparaître dans LIST OVERVIEW.FMT.
Du HEAD individuel à l’aperçu collectif
Dans RFC 977, HEAD rend les en-têtes d’un article choisi par Message-ID ou par numéro local. La primitive reste utile pour inspecter un article précis. Mais bâtir l’écran d’un groupe entier exige de répéter l’opération pour chaque élément.
RFC 2980 décrit ensuite XOVER, issu du travail sur une base commune d’aperçu. Une plage de numéros produit plusieurs lignes. Chacune commence par le numéro de l’article, puis le sujet, l’auteur, la date, le Message-ID, les références, le nombre d’octets et le nombre de lignes. D’autres champs peuvent suivre.
Le gain vient de l’index pré-calculé et de la livraison groupée. Il impose cependant une grammaire positionnelle. Une valeur qui contient elle-même une tabulation pourrait décaler toute la fin de la ligne ; elle est donc convertie en espace, comme les fins de ligne après dépliage.
Un noyau stable, une extension déclarée
Avec OVER, RFC 3977 fixe les huit premières positions. Le numéro, ou zéro dans certains accès par Message-ID, précède cinq contenus d’en-tête et deux métadonnées : :bytes et :lines. Une valeur intérieure manquante garde sa place par deux tabulations adjacentes. Seules les cases vides de fin peuvent ne pas être matérialisées.
LIST OVERVIEW.FMT décrit l’ordre. Ses sept premières lignes correspondent aux positions deux à huit. Après ce noyau, une extension peut nommer une métadonnée ou signaler, par le suffixe :full, que la valeur conserve aussi le nom de l’en-tête.
Cette liste n’est pas un manuel figé. La norme permet qu’elle change entre deux appels dans la même session. Le client découvre l’état présent de l’index, pas une vérité éternelle sur le serveur.
Pourquoi une nouvelle colonne devait attendre
Imaginons qu’un exploitant décide aujourd’hui d’indexer un nouvel en-tête. Les articles reçus demain rempliront naturellement la nouvelle case. Les anciens restent incomplets tant qu’une reconstruction n’a pas relu leurs en-têtes. Afficher immédiatement la colonne mêlerait deux sens du vide : l’absence dans l’article et l’absence de rétro-indexation.
RFC 3977 impose alors une discipline en deux temps. Avant de cesser de stocker un champ, le serveur doit l’enlever du format annoncé. Pour un champ nouveau, il attend que la base redevienne cohérente : soit par reconstruction, soit parce que la rétention a fait disparaître les articles antérieurs au changement.
Le retrait temporaire n’est donc pas un recul de capacité. C’est une limitation de la portée probatoire. Le serveur peut connaître quelques valeurs sans posséder encore l’autorité nécessaire pour promettre toute la colonne.
Le vide certifié
Une fois le champ annoncé et cohérent, une cellule vide devient interprétable. La norme permet alors de conclure que l’article ne porte pas cet en-tête, ou que la métadonnée ne s’applique pas. La case ne tire pas sa force de son apparence, mais de la couverture déclarée autour d’elle.
À l’inverse, un champ absent de LIST OVERVIEW.FMT ne dit rien sur les articles. Il dit seulement que l’aperçu ne fournit pas une représentation suffisamment uniforme. Confondre ces niveaux revient à transformer une retenue du serveur en absence attribuée aux auteurs.
Des métadonnées calculées, mais pas infaillibles
Les noms commençant par deux-points distinguent les métadonnées calculées par le serveur des en-têtes transmis dans l’article. Le serveur ne doit pas croire aveuglément un éventuel en-tête Lines ou Bytes. Il calcule :lines et :bytes lui-même.
Cette provenance ne supprime pas toutes les limites. RFC 3977 décrit plusieurs pratiques historiques divergentes pour :bytes et ordonne aux clients de ne pas dépendre de sa précision absolue. La source du calcul est claire ; sa mesure peut rester imparfaite.
Un aperçu de plage ne promet pas non plus que tous les numéros existent. Les articles supprimés ne devraient plus produire de ligne. Le tableau résume les entrées disponibles ; il ne ressuscite pas les corps expirés.
Le registre IANA des paramètres NNTP inscrit OVER comme capacité d’aperçu. Il établit le signal interopérable sans mesurer la vitesse ni attester l’état d’un serveur particulier.
Pour aller vite, il fallait savoir dire moins
L’aperçu a déplacé vers le serveur un travail que chaque lecteur aurait autrement répété. Mais le raccourci n’était fiable qu’à condition de ne pas présenter un index partiel comme une table complète.
La norme a protégé la signification du vide par une règle de retenue : pendant une transition, annoncer moins ; après cohérence, promettre davantage. Une cellule vide devenait une preuve seulement lorsque la colonne avait mérité cette confiance.
Sources
Briefing des membres
Contexte approfondi du profil
Connectez-vous avec le bon niveau d'adhésion pour débloquer le briefing complet et les notes de source.
Réservé à Strategic Circle
Strategic Circle
Ouvert à tous les lecteurs. Débloquez les briefings de profil après adhésion et connexion.
Rejoindre Strategic CircleRéservé aux membres de Leadership Alliance
Leadership Alliance
Réservé aux propriétaires et dirigeants qualifiés d'actifs IP ; connectez-vous pour débloquer les briefings Alliance.
Rejoindre Leadership Alliance