
Resumen
- Veronica buscaba títulos de menús Gopher y devolvía elementos seleccionables; no recorría el contenido de los archivos.
- En 1994, la recolección en Nevada y la atención de consultas desde ocho servidores públicos eran funciones separadas.
- El diseño amplió el descubrimiento, pero dejó cobertura, calidad de los títulos, actualización y exclusiones locales en manos de operadores y editores.
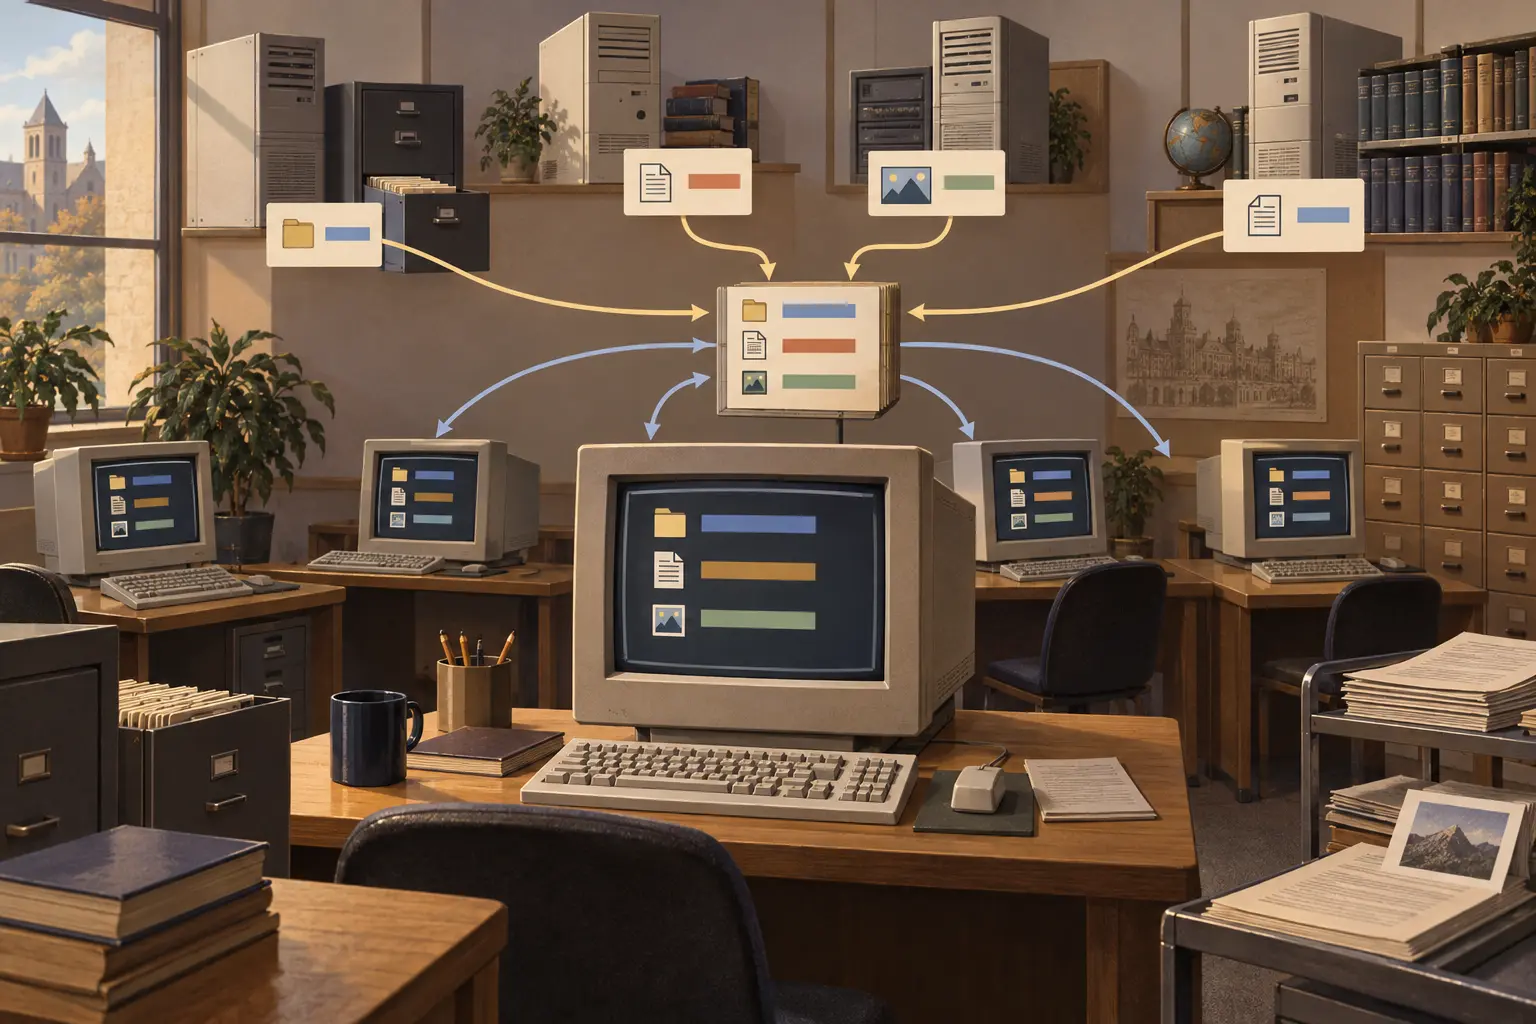
Una búsqueda podía devolver miles de resultados sin haber leído un solo documento. Ese era el trato que Veronica ofrecía a quienes usaban Gopher a comienzos de los noventa: buscaba los títulos impresos en los menús de los servidores y devolvía un menú con los elementos coincidentes. Al seleccionar uno, el lector llegaba a su origen. El índice facilitaba encontrar recursos sin trasladar los archivos a un repositorio central.
En su anuncio del 17 de noviembre de 1992, Steve Foster presentó Veronica como una respuesta experimental al problema de descubrir recursos en un Gopher que crecía con rapidez. El servicio tenía indexados 258 servidores y había detectado más de 500. Foster esperaba que la demanda superara pronto la capacidad de la primera máquina y adelantó que distribuirían el servicio. También fijó con claridad su límite: Veronica indexaba títulos de menús, no el texto completo alojado en cada sitio.
Sus resultados seguían siendo útiles porque eran elementos Gopher que el cliente podía abrir, y no una lista de nombres de servidores que el usuario tuviera que visitar por separado.
La diferencia aparece al mirar el protocolo. RFC 1436, publicado en marzo de 1993, describe la transacción de búsqueda de tipo 7: el cliente envía un selector y palabras de consulta, y el servidor responde con un menú. El RFC la llama transacción de búsqueda de texto completo porque algunos servidores podían indexar el contenido. Esa etiqueta general no define el índice de Veronica. Para 1994, la guía de uso y los documentos del operador explicaban que la consulta normal coincidía con palabras de los títulos. Podía encontrarse el título de una carpeta, un archivo o una imagen; no el cuerpo del documento, salvo que otro servicio lo indexara.
La interfaz sencilla escondía un servicio dividido en dos tareas. Un recolector recorría los menús Gopher accesibles, preparaba un índice y distribuía conjuntos de datos. Los servidores de búsqueda respondían las consultas de tipo 7 de los clientes Gopher. En febrero de 1994, el informe de situación editado por Steven Foster decía que la Universidad de Nevada recolectaba y preparaba los datos, que después se distribuían a otros servidores Veronica. Ocho sitios públicos ofrecían búsquedas desde julio de 1993, con apoyo de redes de investigación e instituciones de Norteamérica y Europa.
El informe calculó que los servidores públicos atendieron 1,2 millones de consultas en febrero y afirmó que la mayoría se resolvía en menos de veinte segundos. Son estimaciones de los operadores de la época, no una auditoría independiente del tráfico.
La escala creció deprisa. El informe de 1994 contaba más de 3.200 servidores Gopher en unos 2.500 hosts de Internet. La FAQ de Foster informó después de unos 10 millones de elementos indexados en aproximadamente 5.500 servidores en junio de 1994, y de cerca de 15 millones en noviembre. En enero de 1995 registró 5.057 servidores Gopher y alrededor de otros 5.000 servicios referenciados desde menús Gopher, incluidos sitios Web y servicios Telnet. Son recuentos de fechas y categorías distintas: no deben sumarse en una cifra única. Sí muestran que un índice de títulos podía dar acceso a recursos alojados fuera de Gopher.
El índice no hacía que todo fuera igual de fácil de encontrar. Según la FAQ, un servidor recién instalado podía quedar fuera de un ciclo mensual; una caída o una restricción de acceso también podía impedir la recolección. El administrador podía excluir todo el servidor o limitar la indexación a ciertos menús mediante un archivo de control. Eso preservaba decisiones locales, aunque hacía posible que la falta de resultados se debiera a una recolección fallida, a la inaccesibilidad o a que el título no usara las palabras esperadas. La guía permitía precisar la búsqueda con operadores booleanos y filtros por tipo de elemento.
Pero el límite predeterminado era de 200 resultados. Una palabra frecuente podía convertir el índice en otro laberinto de navegación.
La replicación también generaba diferencias de tiempo. Foster decía que, en teoría, todos los servidores Veronica debían ofrecer las mismas respuestas. En la práctica, no actualizaban el índice a la vez, por lo que los resultados podían variar; la carga y el tráfico también afectaban la rapidez. Distribuir las consultas reducía la presión sobre una sola máquina, pero no quitaba la dependencia del equipo de Nevada que preparaba el conjunto de datos. Y un índice común no mandaba sobre todos los editores de Gopher: seguía los menús a los que podía acceder y respetaba las exclusiones configuradas por cada administrador.
Ahí reside el interés histórico. Veronica agregó una capa de descubrimiento a escala de red sin pretender poseer la información subyacente. Una petición común podía devolver elementos de instituciones distintas, mientras los archivos permanecían en sus servidores y sus responsables retenían cierto control sobre la indexación. La Nota 64 aporta, décadas después, una lente para preguntar dónde terminaba la especificación compartida y dónde comenzaba la operación local; no es una fuente sobre Veronica.
Los registros de la época muestran un intercambio concreto: un título consultable, una copia distribuida del índice y un camino directo al editor. El sistema solo podía encontrar lo que la recolección y los títulos dejaban visible; ese límite pertenecía a su arquitectura, no estaba escondido tras una promesa de búsqueda del texto completo.
Fuentes: anuncio de Foster del 17 de noviembre de 1992; RFC 1436; RFC 1580; RFC 1689 / FYI 25; RFC 1739; FAQ de Veronica, parte 1; parte 2.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance