
Resumo
- Veronica pesquisava títulos dos menus Gopher e devolvia itens selecionáveis; não examinava o conteúdo dos arquivos.
- Em 1994, a coleta de dados em Nevada e o atendimento de buscas em oito servidores públicos já eram funções distintas.
- O desenho ampliou a descoberta, mas deixou cobertura, qualidade dos títulos, atualização e exclusões locais com operadores e publicadores.
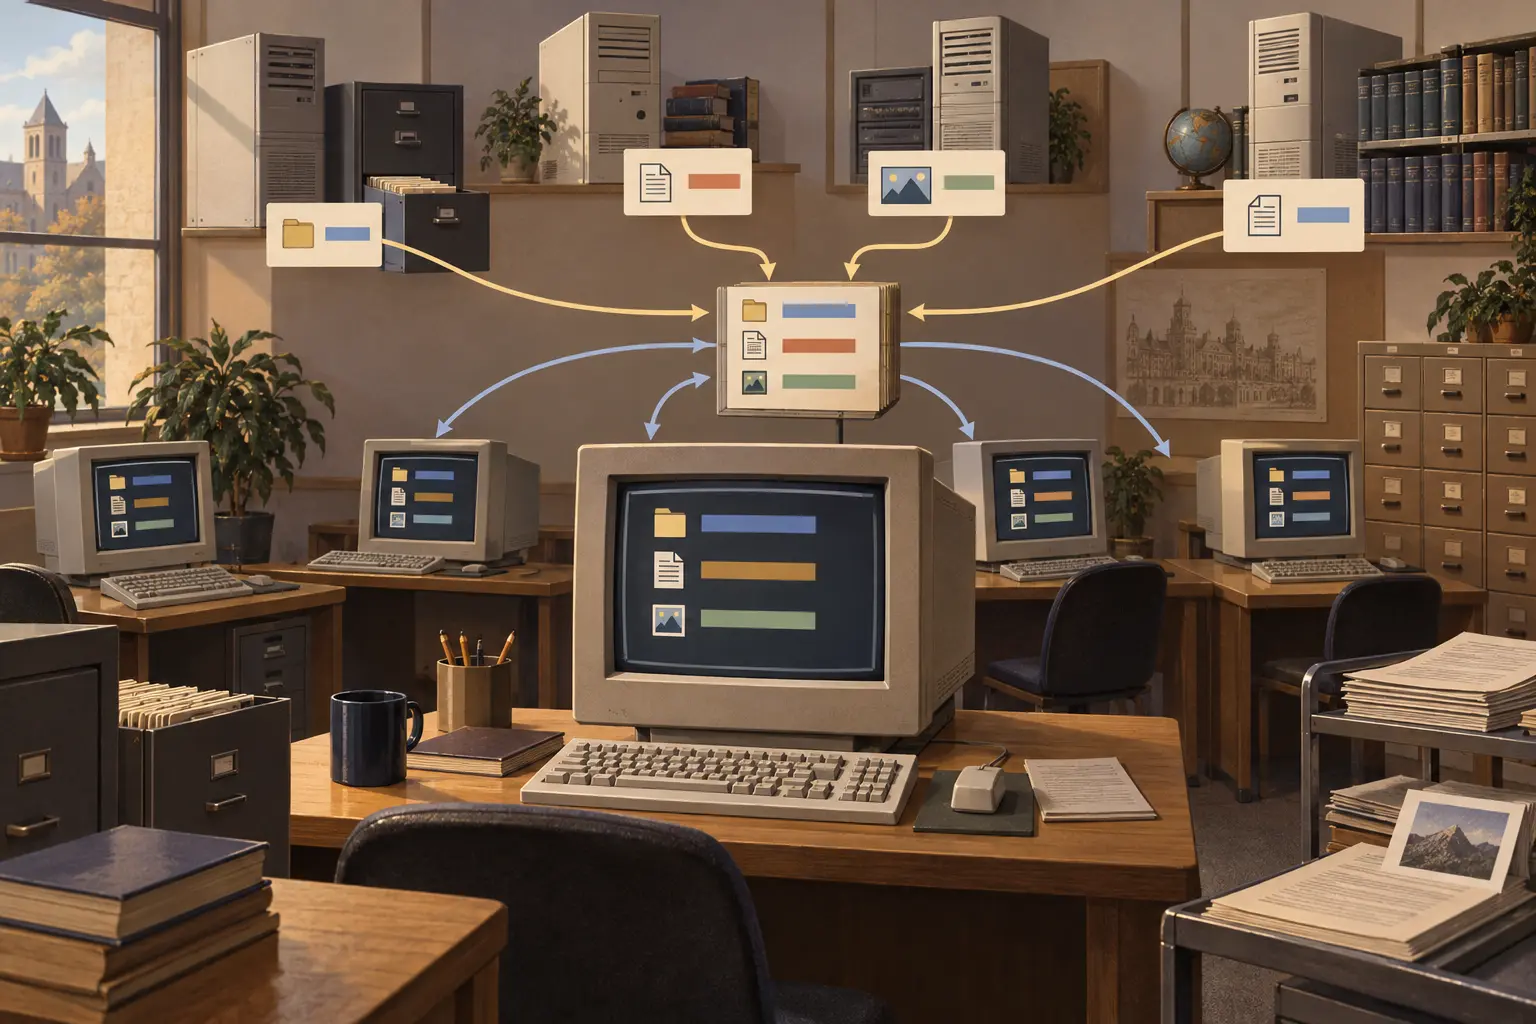
Uma busca podia retornar milhares de resultados sem ter lido um único documento. Esse era o acordo que Veronica oferecia a quem usava Gopher no começo dos anos 1990: procurar os títulos exibidos nos menus dos servidores e devolver um menu com os itens correspondentes. Ao escolher um deles, a pessoa chegava à fonte. O índice facilitava a descoberta sem levar os arquivos para um repositório central.
No anúncio de 17 de novembro de 1992, Steve Foster apresentou Veronica como uma experiência para enfrentar a dificuldade de encontrar recursos num Gopher que crescia rapidamente. O serviço indexava 258 servidores e já havia descoberto mais de 500. Foster previa que a procura logo superaria a capacidade da primeira máquina e planejava distribuir o serviço. O limite também estava declarado: Veronica indexava títulos de menus, não o texto integral mantido em cada site. Ainda assim, cada resultado era um item Gopher funcional que o cliente podia abrir, em vez de apenas um nome de host que o leitor precisaria visitar depois.
O protocolo ajuda a entender a distinção. Publicado em março de 1993, o RFC 1436 descreve a transação de busca tipo 7: o cliente envia um seletor e palavras de consulta, e o servidor devolve um menu. O RFC usa a expressão “busca de texto completo” porque servidores Gopher podiam implementar índices de conteúdo. Esse nome genérico não descreve o índice da Veronica. Em 1994, as instruções de uso e os documentos do operador explicavam que a busca habitual correspondia às palavras nos títulos dos itens.
Era possível localizar o nome de um diretório, arquivo ou imagem; o texto do documento ficava fora do alcance, a menos que outro serviço o indexasse.
A interface simples escondia um serviço com duas funções. Um coletor percorria os menus Gopher acessíveis, preparava um índice e distribuía conjuntos de dados. Servidores de busca respondiam às consultas tipo 7 feitas pelos clientes Gopher. O relatório de situação de fevereiro de 1994, editado por Steven Foster, dizia que a coleta e preparação ocorriam na Universidade de Nevada, enquanto os conjuntos de dados eram enviados a outros servidores Veronica. Oito sites públicos ofereciam buscas desde julho de 1993, apoiados por redes de pesquisa e instituições na América do Norte e na Europa.
O relatório estimou 1,2 milhão de consultas nos servidores públicos em fevereiro e afirmou que a maioria era resolvida em menos de vinte segundos. São estimativas dos operadores da época, não uma auditoria independente do tráfego.
A escala cresceu rapidamente. O relatório de 1994 contava mais de 3.200 servidores Gopher em cerca de 2.500 hosts da Internet. A FAQ de Foster depois registrou aproximadamente 10 milhões de itens em cerca de 5.500 servidores em junho de 1994 e perto de 15 milhões em novembro. Em janeiro de 1995, contava 5.057 servidores Gopher e cerca de outros 5.000 serviços citados por menus Gopher, entre eles servidores Web e serviços Telnet. As datas e categorias são diferentes; não devem ser somadas num total único. Elas mostram que um índice de títulos também podia levar a recursos fora do Gopher.
O índice não tornava tudo igualmente fácil de encontrar. Segundo a FAQ, servidores novos podiam perder um ciclo mensal de coleta; falhas ou restrições de acesso também podiam impedir a varredura. Administradores podiam excluir todo o servidor ou permitir a indexação de apenas alguns menus por meio de um arquivo de controle. Isso preservava escolhas locais, mas significava que a ausência de resultado podia decorrer de uma coleta ainda não feita, de falta de acesso ou de um título diferente das palavras usadas. O guia permitia restringir a busca com operadores booleanos e tipos de item.
Por padrão, porém, o servidor retornava no máximo 200 resultados. Uma palavra comum podia transformar um grande índice em outro problema de navegação.
A replicação trouxe diferenças de horário. Foster dizia que, idealmente, qualquer servidor Veronica deveria dar as mesmas respostas. Na prática, os servidores atualizavam o índice em momentos diferentes e podiam divergir; carga e tráfego de rede também afetavam o tempo de resposta. Distribuir as consultas aliviava a pressão sobre uma máquina, mas não removia a dependência da equipe de Nevada que preparava o conjunto de dados. E uma coleta central não significava controle central sobre os publicadores: Veronica percorria menus acessíveis e respeitava as exclusões configuradas pelos administradores.
Esse equilíbrio é o ponto histórico. Veronica acrescentou descoberta em escala de rede sem reivindicar a propriedade das informações. Uma consulta simples podia reunir itens de muitas instituições, enquanto os arquivos permaneciam nos servidores de origem e seus responsáveis conservavam algum controle sobre a indexação. A Nota 64 oferece, décadas depois, uma lente para perguntar onde termina uma especificação compartilhada e começa a operação local; ela não é evidência histórica sobre Veronica. Os registros do período mostram uma troca concreta: um título pesquisável, cópias distribuídas do índice e um caminho direto de volta ao publicador.
O sistema só encontrava o que a coleta e os títulos tornavam visível; esse limite fazia parte da arquitetura, não era algo escondido por uma promessa de busca integral.
Fontes: anúncio de Foster em 17 de novembro de 1992; RFC 1436; RFC 1580; RFC 1689 / FYI 25; RFC 1739; FAQ da Veronica, parte 1; parte 2.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance