
Resumen
- Dos fuertes terremotos sacudieron la costa suroccidental de Taiwán con ocho minutos de diferencia, pero los daños en los cables se desarrollaron como una secuencia a lo largo de unas catorce horas, no como un corte instantáneo.
- Varios sistemas de cable independientes compartían un corredor de riesgo concentrado al sur de Taiwán. Los desvíos BGP recuperaron parte de la accesibilidad, pero las rutas alternativas estrechas, la congestión y las rutas más largas mostraron por qué la accesibilidad no equivale a capacidad utilizable.
- La prueba defendible de rendición de cuentas se refiere a la geografía de las rutas, la capacidad de reserva activada, las políticas de peering y tránsito, la notificación de fallos, la localización y los acuerdos de reparación ejecutables, no a si un operador podía evitar un terremoto.
El 26 de diciembre de 2006, el primer hecho visible fue geológico: dos potentes terremotos ocurrieron frente a la costa suroccidental de Taiwán. El hecho de infraestructura más relevante surgió después. Aparecieron fallos en cables submarinos en una secuencia a lo largo de un corredor que transportaba una gran parte de la conectividad internacional de la región. Los operadores de red encontraron rutas alternativas, cambiaron su política de tráfico y afrontaron un exigente calendario de reparaciones marinas. La conectividad volvió por etapas, pero las etapas no significaban lo mismo.
Podía existir una ruta BGP mientras una aplicación seguía siendo dolorosamente lenta. El servicio de voz podía recuperarse antes que el rendimiento de Internet en horas punta. Un operador podía restaurar la mayor parte de la capacidad antes de que todos los segmentos dañados de la planta húmeda volvieran a la normalidad.
Esa distinción convierte el evento de Hengchun en un caso de rendición de cuentas de red, no en una narrativa genérica de desastre. El terremoto fue un desencadenante natural. La pregunta central de control es qué ocurrió cuando varias rutas nominalmente separadas se toparon con un riesgo físico común y el tráfico desplazado se trasladó a la infraestructura restante. Contar cables en un diagrama de topología no bastaba.
La continuidad dependía de por dónde pasaban esos cables, de si sus alternativas evitaban la misma exposición en el lecho marino, de cuánto ancho de banda libre estaba realmente disponible, de si las políticas de peering y tránsito podían usarlo, de la rapidez con que se localizaban los fallos y de si podían ejecutarse buques, equipos y planes de reparación coordinados.
La evidencia no respalda un veredicto de que una sola empresa provocara una interrupción regional, ni establece que todos los operadores se comportaran igual. Chunghwa Telecom solo puede vincularse al evento mediante su propia comunicación pública ante la SEC y un relato regional posterior atribuido. Los registros públicos de Hong Kong describen a los operadores y usuarios de Hong Kong, no las decisiones privadas de enrutamiento de Chunghwa. La geología revisada por pares explica una secuencia inferida de deslizamientos y corrientes de turbidez, no un registro presencial de cada rotura.
La orientación posterior sobre resiliencia ayuda a identificar la evidencia que un programa de continuidad maduro debería producir hoy, pero no era una obligación legal retroactiva en 2006.
El caso es valioso precisamente porque esos límites obligan a una forma mejor de escrutinio. La rendición de cuentas aquí significa contrastar las afirmaciones de redundancia con el servicio en funcionamiento, la geografía física y la evidencia de reparación. Pregunta si la red podía soportar la demanda desplazada, no solo si los enrutadores encontraron alguna ruta. Pregunta si cables aparentemente independientes eran independientes del riesgo relevante, no solo si tenían nombres distintos. Pregunta si los hitos de recuperación estaban claramente definidos, no solo si un proveedor anunció que el servicio mejoraba.
1. El evento comenzó como un doblete, no como una sacudida simplificada
El registro sísmico debe mantenerse separado del mecanismo posterior del cable. La página del evento del USGS ancla el evento, mientras que el póster adjunto registra una primera sacudida a las 12:26:21 UTC del 26 de diciembre de 2006, con magnitud de momento 7,1, en 21,825° N y 120,538° E, y una profundidad declarada de 5 kilómetros.
Registra una segunda sacudida a las 12:34:14 UTC, ocho minutos después, con magnitud de momento 6,9, en 22,023° N y 120,539° E, también a una profundidad declarada de 5 kilómetros.[1][2] Un artículo vinculado al USGS describe los dos terremotos como el doblete de Pingtung y documenta los datos de movimiento fuerte recogidos por la red instrumental de Taiwán.[3]
Un estudio posterior revisado por pares sobre los fallos de cable redondea ambas sacudidas a magnitud 7,0.[4] La diferencia no debe «corregirse» inventando un valor armonizado único. Los valores de los catálogos, las convenciones científicas y el redondeo pueden diferir. En este relato, los valores exactos del póster del USGS establecen la cronología del evento, mientras que los valores redondeados siguen formando parte de la descripción del propio artículo de geología.
Esto importa porque una apertura sobresimplificada puede distorsionar todo el relato causal. Decir que «el terremoto cortó los cables» sugiere un momento en el que la ruptura de una falla cortó directamente todas las líneas afectadas. La investigación pública describe algo más complejo. Las dos sacudidas crearon o acompañaron condiciones para deslizamientos submarinos, desplomes de sedimentos y corrientes de turbidez. Las roturas de cable se notificaron después en momentos y lugares distintos.
Algunas fueron cercanas a las horas del terremoto; otras siguieron a medida que el movimiento destructivo de sedimentos viajaba por cañones y hacia aguas más profundas.[4][23]
La distinción no es cautela semántica por sí misma. Separa cinco tipos de evidencia que responden a preguntas distintas:
- Evidencia sísmica: establece cuándo y dónde ocurrieron las dos sacudidas principales.
- Evidencia de geología marina: reconstruye el mecanismo probable que conecta la actividad sísmica con el daño en los cables.
- Evidencia de red: describe qué hicieron el enrutamiento y los servicios tras desaparecer la capacidad física.
- Evidencia operativa y regulatoria: registra las acciones de restauración y los hitos dentro de jurisdicciones o empresas concretas.
- Orientación posterior: aporta preguntas de control actuales sin demostrar una infracción pasada del deber.
Si estas capas se colapsan, un artículo puede convertir fácilmente la inferencia en observación, la conducta regional en conducta específica de una empresa, o una buena práctica posterior en una acusación sobre 2006. Mantenerlas separadas produce una prueba de rendición de cuentas más exigente y más útil.
2. Los fallos de cable se desarrollaron a través de un corredor de riesgo compartido
Una banda concentrada de rutas nominalmente separadas
La reconstrucción revisada por pares de Hsu y colegas sitúa al menos dieciséis cables de telecomunicaciones modernos al sur de Taiwán dentro de una banda este-oeste de aproximadamente 150 kilómetros de ancho.[4] No es una afirmación de que todos los cables siguieran una línea idéntica o tuvieran la misma propiedad. Es evidencia de que muchas rutas utilizaban el mismo paso regional amplio y cruzaban rasgos del lecho marino capaces de transmitir un riesgo correlacionado.
El estudio utilizó horas y lugares de rotura extraídos de informes de operaciones de reparación de cables. Asoció la secuencia principal con los cañones submarinos de Fangliao y Kaoping y con la fosa de Manila. En esa geografía, un cable puede estar físicamente separado de otro a escala de un dibujo de ruta y aun así quedar expuesto al mismo sistema de cañones, sedimento inestable o flujo de densidad en movimiento. La diversidad de rutas es, por tanto, una cuestión de separación de riesgos, no solo de separación geométrica a una escala cartográfica conveniente.
Este es el primer punto en el que la tesis de rendición de cuentas se vuelve específicamente sobre infraestructura de red. Un plan de continuidad puede mostrar varios sistemas internacionales y aun así tener una debilidad de modo común si esos sistemas convergen a través de un corredor geológicamente expuesto. La evidencia relevante no es el número de partidas en un inventario de capacidad. Es un estudio de rutas que muestre batimetría, cruces de cañones, condiciones del sedimento, aproximaciones de amarre, fallos históricos cercanos y el grado en que cada ruta de respaldo evita el mismo mecanismo físico.
Qué apoya la secuencia de roturas, y qué sigue siendo inferido
El estudio no presenta una grabación de cámara de una corriente golpeando cada cable. Reconstruye un mecanismo a partir del momento y la ubicación de los fallos, la batimetría y los procesos de sedimento conocidos. Eso hace que términos como «inferido», «interpretado» y «consistente con» sean esenciales.
Dos roturas tempranas de cable se notificaron con aproximadamente un minuto de diferencia y estaban separadas por unos 30 kilómetros. Los investigadores razonaron que una sola corriente en movimiento no podía cubrir plausiblemente esa distancia en el tiempo disponible, e interpretaron las roturas como resultado de deslizamientos separados.[4] Otros fallos progresaron cañón abajo en orden temporal, lo que respalda la inferencia de que flujos cargados de sedimentos viajaron por el lecho marino tras ser iniciados por los terremotos o las réplicas.
El artículo estimó distintas velocidades de flujo en distintas pendientes, incluidas aproximadamente 20, 3,7 y 5,7 metros por segundo.[4] No son velocidades universales de un solo flujo. Son estimaciones específicas de la fuente vinculadas a distintas partes de la secuencia reconstruida y al entorno batimétrico. La variación es en sí misma instructiva: un proceso destructivo del lecho marino no tiene que comportarse de manera uniforme para crear un corredor de fallos común.
El estudio informa de que la mayoría de los cables de su conjunto descrito se rompieron al menos una vez durante aproximadamente las catorce horas siguientes.[4] Una síntesis posterior de Oceanography analiza el evento como ejemplo de riesgos geológicos submarinos y registra veintidós roturas de cable.[23] La secuencia extiende la historia causal más allá del temblor inicial. Sugiere que la ventana de riesgo continuó mientras avanzaba el movimiento de masas, por lo que las decisiones de restauración y tráfico tuvieron que lidiar con un estado de fallo en evolución y no con un inventario de daños único e inmediatamente estable.
Ese estado en evolución complica el juicio operativo. Una ruta que todavía transportaba tráfico poco después de las primeras fallas podía perderse más tarde. Un plan de contingencia diseñado para una rotura aislada podía volverse inadecuado a medida que fallaban sistemas adicionales. Un operador podía enfrentarse a recálculos repetidos de qué capacidad quedaba, qué clientes o servicios priorizar y qué interconexiones alternativas seguían siendo utilizables.
La evidencia pública disponible no revela esos cálculos para cada operador, pero sí muestra por qué importan. Los fallos físicos correlacionados transforman la redundancia ordinaria en un problema de gestión de secuencias: la red debe seguir funcionando mientras el conjunto de rutas disponibles cambia.
La diversidad de riesgos no es lo mismo que el número de rutas
Una afirmación útil de diversidad de rutas necesita al menos tres capas de prueba.
En primer lugar, está laseparación física. Dos cables no deberían compartir la misma zanja vulnerable, cabecera de cañón, aproximación de amarre o punto de estrangulamiento terrestre solo porque pertenezcan a sistemas contractuales distintos.
En segundo lugar, está laindependencia de capacidad. La ruta alternativa necesita ancho de banda activado o rápidamente activable suficiente para el tráfico que se espera que se desplace a ella. Una ruta físicamente separada con poca capacidad disponible puede evitar el aislamiento total sin cumplir el objetivo de servicio.
En tercer lugar, está laindependencia de control. Las políticas de enrutamiento, peering, acuerdos de tránsito, supervisión y autoridad operativa deben permitir que el tráfico utilice la ruta cuando falla el corredor principal. Un cable que existe pero al que no se puede llegar según las políticas, los acuerdos comerciales o la configuración técnica aplicables no es continuidad ejecutable.
La secuencia de Hengchun expuso las tres como preguntas vinculadas. La evidencia del lecho marino puso en duda la separación física de muchas rutas regionales. El registro de enrutamiento y servicio mostró que las alternativas disponibles no proporcionaron automáticamente un rendimiento normal. El registro de reparación mostró que la recuperación dependía de recursos especializados compartidos y de coordinación. Si se eliminan estos hechos específicos de la red, la tesis se derrumba en una observación general de que los terremotos dañan la infraestructura.
Si se mantienen, el caso se convierte en una prueba de si las afirmaciones de continuidad estaban respaldadas por rutas reales, capacidad real y capacidad de recuperación real.
3. Las cifras describen sistemas, roturas y alcances de observación distintos
Los incidentes de infraestructura a gran escala invitan a una única cifra de titular. Este evento resiste a ello. El registro público disponible contiene varios recuentos, pero sus unidades y alcances difieren:
| Alcance de la fuente | Recuento notificado | Qué significa el recuento |
|---|---|---|
| Conectividad del Pacífico orientada a Hong Kong | Seis de siete sistemas | Sistemas de cable que pasan por la región del terremoto y son relevantes para la conectividad oriental de Hong Kong y que fallaron uno tras otro.[20] |
| Conjunto del estudio revisado por pares de Hsu | Once cables | Cables submarinos descritos como rotos en la secuencia del estudio.[4] |
| Relato regional posterior de APEC | Diecinueve puntos de rotura en siete sistemas | Apariciones de puntos de rotura en un conjunto regional definido, según se atribuye en la presentación posterior.[22] |
| Relato posterior de APEC sobre Chunghwa | Nueve puntos de rotura en cuatro sistemas | Puntos de rotura y sistemas específicos del operador atribuidos a Chunghwa Telecom.[22] |
| Síntesis posterior de Oceanography | Veintidós roturas | Ocurrencias de rotura de cable en la síntesis, no necesariamente veintidós sistemas de cable únicos.[23] |
| Formulario de Chunghwa ante la SEC | Cuatro cables afectados | Cables submarinos de Chunghwa que, según el informe, volvieron a la normalidad el 2 de febrero de 2007.[19] |
Estas cifras pueden coexistir sin contradicción. Un sistema puede sufrir más de un punto de rotura. Una fuente puede contar ocurrencias físicas de rotura mientras otra cuenta sistemas de cable con nombre. Una jurisdicción puede definir un denominador en torno a los sistemas relevantes para su propia conectividad externa. Un operador puede informar solo de los cables de su cartera afectada. Una síntesis científica posterior puede utilizar un límite de evento más amplio o reconstruido de forma distinta que una comunicación empresarial contemporánea.
La conclusión disciplinada no es «la cifra real estaba entre cuatro y veintidós». Eso seguiría mezclando unidades distintas. El enfoque correcto es conservar cada recuento con su fuente, unidad y alcance. En particular:
- Seis de siete es una proporción de sistemas relevantes orientados a Hong Kong, no una tasa de fallo global.
- Once es el número de cables de una secuencia descrita en un estudio revisado por pares, no un inventario de operador.
- Diecinueve y nueve son puntos de rotura, no cables únicos.
- Veintidós es un recuento de roturas, no prueba de que fallaran veintidós sistemas distintos.
- Cuatro es el número de cables submarinos afectados de Chunghwa que volvieron a la normalidad, no el total regional.
La disciplina de recuento forma parte de la rendición de cuentas porque las afirmaciones de restauración dependen del denominador. «Noventa por ciento restaurado» puede referirse a capacidad, mientras que «cuatro cables reparados» se refiere a activos físicos. «Servicios restaurados» puede significar que los clientes recuperaron un nivel utilizable de conectividad aunque el trabajo marítimo final quedara incompleto. Sin una unidad definida, un porcentaje de recuperación puede parecer más completo de lo que es.
La misma disciplina debería aplicarse a la notificación futura de incidentes. Los operadores y reguladores deberían distinguir sistemas únicos, ubicaciones físicas de fallo, capacidad iluminada perdida, capacidad alternativa activada, deterioro del servicio al cliente y segmentos de reparación completados. Un recuento que mezcle estos objetos no puede respaldar un juicio de continuidad fiable.
4. La accesibilidad BGP fue un primer auxilio, no capacidad de reemplazo
Puede existir una ruta mientras un servicio permanece deteriorado
La respuesta de enrutamiento ofrece la demostración más clara de la diferencia entre redundancia lógica y continuidad operativa. Un estudio de restauración revisado por pares informa de que los enrutadores BGP desviaron inicialmente el tráfico por rutas de respaldo redundantes. Ese comportamiento recuperó cierto grado de conectividad, pero las conexiones resultantes eran deficientes. Los operadores cambiaron entonces la política de enrutamiento e ingenierizaron el tráfico para que los enlaces estrechos no se saturaran con la demanda desplazada.[5]
BGP responde a una pregunta de accesibilidad: ¿qué ruta, entre las conocidas y elegibles según la política, debe usarse para un destino? No fabrica capacidad de transmisión en la ruta seleccionada. Cuando fallan varias rutas submarinas de alta capacidad, un enrutador puede encontrar una alternativa técnicamente válida a través de una conexión más larga o más estrecha. La tabla de enrutamiento puede, por tanto, contener una ruta al mismo tiempo que los usuarios experimentan congestión, retardo, pérdida o aplicaciones que ya no funcionan de forma aceptable.
Por eso «Internet se enrutó alrededor del daño» es una descripción incompleta. Capta la capacidad del sistema distribuido para encontrar alternativas, pero no la calidad ni la escala de esas alternativas. Enrutar alrededor de un fallo puede impedir la desconexión total dejando aun así un grave déficit de capacidad.
El estudio también describe redes de investigación y educación de enlace único que requirieron conexiones comerciales temporales, y subraya la colaboración entre operadores.[5] Esa evidencia añade una dimensión topológica. Las redes con un solo enlace internacional significativo no podían confiar en la selección de políticas entre varias rutas preexistentes. Necesitaban otra conexión física o comercial. Para ellas, el problema no era simplemente elegir la mejor ruta; era obtener cualquier sustituto utilizable.
Las políticas de peering y tránsito son controles de continuidad
Cuando desaparecen las rutas internacionales principales, el tráfico desplazado no se mueve solo según la topología física. Se mueve según las rutas que los operadores anuncian y aceptan, las capacidades asociadas a las relaciones de peering y tránsito, y las decisiones de ingeniería de tráfico tomadas bajo presión.
Una ruta alternativa de cable puede estar físicamente intacta pero operativamente limitada de varias maneras:
- La interconexión relevante puede tener capacidad de puerto o de circuito insuficiente.
- La ruta puede ser mucho más larga, aumentando el tiempo de ida y vuelta para servicios interactivos.
- La política puede preferir o rechazar rutas de formas aceptables en condiciones normales pero contraproducentes durante un fallo regional.
- El tráfico entrante y saliente puede seguir rutas distintas, produciendo cuellos de botella asimétricos.
- Un respaldo estrecho puede atraer más tráfico del que puede transportar con seguridad.
- Una red que normalmente depende de acuerdos de liquidación o capacidad en una dirección puede necesitar capacidad de emergencia de otras regiones.
Las fuentes disponibles no revelan estas condiciones para cada sistema autónomo. Respaldan el patrón general observado: los desvíos BGP proporcionaron accesibilidad inicial y luego los operadores tuvieron que ajustar la política de enrutamiento y la ingeniería de tráfico porque las rutas disponibles no eran adecuadas para toda la carga desplazada.[5]
Ese es un punto central de rendición de cuentas. Una ruta de respaldo configurada no debe acreditarse como control de continuidad completado solo porque aparezca en una base de información de enrutamiento. La evidencia debe mostrar cuánto tráfico puede transportar, con qué rapidez puede activarse, qué servicios admite, para qué combinaciones de fallos está diseñada y qué ocurrió en una prueba o en un evento real.
Límites de la evidencia del plano de control
Existen archivos históricos de enrutamiento. Route Views publica datos de actualización BGP de diciembre de 2006, el Routing Information Service de RIPE explica su sistema de medición y CAIDA BGPStream ofrece herramientas para el análisis de datos históricos de enrutamiento.[15][16][17] El RFC 4271 define los mensajes BGP UPDATE, la información de rutas y el comportamiento central de selección de rutas.[18] Investigaciones posteriores también muestran métodos para examinar tablas de enrutamiento y actualizaciones en escalas temporales de desastre, y advierten de que distintas vistas revelan distintas partes de un evento.[6][24]
La evidencia disponible no incluye ninguna reproducción específica del evento a nivel de sistema autónomo. Por tanto, sería inapropiado afirmar:
- una ruta AS concreta de Chunghwa antes o después de las roturas de cable;
- un número exacto de retiros causados por el evento;
- un tiempo universal de convergencia BGP;
- la ruta de reenvío que tomaron los paquetes de un usuario con nombre;
- un inventario completo de operadores que cambiaron de política;
- o una medición del plano de control como prueba de la calidad de servicio de todos los usuarios.
Los colectores ven puntos de observación de peering seleccionados. Sus datos pueden mostrar anuncios y retiros visibles en esos puntos, pero no todas las rutas privadas, todas las decisiones de reenvío ni todos los enlaces congestionados. Incluso una reproducción rigurosa tendría que separar la correlación temporal de la causalidad y la accesibilidad del plano de control del rendimiento del plano de datos.
La ausencia de esa reproducción no borra la evidencia de restauración publicada. Establece el nivel de precisión. El estudio de IEICE respalda una conclusión general y relevante: la información de enrutamiento redundante ayudó a restaurar la conectividad, pero el ancho de banda de respaldo disponible y la política requirieron una intervención adicional.[5] Esa es la conclusión más sólida respaldada por la evidencia disponible; una narrativa por sistema autónomo requeriría datos adicionales.
La capacidad utilizable es una propiedad de extremo a extremo
La capacidad se discute a menudo como si perteneciera a un solo cable. Para un usuario, sin embargo, la capacidad utilizable es de extremo a extremo. Depende del segmento relevante más estrecho a través del acceso, la red troncal, el cable internacional, el amarre, la interconexión y el tránsito del lado de destino. Alejar el tráfico de un cable dañado puede revelar una restricción en otro lugar.
Las rutas más largas también cambian el comportamiento de las aplicaciones. Una ruta alternativa puede tener rendimiento medio suficiente para la transferencia masiva mientras crea una latencia que perjudica la voz en tiempo real, las transacciones interactivas u otros servicios sensibles al retardo. Una prueba de continuidad debería distinguir por tanto:
- accesibilidad IP simple;
- disponibilidad estable de rutas;
- pérdida de paquetes y latencia;
- rendimiento sostenido y en picos;
- calidad de servicio específica de la aplicación;
- y el porcentaje de demanda normal que puede transportarse.
El registro de Hengchun muestra por qué una única bandera de «restaurado» es inadecuada. Algunas funciones de voz y de itinerancia se recuperaron antes que el pleno rendimiento de Internet, mientras que la congestión en horas punta y las rutas más largas siguieron importando.[21] La red no estaba ni totalmente caída ni totalmente normal. Atravesó estados degradados que deberían describirse con medidas explícitas de servicio y capacidad.
5. El registro público de Hong Kong muestra la brecha operativa
El gobierno de Hong Kong y su regulador de telecomunicaciones ofrecieron una visión pública de los efectos regionales, las rutas alternativas y la reparación. Ese registro es valioso, pero su jurisdicción debe permanecer visible.
El gobierno informó de que seis de los siete sistemas de cable del océano Pacífico que pasan por la región del terremoto y son relevantes para la conectividad oriental de Hong Kong fallaron uno tras otro. Dijo que los sistemas dañados representaban aproximadamente el noventa por ciento de la capacidad de conectividad externa de Hong Kong.[20] No era una declaración de que el noventa por ciento de todos los activos regionales de cable hubieran sido destruidos, ni una cifra de capacidad de Chunghwa. Describía la exposición de Hong Kong a un conjunto particular de sistemas y rutas.
Los operadores utilizaron satélites y rutas ópticas a través de China continental, el sudeste asiático y Europa.[20] OFTA describió esfuerzos para maximizar el rendimiento y obtener capacidad hacia Norteamérica a través de Europa, Singapur, Australia y China continental.[21] Estas alternativas demuestran la amplitud de la respuesta, pero también revelan su coste en longitud de ruta y capacidad restringida.
Los servicios de voz e itinerancia se recuperaron comparativamente rápido, mientras que el acceso a Internet siguió lento durante las horas punta. Las rutas más largas afectaron a las aplicaciones en tiempo real.[21] El 5 de enero de 2007, OFTA informó de que los principales proveedores de servicios de Internet de Hong Kong habían recuperado alrededor del ochenta por ciento de su capacidad de conexión internacional.[21] De nuevo, era un hito de proveedores de Hong Kong; no debe transferirse a Chunghwa ni tratarse como prueba de que todos los servicios habían alcanzado el ochenta por ciento de la calidad normal.
La secuencia ilustra por qué la continuidad necesita varios paneles, no una única línea de estado. Un regulador u operador podría informar por separado:
- sistemas físicos fuera de servicio;
- capacidad internacional no disponible;
- capacidad alternativa activada;
- estado de voz e itinerancia;
- rendimiento de Internet en horas punta;
- rendimiento de aplicaciones sensibles a la latencia;
- clientes o servicios todavía materialmente deteriorados;
- y finalización estimada de la reparación física.
Esa separación haría más honesta la información pública sin exigir la divulgación de detalles sensibles de rutas. También reduciría la tentación de tratar un hito de restauración parcial como recuperación final.
El relato de Hong Kong respalda otra distinción importante: el redireccionamiento puede cambiar qué infraestructura se vuelve crítica. Las rutas a través de Europa, Singapur, Australia o China continental podían ser periféricas para el tráfico ordinario hacia el este, pero centrales durante el fallo. La planificación de la continuidad debe por tanto evaluar dependencias que solo aparecen bajo conmutación por error. Una ruta alternativa no es independiente si su capacidad, interconexión o autoridad operativa se convierte en otra restricción única una vez que la demanda se desplaza.
Nada en este registro prueba que todos los operadores de Hong Kong tomaran la misma decisión o tuvieran la misma experiencia. Los resúmenes públicos comprimen una respuesta heterogénea. No obstante, establecen que el enrutamiento alternativo, la mayor latencia, la congestión y la recuperación de capacidad por etapas fueron realidades operativas, no meros riesgos teóricos.[20][21]
6. La reparación fue un problema de logística y de evidencia
Localizar los fallos antes de repararlos
La reparación de cables submarinos comienza con conocimiento: ¿dónde ocurrió el fallo, qué parte del sistema está afectada y qué equipo y tipo de cable se requerirán? Las horas y lugares de rotura del estudio geológico procedían de informes asociados a operaciones de reparación.[4] Esa procedencia muestra la relación entre la localización operativa de fallos y la reconstrucción científica posterior, pero el registro disponible no contiene un conjunto completo de registros de alarma de operador ni mediciones ópticas en el dominio del tiempo para cada segmento.
Esa limitación importa. Una evaluación de rendición de cuentas debería distinguir la reconstrucción pública de la evidencia operativa que las operadoras y consorcios de cables tenían en su momento. Un registro de recuperación sólido conservaría la cronología de alarmas, los resultados de pruebas, las coordenadas estimadas del fallo, las actualizaciones a medida que la estimación mejoraba, la asignación de buques, la finalización de empalmes y la validación posterior a la reparación. Sin esos registros, los observadores externos a menudo solo pueden ver el hito final.
Buques, repuestos, clima y secuenciación
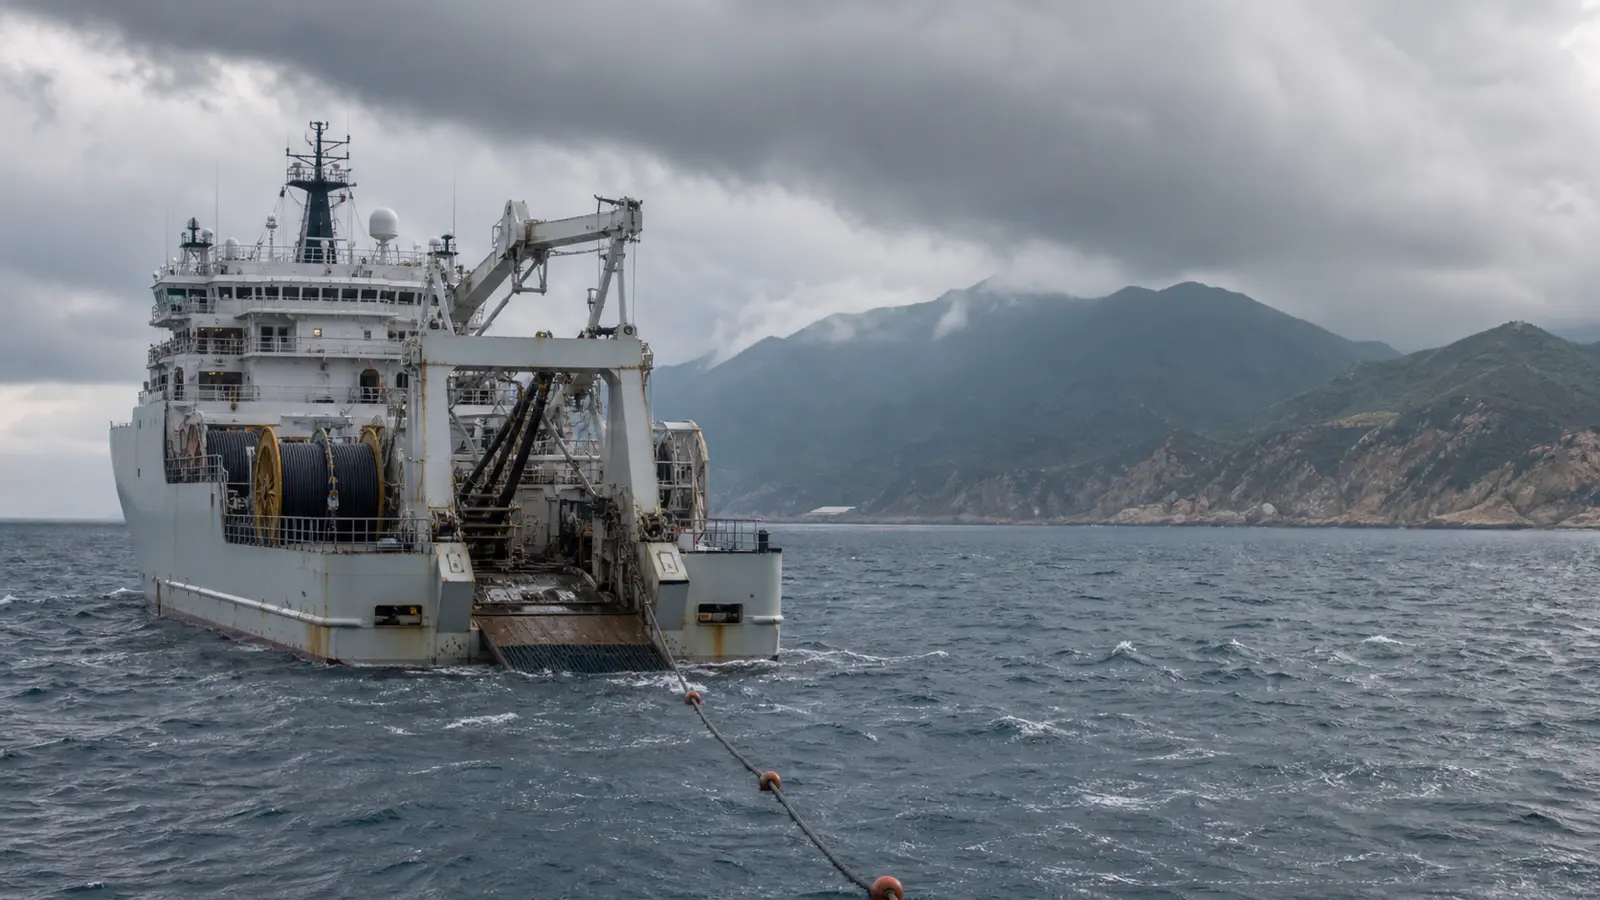
OFTA declaró que una reparación individual podía requerir normalmente de cinco a diez días, al tiempo que describía restricciones que afectaban al calendario de múltiples fallos. Entre ellas figuraban la disponibilidad de buques de reparación, la necesidad de cargar cantidades inusualmente grandes de cable y equipo, las existencias en distintos depósitos, el clima en alta mar y un problema técnico con un buque de reparación.[21]
Estas son restricciones regionales de reparación en el registro público de Hong Kong. No deben reescribirse como una lista de dificultades que Chunghwa encontró personalmente en cada cable. Su importancia es más amplia: la reparabilidad depende de una cadena de suministro y un sistema operativo que comienza mucho antes de que un buque llegue a un fallo.
Un plan de reparación creíble necesita por tanto evidencia sobre:
- contratos o acceso permanente a buques de cable adecuados;
- la ubicación y compatibilidad de cable de repuesto, repetidores y equipos de empalme;
- tiempo de movilización y carga;
- permisos y acuerdos de acceso;
- límites operativos por clima y estado del mar;
- reglas de prioridad cuando varios sistemas requieren los mismos recursos especializados;
- disponibilidad de tripulaciones cualificadas;
- precisión en la localización de fallos;
- y el proceso para confirmar que el segmento reparado puede volver al servicio.
En un evento correlacionado, estos recursos no pueden evaluarse cable por cable. Varios propietarios pueden necesitar buques, existencias de depósito y equipos especializados a la vez. Una norma de cinco a diez días para una reparación individual no implica que muchas reparaciones puedan completarse todas dentro de esa ventana. La secuenciación se convierte en una decisión de control.
El gobierno de Hong Kong esperaba que los sistemas volvieran progresivamente hacia finales de enero o mediados de febrero, sujeto a condiciones.[20][21] El lenguaje condicional es importante. Los calendarios de reparación marina son previsiones bajo incertidumbre, no plazos garantizados. La rendición de cuentas no exige fingir que el clima o las condiciones del lecho marino son controlables. Exige demostrar que las restricciones, prioridades y dependencias conocidas están identificadas y gestionadas.
La notificación pública fue en sí misma un control de continuidad
El relato de OFTA señaló que el mecanismo de notificación existente no exigía de forma rutinaria informes de interrupción de cables submarinos o de acceso a Internet.[21] Eso limitaba la imagen inmediata del regulador. Es un recordatorio de que la detección a nivel de operador y la conciencia situacional a nivel público son distintas.
Un operador puede detectar un fallo de cable inmediatamente mientras un regulador carece de una visión consolidada de cómo interactúan varios fallos. Los clientes pueden ver una congestión grave mientras una operadora informa de que la conectividad lógica permanece. Un consorcio puede conocer el calendario de reparación de un sistema mientras ninguna cuenta pública única conecta ese calendario con la restauración de capacidad en todas las rutas afectadas.
Los requisitos de notificación no pueden reparar un cable, pero pueden mejorar las decisiones coordinadas. Una notificación útil definiría la unidad afectada, el alcance del servicio, la capacidad restante, las rutas alternativas a un nivel seguro de abstracción, la etapa de reparación actual, las restricciones materiales y el siguiente hito de verificación. También debería separar las estimaciones de las acciones completadas.
7. El papel de Chunghwa Telecom es limitado, directo y medible
Chunghwa Telecom fue un operador taiwanés directamente afectado. La base más fiable de su papel es el formulario 20-F de 2006 presentado ante la Comisión de Bolsa y Valores de Estados Unidos.
La comunicación dice que el terremoto dañó significativamente las redes de cables submarinos que conectan Taiwán con Estados Unidos, Japón, Hong Kong, China y el sudeste asiático. Chunghwa afirma que tardó una semana en restaurar el noventa por ciento de la capacidad. Informa de que las reparaciones se completaron el 2 de febrero de 2007, cuando los cuatro cables submarinos afectados volvieron a funcionar con normalidad, y registra aproximadamente NT$10 millones en costes de reparación.[19]
Esos hechos respaldan varias afirmaciones precisas:
- Chunghwa tenía cuatro cables submarinos afectados dentro del alcance de su comunicación.
- Informó de un hito de capacidad del noventa por ciento tras una semana.
- Distinguió ese hito de la vuelta física final a la normalidad el 2 de febrero.
- Reveló una cifra de coste de reparación.
No revelan todas las rutas usadas durante el ínterin, la cantidad de capacidad no utilizada antes del evento, cada cambio de política de peering, la estructura de propiedad o arrendamiento de cada circuito, ni la prioridad asignada a cada cliente. La comunicación tampoco convierte a Chunghwa en propietaria de todos los fallos regionales.
Un informe posterior de APEC, que resume una presentación de Chinese Taipei, ofrece un segundo relato específico del operador. Atribuye nueve puntos de rotura en cuatro sistemas de cable a Chunghwa y dice que los servicios se restauraron en once días.[22] Esto solo puede notificarse como un resumen posterior atribuido. Utiliza una unidad y un hito distintos a los de la comunicación ante la SEC.
Los dos relatos no deben forzarse en una sola cronología:
- Nueve puntos de rotura en cuatro sistemasdescribe un recuento de fallos y alcance de activos atribuido.
- Noventa por ciento de capacidad tras una semanadescribe la recuperación de capacidad declarada por Chunghwa.
- Servicios restaurados en once díasdescribe el hito del relato posterior de APEC.
- Cuatro cables afectados normalizados el 2 de febrerodescribe la vuelta final a la normalidad en la comunicación ante la SEC.
La restauración de capacidad puede preceder a la normalización del servicio, y la restauración del servicio puede preceder a la finalización de todas las reparaciones marinas. El registro no afirma que los cuatro hitos se midieran de la misma manera. Preservar sus diferencias produce un artículo más sólido que elegir la cifra más rápida o más grande.
La evidencia específica de la empresa también establece el límite adecuado de rendición de cuentas. Se puede preguntar a Chunghwa qué evidencia de rutas, capacidad, fallos y reparación respaldaba sus hitos divulgados. No se le pueden asignar acciones específicas de Hong Kong solo porque ambos lugares se vieron afectados por el mismo evento regional. El registro público respalda una conexión directa con el incidente, no una inferencia ilimitada sobre todas las decisiones de respuesta.
8. Una prueba de rendición de cuentas basada en evidencia
El evento no respalda la propuesta de que los operadores deban evitar terremotos o garantizar un servicio ininterrumpido en todo desastre regional. Respalda una prueba más práctica: ¿qué evidencia mostró que los controles de continuidad estaban diseñados para fallos físicos correlacionados y seguían siendo utilizables bajo demanda real?
Prueba uno: geografía de rutas
Una afirmación de diversidad de rutas debe estar respaldada por evidencia geoespacial a la escala del riesgo. Para cables submarinos al sur de Taiwán, eso significa algo más que nombres de sistemas distintos o una separación lateral modesta. La evidencia debe mostrar cómo se relacionan las rutas con cabeceras de cañones, pendientes, vías de sedimentos, fosas, aproximaciones de amarre y fallos anteriores.
La reconstrucción de Hsu indica por qué. Cables repartidos en una banda de aproximadamente 150 kilómetros podían aun así encontrarse con riesgos de sedimentos conectados o repetidos.[4] Dos rutas pueden ser diversas frente al impacto de un ancla en una coordenada y, sin embargo, estar correlacionadas frente a un flujo de cañón desencadenado por un terremoto. La diversidad debe definirse en relación con el mecanismo de fallo que se gestiona.
La pregunta de control no es «¿Hay dos cables?». Es «¿Qué riesgo creíble puede eliminar ambos y qué ruta queda si lo hace?».
Prueba dos: capacidad de reserva utilizable
La capacidad instalada, la capacidad contratada, la capacidad iluminada y la capacidad inmediatamente disponible son distintas. Un plan de continuidad debe indicar cuánto tráfico puede moverse tras cada combinación de fallos relevante, con qué rapidez puede activarse capacidad adicional y qué servicios reciben prioridad cuando el total es insuficiente.
El evento mostró que BGP podía identificar alternativas mientras las conexiones seguían siendo deficientes y las rutas estrechas requerían cambios de política.[5] Eso significa que un anuncio de ruta era necesario pero no evidencia suficiente. La capacidad debe probarse mediante carga sostenida, no inferirse de la configuración.
La prueba también debe incluir la demanda en horas punta. Un respaldo que funciona en un ejercicio tranquilo puede fallar cuando todo un corredor regional desplaza tráfico. La evidencia debe mostrar margen, comportamiento de colas, pérdida de paquetes, latencia y rendimiento de aplicaciones bajo la carga de conmutación por error esperada.
Prueba tres: ejecución de peering, tránsito e ingeniería de tráfico
La capacidad alternativa solo es útil si el tráfico puede alcanzarla. Los operadores deben saber qué políticas deben cambiar cuando desaparecen las rutas principales, quién tiene autoridad para hacer esos cambios, qué protecciones evitan que el respaldo se sobrecargue y cómo se medirá el efecto.
Esto no implica que todo cambio de emergencia deba estar predefinido sin criterio. Significa que los prerrequisitos operativos deben conocerse. Las vías de contacto entre operadoras, los acuerdos comerciales de emergencia, las reglas de prioridad de tráfico y los criterios de reversión forman parte de la continuidad.
El énfasis del relato de IEICE en la colaboración entre operadores es especialmente relevante.[5] Los fallos interdominio cruzan fronteras organizativas. Ningún operador controla todos los anuncios, enlaces de tránsito, estaciones de amarre y redes de destino. La continuidad es en parte la capacidad de coordinarse sin confundir acción compartida con responsabilidad compartida.
Prueba cuatro: evidencia a nivel de servicio
«Alcanzable» y «restaurado» deben desglosarse en estados de servicio medibles. El registro de Hong Kong muestra que la voz, la itinerancia, Internet general y las aplicaciones en tiempo real se recuperaron de forma distinta.[21] Un programa serio de continuidad debe definir umbrales aceptables para cada servicio importante.
La evidencia podría incluir estabilidad de rutas, latencia de extremo a extremo, pérdida, rendimiento, tasas de transacciones exitosas y medidas de impacto en el cliente. Las métricas concretas variarán, pero sus definiciones deben fijarse antes de un incidente. De lo contrario, un proveedor puede elegir sin querer el indicador que parezca más sano durante la recuperación.
Prueba cinco: localización y notificación de fallos
Los fallos secuenciales requieren una imagen de daños continuamente actualizada. Operadores y consorcios necesitan una cronología de alarmas, evidencia de localización y niveles de confianza. Los reguladores y grandes clientes necesitan un resumen público o contractual que distinga fallos confirmados, fallos sospechados, impacto en el servicio y etapas de reparación esperadas.
El registro público del evento se reunió a partir de distintas fuentes científicas, empresariales y regulatorias. Ese mosaico es informativo, pero también revela la ausencia de un relato regional normalizado e inmediato. Una mejor notificación no eliminaría la incertidumbre; la haría legible.
Prueba seis: acceso de reparación ejecutable
Un compromiso de reparación en papel no es lo mismo que acceso a un buque, repuestos compatibles y una secuencia viable. El registro de OFTA muestra cómo la disponibilidad, la carga, la ubicación de depósitos, el clima y la fiabilidad del buque pueden prolongar la recuperación.[21] Son dependencias operativas que deben tener responsables y evidencia.
La preparación para la reparación debe ejercitarse en la medida posible sin interrupciones innecesarias. Se pueden comprobar contratos, inventariar repuestos, probar supuestos de movilización, confirmar contactos de escalado y documentar derechos de decisión. El objetivo no es prometer un mar en calma, sino evitar descubrir una restricción administrativa o de suministro evitable después de que varios cables ya estén caídos.
Prueba siete: hitos de recuperación conciliables
Los registros de Chunghwa y Hong Kong contienen varios hitos legítimos pero distintos: recuperación de voz, porcentaje de capacidad, servicios restaurados, sistemas de cable normalizados y reparaciones físicas completadas.[19][21][22] Un informe de continuidad debe declarar cuál utiliza.
La conciliación debe responder:
- ¿Cuál era el denominador?
- ¿Era la medida capacidad, tráfico, clientes, servicios o activos físicos?
- ¿Se midió en demanda pico o media?
- ¿Cubría un operador, una jurisdicción o la región?
- ¿Se refería «normal» al enrutamiento, a la calidad de las aplicaciones o a la reparación marina completada?
- ¿Qué evidencia confirmó el hito?
Este enfoque evita tanto la exageración como la injusticia. No descarta la recuperación parcial porque la reparación final tardó más. Impide que la recuperación parcial se presente como restauración completa.
9. La orientación posterior es un marco de control, no un veredicto retroactivo
Los materiales publicados después de 2006 ayudan a organizar estas pruebas. Deben usarse de forma prospectiva y analítica.
El material del ICPC y el PNUMA analiza los cables submarinos como infraestructura crítica y aborda la planificación de rutas, las condiciones del lecho marino, los riesgos y la reparación.[8][9] Investigaciones posteriores sobre riesgo de desastres ofrecen un marco más amplio para cuellos de botella de infraestructura y exposición correlacionada.[7] El trabajo actual de la UIT destaca la importancia y la resiliencia de los sistemas de cables submarinos, mientras que publicaciones posteriores de la UIT-T proporcionan orientación sobre diseño y características del sistema.[10][11][12][13] El material de APEC alojado por la NCC de Taiwán y el
informe posterior de APEC utilizan el incidente para discutir la cooperación internacional, la reparación y las lecciones de resiliencia.[14][22]
En conjunto, estas fuentes respaldan un marco de control actual:
- estudiar las rutas en relación con la batimetría, los sedimentos y los riesgos geológicos conocidos;
- examinar si distintos sistemas comparten un corredor de fallos;
- planificar el acceso a buques de reparación especializados y repuestos compatibles;
- establecer procedimientos de cooperación entre operadores y jurisdicciones;
- probar la capacidad y el enrutamiento bajo fallos correlacionados;
- y notificar la restauración en etapas claramente definidas.
No establecen qué sabía, financiaba, contrataba o desplegaba Chunghwa o cualquier otro operador en diciembre de 2006. No prueban que una recomendación posterior fuera un requisito legal aplicable en su momento. No convierten un desastre natural en evidencia de negligencia.
Este límite temporal importa para un análisis justo. Las buenas prácticas se desarrollan en parte porque los incidentes revelan dependencias antes subestimadas. Una norma posterior puede mostrar cómo enmarca ahora la industria el riesgo sin resolver qué era razonablemente previsible, técnicamente factible o contractualmente controlable dos décadas antes.
El uso más fuerte de la orientación posterior es, por tanto, probatorio, no acusatorio. Ayuda a especificar qué documentos y resultados de pruebas debería poder producir hoy un operador: estudios de riesgo de rutas, análisis de diversidad, pruebas de capacidad de conmutación por error, manuales de interconexión, registros de acceso a reparación y conciliación posterior al incidente. Si esos registros existen, pueden demostrar preparación para la continuidad. Si no existen, la brecha es visible sin inventar una infracción histórica.
10. Una reproducción BGP futura podría añadir precisión, pero no omnisciencia
La existencia de Route Views, RIPE RIS y BGPStream significa que un investigador posterior podría realizar una reproducción histórica acotada utilizando actualizaciones BGP archivadas.[15][16][17] El RFC 4271 proporciona la base del protocolo para interpretar anuncios, retiros e información de enrutamiento.[18] La investigación sobre análisis BGP relacionado con desastres puede ayudar a definir ventanas y comparar vistas de tablas de enrutamiento y de actualizaciones.[6][24]
Un estudio defendible tendría que declarar:
- los colectores y pares incluidos;
- los prefijos o sistemas autónomos examinados;
- el período de referencia;
- la ventana del evento;
- el método para separar la rotación ordinaria del cambio vinculado al evento;
- las interrupciones de colectores o brechas de visibilidad;
- la diferencia entre un cambio visible en el plano de control y un resultado de reenvío;
- y los límites de generalizar a partir de puntos de observación seleccionados.
Podría entonces preguntar si redes seleccionadas mostraron retiros inusuales, cambios de longitud de ruta, proveedores ascendentes alternativos o estabilidad de ruta retrasada en torno a la secuencia de fallos de cable. Podría comparar la primera sacudida, la segunda sacudida y los tiempos de fallo posteriores en lugar de tratar el evento como un instante.
Incluso una reproducción cuidadosa no mediría directamente el ancho de banda de reserva. Las actualizaciones BGP describen información de enrutamiento, no la carga transportada por una ruta. No revelan por sí mismas congestión, pérdida de paquetes ni calidad de aplicación. Esas preguntas requieren evidencia de tráfico, rendimiento o servicio.
La reproducción tampoco asignaría responsabilidad automáticamente. Un cambio de ruta visible en un colector puede ser la consecuencia racional de un fallo físico, una acción de política protectora o una respuesta descendente. Los datos pueden aclarar el comportamiento; el contexto organizativo y técnico sigue siendo necesario para interpretar el control.
Según la evidencia revisada aquí, la conclusión correcta es simplemente que tal reproducción es posible y no se ha presentado. Ese límite preserva espacio para evidencia futura sin convertir la disponibilidad de archivos en una afirmación sobre resultados.
11. El relato causal tiene límites
La cadena respaldada puede enunciarse sin colapsar sus partes.
Eventos desencadenantes:los dos terremotos principales en alta mar de Pingtung/Hengchun y las réplicas asociadas.
Mecanismo físico próximo inferido:deslizamientos submarinos vinculados al terremoto, desplomes de sedimentos y corrientes de turbidez que ejercieron fuerza destructiva sobre los cables y produjeron fallos a lo largo de rutas de cañones y fosas.[4][23]
Condiciones de infraestructura contribuyentes:varios sistemas compartiendo un corredor de riesgo concentrado; ancho de banda alternativo utilizable limitado; dependencias de enlace único; rutas de respaldo más largas; y recursos de reparación limitados por buques, repuestos, clima y coordinación.[5][20][21]
Respuesta observada:desvíos automáticos de enrutamiento, cambios de ingeniería de tráfico, adquisición o uso de capacidad regional e intercontinental alternativa, recuperación escalonada del servicio y reparación marina progresiva.[5][20][21]
Evidencia específica del operador:el impacto divulgado por Chunghwa de cuatro cables, el hito de capacidad del noventa por ciento en una semana, la vuelta a la normalidad el 2 de febrero y el coste de reparación, más el relato APEC posterior atribuido de nueve puntos de rotura en cuatro sistemas y restauración del servicio en once días.[19][22]
Esta cadena respalda el escrutinio de los controles de continuidad. No establece:
- la contribución exacta de cada sacudida, réplica, deslizamiento o flujo a cada fallo;
- la topología completa de propiedad y arrendamiento;
- el cálculo de la capacidad de reserva de cada operador;
- un cambio concreto de política de enrutamiento de Chunghwa;
- la experiencia de servicio de cada usuario;
- la pérdida económica regional total;
- la responsabilidad contractual de cada interrupción;
- ni una conclusión jurídica sobre negligencia.
Estas incógnitas no son motivo para abandonar el análisis. Definen qué tipo de conclusión puede soportar la evidencia. El caso respalda una constatación de exposición correlacionada y continuidad utilizable restringida, no una asignación universal de culpa.
12. Evidencia que debería cambiar la conclusión
Un análisis sólido de rendición de cuentas debe identificar qué podría demostrar que está equivocado. La conclusión debería revisarse si evidencia más sólida altera materialmente cualquiera de sus vínculos centrales.
Estudios de ruta contemporáneos detallados podrían mostrar que los sistemas afectados eran geológicamente más independientes de lo que sugiere la reconstrucción publicada del corredor. Los registros de capacidad e ingeniería de tráfico podrían mostrar amplio ancho de banda alternativo no utilizado sin congestión material vinculada a los fallos. Los registros de pruebas ópticas, estudios marinos o registros de reparación podrían anular la secuencia de roturas publicada o la explicación de flujos de sedimentos.
Una reproducción de enrutamiento reproducible podría contradecir la narrativa general de desvío y degradación para las redes examinadas. Los registros de la empresa podrían entrar en conflicto material con la comunicación de Chunghwa o el relato APEC atribuido. Los contratos y registros de despacho podrían mostrar que otra parte controlaba exclusivamente una decisión relevante de reparación o continuidad.
Esa evidencia no solo añadiría detalle; podría alterar la tesis. La tesis depende de la geografía de rutas, la exposición a riesgos comunes, la capacidad alternativa utilizable, la continuidad de peering y tránsito, la localización de fallos y la reparación ejecutable. Si esos elementos se eliminan o refutan, lo que queda es una cronología de desastre natural, no un caso de rendición de cuentas de red.
Esta regla de revisión es importante porque las narrativas de infraestructura pueden quedar fijadas tras un evento dramático. Las cifras adquieren vida propia y la orientación posterior se lee retrospectivamente en la conducta anterior. Una declaración transparente de evidencia refutadora mantiene el análisis conectado con la realidad.
Conclusión
El evento de Hengchun de 2006 no demostró que la redundancia fuera inútil. Demostró que la redundancia tiene varias capas y que cada capa necesita evidencia.
El doblete sísmico fue seguido de una secuencia de fallos de cable asociados en la investigación publicada a deslizamientos y flujos de sedimentos en movimiento. Varios sistemas ocuparon un corredor de riesgo regional común. Los desvíos BGP ayudaron a recuperar la accesibilidad, pero no pudieron crear capacidad en rutas alternativas estrechas o más largas. Operadores y reguladores describieron congestión, recuperación diferenciada del servicio y un calendario de reparación condicionado por buques, equipos, depósitos, clima y coordinación.
La propia comunicación de Chunghwa documentó un hito de capacidad de una semana y una vuelta final a la normalidad de cuatro cables afectados, mientras que un relato APEC posterior registró una medida distinta de puntos de rotura y restauración del servicio.[4][5][19][20][21][22][23]
La prueba de rendición de cuentas resultante es concreta. Demuestre que las rutas alternativas son diversas frente al riesgo físico relevante. Demuestre que tienen capacidad utilizable bajo demanda máxima desplazada. Demuestre que las políticas de peering y tránsito pueden alcanzarlas sin crear un nuevo cuello de botella. Demuestre que los fallos pueden localizarse y notificarse. Demuestre que el acceso a reparación, los repuestos y la secuenciación son ejecutables. Defina hitos de recuperación para que capacidad, servicio y reparación física no se confundan.
Es un estándar exigente, pero no es una acusación de que un operador deba controlar el lecho marino. Es una petición de evidencia de que las afirmaciones de continuidad sobreviven al contacto con la geografía, las redes en funcionamiento y el trabajo práctico de recuperación.
Fuentes
- https://earthquake.usgs.gov/earthquakes/eventpage/usp000f114
- https://earthquake.usgs.gov/product/poster/20061226/us/1461770326906/poster.pdf
- https://www.usgs.gov/publications/strong-motion-data-two-pingtung-taiwan-earthquakes-26-december-2006
- https://tecdc.earth.sinica.edu.tw/data/EQ2006Pingtung/full_article/18-PT022.pdf
- https://doi.org/10.1093/ietcom/e90-b.11.3095
- https://link.springer.com/chapter/10.1007/978-3-642-40588-4_18
- https://nhess.copernicus.org/articles/9/605/2009/
- https://www.iscpc.org/publications/icpc-unep_report.pdf
- https://resources.unep-wcmc.org/products/WCMC_RT059
- https://www.itu.int/en/ITU-T/Workshops-and-Seminars/qos/20240304/Documents/4-Alexandre%20Nheve.pdf
- https://www.itu.int/digital-resilience/submarine-cables/
- https://www.itu.int/epublications/publication/itu-t-g-suppl-41-2024-07-design-guidelines-for-optical-fibre-submarine-cable-systems
- https://www.itu.int/epublications/publication/itu-t-g-971-2024-12-general-features-of-optical-fibre-submarine-cable-systems
- https://www.ncc.gov.tw/english/files/08091/144_080915_1_C.PDF
- https://archive.routeviews.org/bgpdata/2006.12/UPDATES/
- https://www.ripe.net/analyse/internet-measurements/routing-information-service-ris/
- https://bgpstream.caida.org/
- https://www.rfc-editor.org/rfc/rfc4271
- https://www.sec.gov/Archives/edgar/data/1132924/000119312507087241/d20f.htm
- https://www.info.gov.hk/gia/general/200701/24/P200701240164.htm
- https://www.legco.gov.hk/yr06-07/english/panels/itb/papers/itb0115cb1-697-1-e.pdf
- https://www.apec.org/apecapi/publication/getfile?publicationId=6a8fa3a5-aaba-4cd8-8d33-3fd818572a88
- https://tos.org/oceanography/article/insights-into-submarine-geohazards-from-breaks-in-subsea-telecommunicationc
- https://www.ipccc.org/ipccc2015/Proceedings/data/polopoly_fs/1.2779312.1448299559%21/fileserver/file/572409/filename/Session06_01.pdf
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance