
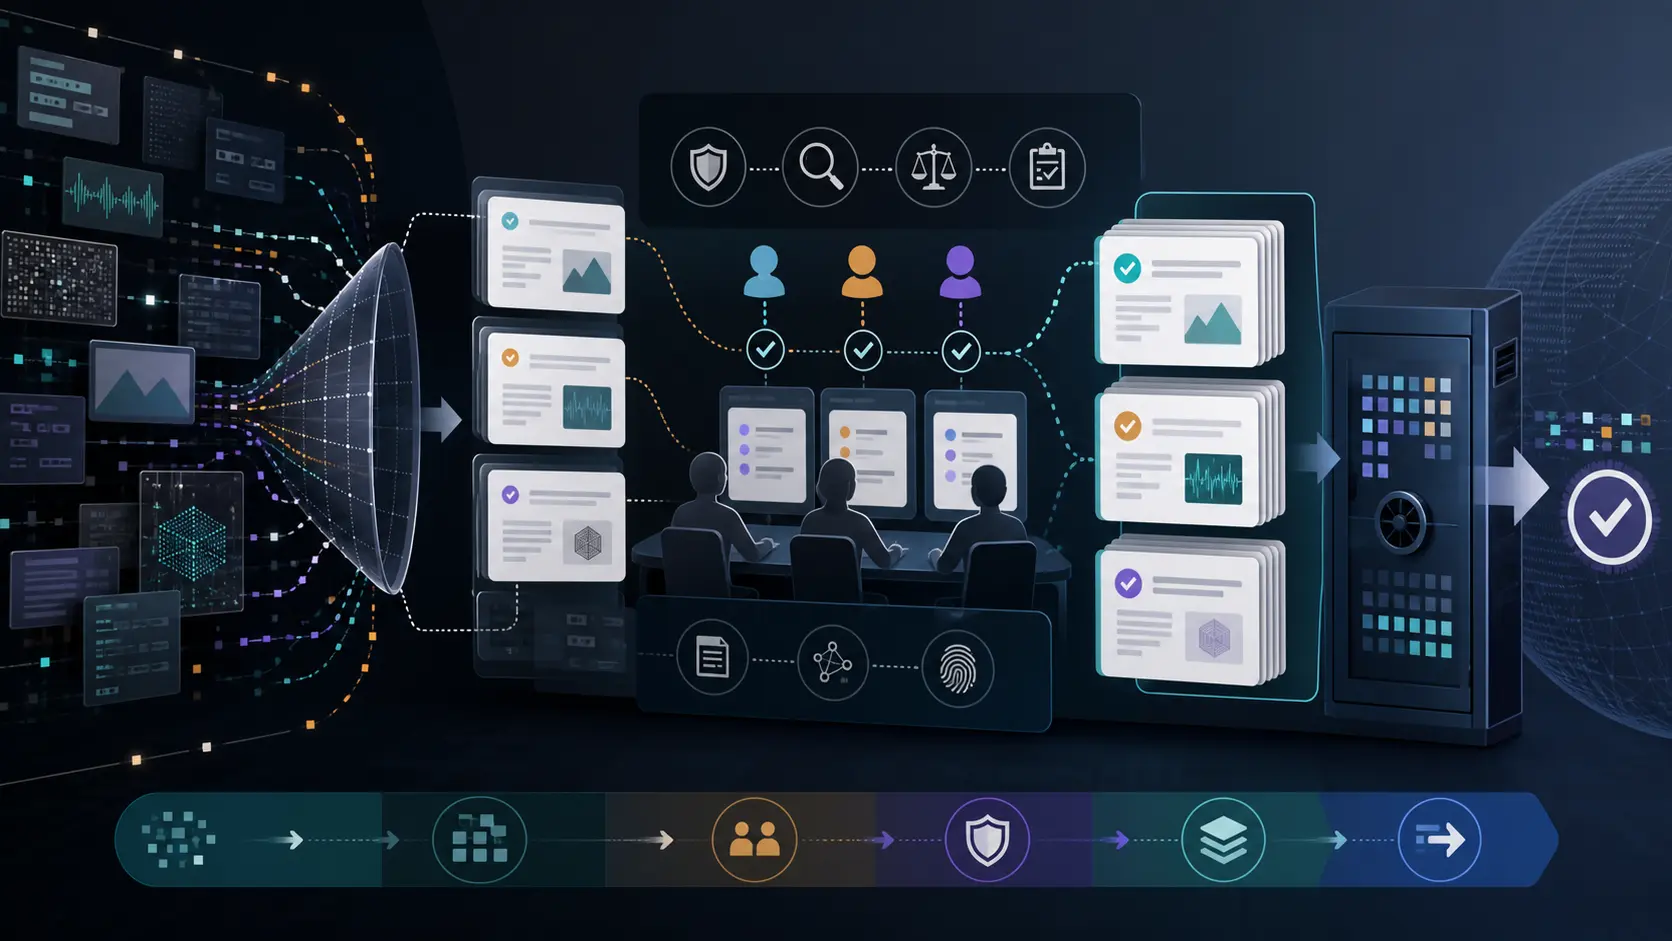
Zusammenfassung
- Scale AI sollte an der akzeptierten Daten- oder Bewertungseinheit gemessen werden: einem Task, einer Zeile, einem Label, einem Review-Ergebnis oder einem Modellbewertungs-Datensatz, dem ein Käufer ausreichend vertrauen kann, um darauf zu trainieren, damit zu bewerten, ihn zu exportieren, zu prüfen und wiederzuverwenden.
- Die öffentliche Produktoberfläche von Scale verfügt über die richtigen Grundbausteine für diese Aufgabe: Projekte, Tasks, Batches, Taxonomien, Callbacks, Prüfstatus, Trennung der Prüfer, Dashboards, Traces, Speicherintegrationen und sichere Bereitstellungsoptionen. Diese Grundbausteine machen Qualität beherrschbar, aber nicht automatisch.
- Die größten Risiken sind nicht Markenrisiken. Es sind mehrdeutige Anweisungen, geringe Übereinstimmung der Prüfer, Benchmark-Leckage, schwache Herkunft, Fehler bei Speicherberechtigungen, Einschränkungen der Datenlokalität, veraltete Bewertungssätze, Overfitting auf den Test, Nacharbeitsschleifen und die Kosten, Menschen und automatische Prüfer in Einklang zu halten.
- Käufer sollten Scale mit manueller Überprüfung, internen Datenoperationen, Tools von Modellanbietern, Open-Source-Bewertungsstapeln und dem Verzicht auf einen Teil der Aufgabe vergleichen, indem sie Kosten pro akzeptierter Einheit, Nacharbeitsrate, Prüferabweichung, Vollständigkeit der Herkunft, Sicherheitskonfiguration, marginale Modellverbesserung und die Wechselkosten messen.
Die akzeptierte Einheit ist das Produkt
Scale AI sitzt im am wenigsten theatralischen Teil des KI-Stack. Seine Arbeit liegt vor der Modell-Demo und nach dem Rohdaten-Dump. Es ist der Ort, an dem ein Bild, ein Dokument, ein Gespräch, eine Code-Antwort, eine Reasoning-Spur, ein Sicherheitsszenario oder ein Betriebsdatensatz zu etwas wird, auf das ein Modellteam trainieren oder gegen das es bewerten kann. Die öffentliche Erzählung lässt dies oft wie ein Skalenproblem klingen: mehr Annotatoren, mehr Labels, mehr Tasks, mehr Unternehmens- und Regierungsnachfrage. Die Produktionsgeschichte ist enger und schwieriger.
Ein Käufer benötigt eine Einheit des Nachweises, die akzeptiert werden kann.
Eine akzeptierte Einheit ist nicht nur ein Label. Es ist ein Datensatz mit einem Existenzgrund, einem Anweisungssatz, einer Taxonomie, einem Prüferpfad, einer Herkunftsspur, einem exportierbaren Ergebnis und genügend Kontext, damit ein anderes Team verstehen kann, warum es ein Modell beeinflussen sollte. In derAufgabendokumentationvon Scale ist ein Task die individuelle Arbeitseinheit, die einem zu kennzeichnenden Datenstück zugeordnet ist. In derDokumentation der Schlüsselkonzepteorganisieren Projekte Tasks, Batches gruppieren Tasks, und abgeschlossene Tasks liefern strukturierte Antworten. Das ist der richtige Nenner zur Bewertung von Scale, weil er klein genug für eine Inspektion und groß genug ist, um bei wiederholter Anwendung in Millionen von Fällen relevant zu sein.
Dieselbe Logik gilt für die Bewertung. Eine Modellpunktzahl ist nur so nützlich wie die Beispiele, Rubriken, Prüfer und Stichprobenregeln, die sie hervorgebracht haben. DieBewertungsseite für Modellentwicklervon Scale stellt das Problem als Mangel an hochwertigen, vertrauenswürdigen Bewertungsdatensätzen und Konsistenz in der Berichterstattung dar und warnt gleichzeitig vor Risiken wie Fehlinformationen, Privatsphäre, Verzerrung, Cyber-Missbrauch und gefährlichen Substanzen. Diese Produktbehauptung ist wichtig, weil sie das eigentliche Problem des Käufers benennt: nicht ob ein Modell einmal einen Benchmark schlagen kann, sondern ob eine Organisation die richtige Verhaltensweise kontinuierlich bewerten kann, ohne die Antworten preiszugeben, auf den Test zu trainieren oder die Konsistenz der Bewerter im Laufe der Zeit zu verlieren.
Aus diesem Grund ist die nützliche Frage nicht, ob Scale Datenoperationen hat, ob es ein großes Beitragendennetzwerk hat oder ob ein Kunde es genutzt hat. Die nützliche Frage ist, ob Scale einem Käufer hilft, Unsicherheit zu akzeptierten Nachweisen zu geringeren Gesamtkosten als Alternativen zu machen. Ein rohes Beispiel kann mehrdeutig sein. Eine Richtlinie kann sich ändern. Zwei Prüfer können anderer Meinung sein. Ein Modell kann bei einfachen Fällen besser werden, während es bei den wichtigen Randfällen versagt. Ein automatischer Prüfer kann eher zu einer Quelle der Verzerrung als zu einer Abkürzung werden.
Eine Speicherberechtigung kann während des Uploads bequem und während des Exports gefährlich sein. Ein Batch kann vollständig erscheinen, während das nächste Team die Grundlage für die Akzeptanz nicht reproduzieren kann.
Die akzeptierte Einheit trennt auch drei Schichten, die normalerweise vermischt werden. Die Modellfähigkeit ist das, was das Modell des Kunden kann. Die Produktzuverlässigkeit ist, ob Scales Werkzeuge, Prüfer, APIs, Dashboards und Bereitstellungsoptionen Nachweise vorhersagbar verarbeiten können. Das Produktionsergebnis des Kunden ist, ob sich die reale Aufgabe des Käufers nach Aufsicht, Integration, Überprüfung, Ausnahmebehandlung, Speicherung, Sicherheit und Wechselkosten verbessert. Scale kann die zweite Schicht liefern und die dritte beeinflussen. Es besitzt nicht jedes Kundenergebnis des Modells.
Diese Grenze ist wichtig für die bestehende Scale AI Directory Entität. Scale AI ist das Unternehmen, das hier bewertet wird, zusammen mit von Scale betriebenen Oberflächen wieData Engine,Generative AI Data Engine, Scale Evaluation,GenAI PlatformundDonovan. Der Artikel ist kein Urteil über jedes mit Scale-Daten trainierte Modell, jedes Regierungsprogramm, das Scale nennt, jede Kundenanwendung, die auf einem Modellanbieter aufsetzt, oder jede arbeitsmarktbezogene Behauptung über Datenarbeit. Diese können für das Vertrauen des Käufers relevant sein, sind aber nicht der zentrale technische Nenner.
Der zentrale Nenner ist die akzeptierte Trainings- oder Bewertungsdateneinheit. Wenn diese Einheit zuverlässig ist, kann Scale zu einer Infrastruktur werden. Wenn nicht, wird Scale zu einem teuren Task-Routing.
Scale verkauft eine Wiederholungsschleife, kein fertiges Modell
Die stärkste öffentliche Produkterzählung von Scale ist eine Schleife. DieData Engine-Seitebeschreibt den Zyklus als Sammeln, Kuratieren und Annotieren von Daten, dann Training und Bewertung von Modellen, dann Wiederholung. DieGenerative AI Data Engine-Seiteerweitert diese Geschichte um maßgeschneiderte Datensätze, Überprüfung durch Fachexperten, RLHF, Modellbewertung, Red-Teaming und Sicherheitsarbeit. Die Schleife ist wichtig, weil eine nützliche Modellentwicklung selten mit einem Datensatz endet. Ein Modell versagt auf neue Weise, ein Käufer fügt eine neue Richtlinie hinzu, ein Randfall tritt in der Produktion auf, eine Regulierungsbehörde fordert Nachweise, ein Kundensegment ändert sich, oder ein Modellanbieter veröffentlicht eine neue Version. Dann muss der Daten- und Bewertungsprozess erneut durchlaufen werden.
Für Käufer ist diese Wiederholungsschleife sowohl der Grund, Scale in Betracht zu ziehen, als auch der Grund, vorsichtig zu sein. Ein einmaliges Kennzeichnungsprojekt kann wie eine Dienstleistungsbeziehung verwaltet werden. Eine Wiederholungsschleife wird zu einer Betriebsinfrastruktur. Sobald das Modellteam eines Käufers von einem Anbieter für Taxonomien, Prüfprozesse, Beitragendenpools, Bewertungs-Dashboards, Red-Team-Fälle, Speicherintegrationen und Exporte abhängt, ist der Anbieter nicht mehr nur ein Auftragsverarbeiter. Er formt, was die Organisation des Käufers als Nachweis zählt.
Scales Dokumentation hat reale Mechanismen hinter dieser Behauptung. Projekte sind mit einem Anwendungsfall und Anweisungen verknüpft. DieProjektverwaltungsdokumentationbesagt, dass Tasks in einem Projekt dieselben Anweisungen teilen sollten und dass wesentliche Änderungen der Anweisungen ein neues Projekt erstellen sollten. Das ist eine kleine, aber wichtige Einschränkung. Sie erkennt an, dass Änderungen der Anweisungen die Bedeutung eines Labels verändern. Wenn ein Team die Definition einer schädlichen Antwort, eines gültigen Steuerdokuments, einer Fahrbahnmarkierung, eines klinisch relevanten Symptoms oder eines erfolgreichen Tool-Aufrufs mitten in einem Datensatz bearbeitet, sind die resultierenden Beispiele möglicherweise nicht mehr vergleichbar. Eine neue Projektsrenze kann die Bedeutung bewahren.
Batches fügen eine weitere Betriebsebene hinzu. DieBatches-APIermöglicht es Teams, Batches innerhalb von Projekten zu erstellen, Callbacks zu setzen, den Status abzurufen und Tasks nach Zustand gruppiert zu zählen. Sie stellt auch fest, dass die Priorisierung noch nicht gestartete Tasks betrifft und die Reihenfolge der Fertigstellung nicht garantiert. Diese Einschränkung ist nützlich, weil Produktionskäufer oft annehmen, dass sich die Warteschlange eines Anbieters wie ein interner Job-Scheduler verhält. Das ist möglicherweise nicht der Fall. Wenn ein dringender Satz von Beispielen benötigt wird, um einen Live-Modellfehler zu diagnostizieren, muss der Käufer wissen, was die Priorität versprechen kann und was nicht.
Callbacks machen die Einheit betriebsbereit. DieCallback-Dokumentationbeschreibt JSON-Ergebnisse, die an die Endpunkte des Käufers gesendet werden, Wiederholungsverhalten, wenn keine erfolgreiche Antwort zurückgegeben wird, und Ereignisse für Task-Abschluss, Prüfstatusänderungen und zurückgerufene Tasks. Ein Callback ist keine glamouröse Funktion, aber er ist der Unterschied zwischen einem Web-Konsolen-Projekt und einem System, das in den Freigabeprozess eines Käufers eingebunden werden kann. Wenn ein abgeschlossener Task mit dem richtigen Status, der richtigen Antwort und dem richtigen Prüfstatus eintrifft, kann das Modellteam nachgelagerte Validierung, Export, Training oder Überprüfung auslösen. Wenn Callbacks stillschweigend fehlschlagen oder nicht ordnungsgemäß authentifiziert und überwacht werden, können akzeptierte Einheiten zwischen Teams verloren gehen.
Scales kommerzielles Argument hängt daher davon ab, dass die Schleife billiger und vertrauenswürdiger ist als die Alternativen des Käufers. Die Alternativen sind nicht imaginär. Ein großes KI-Labor kann seinen eigenen Datenbetrieb aufbauen. Ein Unternehmen kann Domänenprüfer einstellen und einen leichteren internen Prozess betreiben. Ein Cloud- oder Modellanbieter kann Bewertungstools nahe der Modell-API anbieten. Open-Source-Bewertungsframeworks können einen Teil der Aufgabe abdecken.
Ein Team kann den Arbeitsaufwand reduzieren, indem es das Produkt eingrenzt, ein kleineres Modell wählt, risikoreiche Automatisierung vermeidet oder menschliche Genehmigung nur für weniger Aktionen verwendet. Scale gewinnt nur, wenn seine Schleife bessere akzeptierte Einheiten pro Dollar und pro Woche produziert als diese Alternativen.
Der Käufer sollte der Versuchung widerstehen, die Schleife allein am Volumen zu messen. Mehr abgeschlossene Tasks ist nicht gleichbedeutend mit mehr nützlichen Nachweisen. Wenn die falsche Taxonomie verwendet wird, ist die Ausgabe präziser Abfall. Wenn Prüfer anderer Meinung sind, aber die Meinungsverschiedenheit verborgen bleibt, ist das Ergebnis falsche Gewissheit. Wenn Randfälle unterrepräsentiert sind, kann sich das Modell im Durchschnitt verbessern, während es genau in den Situationen versagt, die das Projekt rechtfertigen.
Wenn ein Bewertungssatz dem Modellentwicklungsteam vertraut wird, kann sich die Punktzahl verbessern, während sich das Verhalten in der realen Welt nicht verbessert. Volumen ist nur nützlich, wenn die Akzeptanz sinnvoll ist.
Menschliche Übereinstimmung ist die knappe Ressource
Der schwierigste Teil von Scales Produkt ist nicht das Bewegen von Daten durch eine API. Es ist die Ausrichtung von Menschen und Modellen auf strittige Urteile. Viele Trainings- und Bewertungsaufgaben sind nur in Beispielen einfach. Ein Prüfer kann ein Stoppschild in einem klaren Bild identifizieren, aber Modellfehler häufen sich normalerweise an den Rändern: Okklusion, Sensorrauschen, Sarkasmus, lokaler Kontext, mehrdeutige Absicht, ressourcenarme Sprache, Richtlinienkonflikte, unvollständige Dokumente, gemischte Sicherheitssignale oder Beispiele, bei denen die richtige Antwort von einer internen Regel des Kunden abhängt.
Je wirtschaftlich wertvoller das Modellverhalten ist, desto wahrscheinlicher erfordert der Nachweis ein Urteil und keine Transkription.
Scales öffentliche Dokumentation zeigt, dass es die Überprüfung als mehrstufigen Prozess versteht. In derDokumentation zur Kennzeichnungsbewertungseiner GenAI Platform können menschliche Annotatoren an zugewiesenen Tasks arbeiten, Labels werden gespeichert, unsichere Elemente können übersprungen werden, und Tasks können mit Kommentaren zur Überprüfung markiert werden. In derAudit-Dokumentationkönnen Bewertungsprozesse zwei Audit-Stufen haben, und der Labeler, der erste und der zweite Auditor müssen verschiedene Personen sein. Auditoren können genehmigen, eine Überarbeitung anfordern oder den Task korrigieren.
Diese Designentscheidungen sind wichtig. Die Trennung der Prüfer reduziert das Risiko, dass das Missverständnis einer Person zur endgültigen Antwort wird. Das Markieren unsicherer Tasks gibt Prüfern einen Weg, Mehrdeutigkeit zu bewahren, anstatt jedes Beispiel in eine falsche Binärentscheidung zu zwingen. Überarbeitungsanfragen schaffen einen Datensatz, dass der erste Durchlauf nicht akzeptiert wurde. Metriken für Beitragende und Auditoren können helfen zu identifizieren, ob ein Prüfer ungewöhnlich nachsichtig, ungewöhnlich streng oder inkonsistent ist. Diese sind nicht ausreichend, aber sie sind die richtige Art von Grundbausteinen.
Der Käufer muss trotzdem fragen, ob die Grundbausteine gut genutzt werden. Ein zweistufiger Audit-Prozess kann zu einem Gummistempel werden, wenn Prüfer unter Zeitdruck stehen, unzureichend geschult sind oder auf Durchsatz optimieren. Metriken für Beitragende können oberflächliche Zustimmung fördern, wenn das Ziel zu eng ist. Eine Überspring-Option kann die Qualität schützen oder ein Weg sein, schwierige Fälle zu vermeiden. Ein zweiter Auditor kann das Urteil verbessern oder Kosten hinzufügen, ohne das Ergebnis zu ändern, wenn die Rubrik schlecht ist.
Die Produktoberfläche kann Qualität unterstützen; sie kann die Wahrheit des Kunden nicht definieren.
Deshalb müssen Akzeptanzkriterien festgelegt werden, bevor das Volumen wächst. Käufer sollten definieren, was als Zustimmung zählt, welche Arten von Uneinigkeit akzeptabel sind, welche Beispiele eine Eskalation erfordern, welche Nachweise ein Prüfer erbringen muss, wie oft Goldstandard- oder fachlich geprüfte Beispiele eingefügt werden, wann eine Taxonomie überarbeitet wird und wie alte Labels migriert werden, wenn sich die Richtlinie ändert.
Sie sollten nicht nur die endgültige Akzeptanzrate messen, sondern auch die Ablehnung im ersten Durchlauf, die Häufigkeit von Überarbeitungen, die Uneinigkeit zwischen Prüfern, die Kategorien übersprungener Tasks, die Zeit zur Lösung strittiger Beispiele und die Modellauswirkung nach Verwendung der akzeptierten Einheiten.
ScalesDokumentation zu Fixless Auditsist hier nützlich, weil sie Feedback als strukturierte Daten und nicht nur als Kommentar behandelt. Sie dokumentiert Feedback-Bereich, Schweregrad, Status, akzeptierte oder abgelehnte Ergebnisse und Berechnungsregeln für Qualitätspunkte. DiePro Qualitätsdokumentationzeigt Approve-, Change- und Reject-Pfade und berichtet über Prüfungssummen, ergebnisse auf Task-Ebene und prüferbezogene Informationen. Das sagt dem Käufer nicht, dass die resultierenden Labels gut sind. Es sagt dem Käufer, wo er Nachweise verlangen sollte.
Die Gefahr ist falscher Konsens. Wenn eine Aufgabe einfach ist, stimmen die Prüfer überein. Wenn eine Rubrik vage ist, können Prüfer auch übereinstimmen, weil sie aus Beispielen dieselbe Abkürzung ableiten, anstatt die beabsichtigte Regel anzuwenden. Wenn ein Käufer ein Modell mit diesen Ausgaben trainiert, kann das Modell die Abkürzung lernen. Später, wenn die Aufgabe in eine neue Region, ein neues Kundensegment, einen neuen Dokumenttyp oder einen neuen Richtlinienkontext verlagert wird, bricht die Abkürzung zusammen. Ein guter Datenprozess benötigt daher Uneinigkeit.
Er benötigt das System, um aufzuzeigen, wo das Urteil unsicher ist und wo die Rubrik nicht trägt.
Scales Wert steigt, wenn es Uneinigkeit sichtbar macht, sie konsistent auflöst und den Grund bewahrt. Sein Wert fällt, wenn es Uneinigkeit in ein Durchsatzproblem verwandelt.
Bewertung kann nicht auf ein Leaderboard reduziert werden
Modellbewertung ist der Bereich, in dem Scales Problem des Käufervertrauens am explizitesten wird. Ein Trainingsdatensatz kann Task für Task inspiziert werden, aber ein Bewertungssystem wird zu einer Autorität innerhalb der Organisation. Es sagt Teams, welches Modell besser ist, ob eine Version akzeptabel ist, ob eine Leitplanke funktioniert, ob ein Red-Team-Problem behoben ist und ob ein Produkt von der Erprobung in die Produktion überführt werden kann. Wenn diese Autorität schwach ist, kann die Organisation das falsche Verhalten selbstbewusst einsetzen.
Scales ProduktseiteBewertung für Modellentwickleridentifiziert zwei Probleme, die Käufer ernst nehmen sollten: vertrauenswürdige Bewertungsdatensätze und Konsistenz. Sie betont auch proprietäre Bewertungssätze und gezielte Bewertungen. Das ist eine sinnvolle Richtung, weil öffentliche Benchmarks oft zu generisch oder zu exponiert sind, um die Frage eines Käufers zu beantworten. Eine Bank, die Kundenservice-Antworten bewertet, ein Verteidigungsnutzer, der Planungsunterstützung bewertet, ein Medienunternehmen, das Zusammenfassungen bewertet, und ein Softwareunternehmen, das Code-Assistenten-Verhalten bewertet, benötigen nicht denselben Akzeptanzsatz. Sie benötigen Aufgaben, die die Fehler repräsentieren, die sie tatsächlich fürchten.
Die akademische Bewertungsarbeit weist in dieselbe Richtung. DasHELM-Projekt von Stanford argumentiert für die Bewertung von Sprachmodellen über mehrere Dimensionen wie Genauigkeit, Kalibrierung, Robustheit, Fairness, Verzerrung, Toxizität und Effizienz. Das ist für Scale wichtig, weil eine einzelne Punktzahl den Kompromiss verbergen kann, der darüber entscheidet, ob ein Modell verwendet werden sollte. Ein Modell kann im Durchschnitt genauer und in einer engen Klasse von risikoreichen Anfragen weniger sicher sein. Es kann effizient und schlecht kalibriert sein. Es kann in Englisch gut und in einer Landessprache schlecht abschneiden. Es kann anstößige Inhalte vermeiden und dennoch unqualifizierte Ratschläge geben. Ein ernsthaftes Bewertungssystem muss diese Dimensionen bewahren, anstatt sie in eine beschaffungsfreundliche Zahl zu kollabieren.
Es gibt auch das Kontaminationsproblem. Die Forschung zur Benchmark-Kontamination, einschließlich des ACL-Anthology-Papiers zurDatenkontamination in modernen LLM-Benchmarks, zeigt, warum Überschneidungen zwischen Trainings- und Bewertungsmaterial die Leistung besser erscheinen lassen können, als sie ist. Das Risiko ist nicht auf öffentliche Benchmarks beschränkt. Ein privater Käufer kann seinen eigenen Bewertungssatz kontaminieren, indem er dieselben Beispiele für Optimierung, Anweisungsiteration, Prüferschulung und Versionierungsgenehmigung verwendet. Je mehr ein Team gegen einen festen Bewertungssatz optimiert, desto mehr kann der Satz aufhören, die allgemeine Fähigkeit zu messen, und beginnen, Vertrautheit zu messen.
Scales GenAI Platform Dokumentation zeigt mehrere Werkzeuge, die helfen können, wenn der Käufer sie diszipliniert einsetzt. DieÜbersicht zur Next-Generation-Bewertungbeschreibt Bewertungen als Datenzeilen und Tasks, mit wiederverwendbaren Datensätzen und asynchronen Ergebnissen. DieDokumentation zur automatischen Bewertungbeschreibt modellbasiertes geführtes Dekodieren, das Gründe und Punktzahlen zurückgeben kann. DieDokumentation zu Bewertungs-Dashboardsbeschreibt die Überwachung von Metriken durch Tabellen, Diagramme, Histogramme, Streudiagramme, Zeitreihen und Abfragen. DieTracing-Übersichtbeschreibt Spans und Traces, die Eingaben, Ausgaben, IDs, Zeitsteuerung, Metadaten, Status und Typ erfassen.
Zusammen können diese Teile einen ernsthaften Bewertungsprozess unterstützen. Sie können einem Käufer ermöglichen, Zeilen zusammenzustellen, menschliche und automatisierte Aufgaben auszuführen, Traces zu inspizieren, Trends zu überwachen und Versionen zu vergleichen. Aber sie schaffen auch neue Verantwortlichkeiten. Automatische Prüfer benötigen ihre eigene Validierung. Dashboards benötigen Stichprobenregeln. Traces können sensible Daten enthalten. Wiederverwendbare Datensätze benötigen Versionskontrolle und Kontaminationsschutz.
Zeitreihenverbesserungen können einen echten Produktgewinn, eine geänderte Stichprobe, einen anderen Prüfer, ein bereinigtes Anweisungsmuster oder eine Verschiebung der Benutzerpopulation widerspiegeln. Das Dashboard ist nicht die Wahrheit; es ist ein Instrument, das kalibriert werden muss.
Die nützliche Käuferfrage ist daher nicht: „Kann Scale Bewertungen durchführen?“ Es kann. Die nützliche Frage ist: „Kann Scale uns helfen zu beweisen, dass die Bewertung noch das bedeutet, was wir glauben, dass sie bedeutet?“ Dieser Nachweis erfordert zurückgehaltene Beispiele, Prüferkalibrierung, neue gegnerische Fälle, explizite Richtlinienversionen, Erfassung von Gründen, Kontaminationsprüfungen, Konfidenzintervalle wo praktikabel, und eine Freigaberegel, die Teams daran hindert, nur auf die angezeigte Punktzahl zu optimieren.
Bewertung ist wertvoll, wenn sie im richtigen Moment Reibung erzeugt. Sie sollte eine Version verlangsamen, wenn Halluzination, Privatsphäre, Sicherheit, Verzerrung, rechtliche, domänenspezifische oder kundenkontextbezogene Fehler auftreten. Sie sollte die Fehlerklasse identifizieren, die mehr Daten benötigt. Sie sollte zwischen einer Modellverbesserung, einem Konfigurationsworkaround und einem Messartefakt unterscheiden. Wenn Scales Bewertungsoberfläche dies tut, ist es ein Produkt für Käufervertrauen. Wenn es nur eine Punktzahl liefert, ist es ein hübscherer Benchmark.
Herkunft und Speicherung sind Qualitätskontrollen
Datenherkunft wird oft als Compliance-Thema behandelt, aber in einem Trainings- und Bewertungssystem ist es ein Qualitätsthema. Ein Modellteam muss wissen, woher ein Beispiel stammt, welche Version einer Anweisung angewendet wurde, wer oder was es überprüft hat, welche Daten angehängt waren, welches Ergebnis exportiert wurde und ob der Datensatz für das nächste Modell wiederverwendet werden kann. Wenn diese Fakten fehlen, kann das Team immer noch ein Modell trainieren, aber es kann nicht erklären, warum den Nachweisen vertraut werden sollte.
Scales Docs legen mehrere Herkunftsoberflächen offen. Task-Metadaten und Tags können Kontext auf Käuferseite tragen. Batches können Arbeit nach Projekt, Zeitpunkt oder betrieblicher Gruppierung segmentieren. Callback-Payloads können Abschluss- und Prüfungsänderungen in das System des Käufers übertragen. Traces in der GenAI Platform können Eingaben, Ausgaben und Status für Arbeitseinheiten bewahren. Workflows können aus Traces, CSV-Dateien, Datenbanken und Cloud-Speicher importieren, Modelle oder Anwendungsdienste aufrufen, Ground Truth verknüpfen, Prüfaufgaben ausführen, als Bewertungen exportieren und wiederholte Ausführungen planen, gemäß ScalesEinführung in WorkflowsundLeitfaden für Bewertungs-Workflows.
Dies sind die Grundlagen eines nützlichen Datensatzes. Sie ermöglichen es einem Käufer, zu rekonstruieren, wie sich ein Beispiel von der Rohquelle zum akzeptierten Ausgabe bewegt hat. Sie machen es auch möglich, Nachweise, die von einem Menschen erzeugt wurden, von Nachweisen, die von einem automatischen Prüfer erzeugt wurden, von Nachweisen, die aus einem Käufersystem importiert wurden, und von Nachweisen, die aus einem Modelllauf abgeleitet wurden, zu trennen. Diese Unterscheidung ist wichtig, weil nicht alle Nachweise dieselbe Autorität haben sollten.
Die Ablehnung einer medizinischen Antwort durch einen menschlichen Experten ist nicht gleichwertig mit der Punktzahl eines billigen Modellprüfers. Eine Spur eines kundenspezifischen Tool-Aufrufs ist nicht gleichwertig mit einer generischen Benchmark-Zeile. Ein Red-Team-Fall, der nach einem Vorfall geschrieben wurde, verdient möglicherweise mehr Gewicht als ein routinemäßiges Validierungsbeispiel.
Speicher- und Zugriffskontrollen beeinflussen, ob dieser Datensatz vertrauenswürdig ist. Scales öffentliche Dokumentation zeigt praktische Integrationsmöglichkeiten. DieAWS S3-Dokumentationempfiehlt delegierten IAM-Zugriff mit einer externen ID und warnt vor dem Risiko des Confused Deputy bei bestimmten Cross-Account-Mustern. DieGoogle Cloud Storage-Dokumentationwarnt ähnlich vor Risiken durch erratene URLs bei Cross-Projekt-Zugriffsmustern. DieAzure Blob Storage-Dokumentationstellt fest, dass das Aufheben einer Verbindung in Scale nicht die Azure-Berechtigungen widerruft. Dies sind keine abstrakten rechtlichen Fußnoten. Sie sind betriebliche Fakten, die entscheiden, ob ein Käufer weiß, wer die zugrunde liegenden Daten noch lesen kann.
DieDokumentation zu sicheren Ergebnis-URLsist besonders wichtig. Sie besagt, dass einige Segmentierungs-, Video- und LiDAR-Ergebnisse standardmäßig auf öffentliche S3-Ergebnis-URLs mit UUIDs hochgeladen werden, während authentifizierte Ergebnis-URLs durch Kontaktaufnahme mit dem Support aktiviert werden können. Das bedeutet nicht, dass ein Käufer in Panik geraten sollte, und es beweist keine schlechte Bereitstellung. Es bedeutet, dass die Ergebnisbereitstellung ein Konfigurationsthema ist, das in den Akzeptanzplan gehört. Wenn die Daten sensibel sind, sollte der Käufer wissen, ob Ergebnisse eine Authentifizierung erfordern, wie lange Links nutzbar bleiben, wo Objekte gespeichert sind, wie der Zugriff protokolliert wird und ob nachgelagerte Teams Ergebnisse in weniger kontrollierte Orte kopieren.
Datenlokalität und Souveränität fügen eine weitere Ebene hinzu. Scales öffentliche Oberflächen umfassen Behauptungen zu Regierungs- und sicheren Bereitstellungen, einschließlich der Positionierung von Donovan in Bezug auf klassifizierte, abgeschottete und FedRAMP-High-Kontexte. Der FedRAMP-Marktplatz listetScale AI Data Platformals FedRAMP-zertifiziert, Klasse D Hoch, mit Zertifizierungsdatum 9. September 2024. Das ist bedeutsam für öffentliche Käufer, weil es einen Autorisierungspfad für ein definiertes Produkt zeigt. Es löst nicht automatisch jede Anforderung an Lokalität, Klassifizierung, Mission, Exportkontrolle oder Kundendaten.
Die richtige Schlussfolgerung ist, dass Herkunft und Speicherung Teil des Produkts sind, keine nachträglichen Kontrollen. Wenn ein Käufer eine akzeptierte Dateneinheit nicht auf ihre Quelle, Richtlinienversion, Prüferpfad und Ergebnisablage zurückverfolgen kann, ist die Einheit fragil. Sie kann für ein schnelles Experiment nützlich sein, aber sie ist nicht stark genug, um eine Modellversion zu steuern oder ein ernsthaftes Audit zu unterstützen.
Zuverlässigkeit zeigt sich in Grenzen, Callbacks und Vorfällen
Zuverlässigkeit für Scale sollte auf zwei Ebenen gemessen werden. Die erste ist die Zuverlässigkeit der Produktoberfläche: APIs, Task-Zustand, Callbacks, Dashboards, Speicherzugriff, Identität und Produktverfügbarkeit. Die zweite ist die Zuverlässigkeit der erzeugten Nachweise: Labels, Bewertungsergebnisse, Prüferentscheidungen und Traces. Beide sind wichtig, und sie können unabhängig voneinander fehlschlagen. Eine stabile API kann schwache Labels liefern. Ein starker Prüferprozess kann durch einen Serviceausfall oder einen defekten Callback blockiert werden.
Die öffentliche API-Dokumentation gibt Käufern genügend Details, um eine Zuverlässigkeits-Checkliste zu erstellen. DieAuthentifizierungsdokumentationtrennt Live- und Testmodi und stellt fest, dass Live-Tasks von Menschen ausgeführt werden und Kosten verursachen, während der Testmodus falsche Testantworten zurückgeben kann. Das ist eine Erinnerung daran, dass Integrationstests keine Qualitätstests sind. Ein Käufer kann die API-Verdrahtung in einer Testumgebung validieren, aber aus Testantworten keine menschliche Datenqualität ableiten. Die Live-Validierung erfordert eine kontrollierte Stichprobe und ein Budget.
Technische Grenzen sind ebenfalls wichtig. DieDokumentation zu technischen Grenzen und Empfehlungenlistet Grenzen wie die Anforderungsrate für die Task-Erstellung, Metadatengröße, Attributanzahl, Datei-Upload-Metadaten, Anhangsgröße und Browser-Support-Richtlinien auf. Dies sind keine disqualifizierenden Einschränkungen. Jede Plattform hat Grenzen. Der Punkt ist, dass sie gezählt werden sollten, bevor ein Käufer einen Prozess mit hohem Volumen eingeht. Ein Datenbetrieb, der auf reichhaltige Metadaten, große Anhänge oder schnelle Task-Einreichung angewiesen ist, muss sich um diese Einschränkungen herum entwerfen, anstatt sie in der Produktion zu entdecken.
Die Fehlerbehandlung ist ein weiteres Thema der akzeptierten Einheit. DieFehlerdokumentationbehandelt Anhangsfehler, Authentifizierungsfehler, Zahlungsfehler, fehlende Ressourcen, Idempotenzkonflikte, Ratenbegrenzungen und Serverfehler. DieCallback-Dokumentationbesagt, dass Callback-Wiederholungen bis zu 20 Versuche über 24 Stunden fortgesetzt werden können, wenn keine erfolgreiche Antwort empfangen wird. Käufer sollten diese Fakten in Kontrollen umsetzen: Dead-Letter-Behandlung, Wiederholungsverfahren, Duplikaterkennung, Callback-Authentifizierung, Alarmierung, verzögerte Exportbehandlung und Abstimmung zwischen dem Task-Zustand von Scale und dem System des Käufers.
Scales öffentliche Statusseite fügt ein nützliches, aber unvollständiges Betriebssignal hinzu. Am 11. Juli 2026 meldete derStatus-Zusammenfassungsendpunktalle Systeme in Betrieb über Komponenten wie API, Platform, Web Application, Document AI, Nucleus, Spellbook, Catalog Forge, Catalog Explorer und Donovan. Der öffentlicheIncidents-Endpunktgab eine Historie gelöster Vorfälle zurück, darunter eine verschlechterte Leistung im Januar 2025, eine verschlechterte Nucleus-Leistung im März 2024, ein Donovan-Webanwendungsausfall im November 2023 und frühere Plattform- oder Anwendungsprobleme.
Diese Historie sollte weder überbewertet noch ignoriert werden. Eine Statusseite wird vom Anbieter betrieben und ist oft spärlich. Sie liefert keinen vollständigen Service-Level-Datensatz, keine Ursachenanalyse und keine kundenspezifischen Auswirkungen. Aber sie beweist, dass die Produktoberfläche öffentliche Vorfälle hatte und dass Käufer um Verzögerungen, Verschlechterungen und komponentenspezifische Ausfälle herum entwerfen sollten.
Für einen Daten- oder Bewertungsbetrieb kann Ausfallzeit einen Effekt zweiter Ordnung haben: Modellversionen warten, Prüfwarteschlangen stauen sich, der Incident-Triage fehlen aktuelle Beispiele, und ein Team kann ein Modell ohne den beabsichtigten Bewertungsdurchlauf einsetzen.
Käufer sollten Zuverlässigkeit auf der Ebene der akzeptierten Einheit definieren. Wie viele eingereichte Tasks erreichen einen Endzustand? Wie viele akzeptierte Einheiten werden ohne manuellen Abgleich an das System des Käufers geliefert? Wie oft schlagen Callbacks fehl oder erfordern eine Wiederholung? Wie oft werden Anhangsfehler durch Speicherberechtigungen des Käufers verursacht? Wie schnell kann ein abgelehnter Task korrigiert werden? Wie viel Prüfarbeit wird durch Plattformprobleme verzögert? Wie viele Bewertungsläufe werden durch fehlende Traces oder geänderte Prüferkonfiguration ungültig?
Dies sind bessere Fragen als die, ob die Marketingseite sagt, die Plattform sei unternehmensreif.
Scales Chance ist, dass seine Grundbausteine explizit genug für diese Messung sind. Sein Risiko ist, dass Käufer die Existenz von Grundbausteinen mit einer Garantie für das Ergebnis verwechseln könnten.
Kundengeschichten und Regierungsaufträge sind Nachfragesignale, kein Akzeptanznachweis
Scale hat sichtbare Nachfragesignale. Seine Homepage sagt, dass es mit führenden KI-Laboren, Unternehmen und Regierungen zusammenarbeitet. Seine Produktseiten beschreiben Arbeiten für Daten, Bewertung und KI-Anwendungen. SeineKundenstory mit TIMEbeschreibt TIME-KI-Funktionen wie Zusammenfassungen, Sprache, Übersetzung und Chat, mit Feintuning, Red-Teaming, Leitplanken, Überwachung und Tausenden von Angriffsvektoren. Die Defense Innovation Unit kündigteThunderforgean, eine Prototyp-Initiative unter Beteiligung von Scale AI für KI-gestützte Entscheidungsunterstützung in der operativen und Theaterplanung. Scale gab auch bekannt, dass das Chief Digital and Artificial Intelligence Office des Verteidigungsministeriums eine Unternehmensvereinbarung auf eineObergrenze von 500 Millionen US-Dollarausgeweitet hat, die Bereiche wie Computer Vision, Entscheidungsunterstützung und Datenoperationen abdeckt.
Dies sind bedeutende Marktsignale. Sie zeigen, dass Käufer mit ernsthaften Bedürfnissen bereit sind, Scale zu bewerten oder zu nutzen. Sie zeigen auch, warum die Linse der akzeptierten Einheit notwendig ist. Eine Kundengeschichte ist keine unabhängige Renditestudie. Ein Regierungsprototyp ist kein Beweis für den endgültigen Missionserfolg. Eine Vertragsobergrenze ist nicht dasselbe wie verbrauchter Wert.
Ein Kundenlogo kann einem anderen Käufer nicht sagen, ob eine Taxonomie gut war, Prüfer übereinstimmten, Daten innerhalb der erforderlichen Grenzen blieben, Red-Team-Ergebnisse das Modell veränderten oder der Bewertungssatz das Produktionsverhalten vorhersagte.
Dieselbe Vorsicht gilt für Nachweise aus Verteidigung und öffentlichem Sektor. Die Nutzung durch den öffentlichen Sektor erhöht die Einsätze, weil die akzeptierte Einheit Entscheidungsunterstützung, Intelligence-Workflows, operative Planung oder Missionssoftware beeinflussen kann. ScalesDonovan-Seite betont Test, Bewertung, Überwachung, Leitplanken, Rückverfolgbarkeit, Modellagnostizität und sichere Bereitstellungsoptionen. Dies sind die richtigen Kategorien, die für öffentliche Käufer wichtig sind. Aber je folgenreicher die Nutzung, desto konservativer sollte der Evidenzstandard sein. Ein modellgestützter Vorschlag in einem Missionskontext sollte nicht akzeptiert werden, weil ein Dashboard nett ist. Er sollte akzeptiert werden, weil der Quelldatensatz, der Abrufkontext, die Modellausgabe, der Prüferpfad, die Fehlerbehandlung und die menschliche Autorität alle klar sind.
Kommerzielle Käufer stehen vor demselben Muster bei niedrigeren Einsätzen. Ein Medienunternehmen kann generative KI nutzen, um Artikel zusammenzufassen oder Leserfragen zu beantworten. Ein Softwareunternehmen kann Bewertungen nutzen, um Programmierassistenten zu vergleichen. Ein Finanzinstitut kann Dokumentenextraktion überprüfen. Ein Einzelhändler kann ein Empfehlungs- oder Betrugsmodell trainieren. In jedem Fall sollte der Käufer fragen: Was ist die akzeptierte Einheit? Wer hat sie überprüft? Was hat der Prüfer gesehen? Wie werden Fehler gefunden? Was passiert, wenn sich die Richtlinie ändert? Welche Beispiele werden zurückgehalten?
Woher wissen wir, dass sich das Modell verbessert hat, weil sich die Daten verbessert haben?
Scales Kundenevidenz ist am stärksten, wenn sie als Karte möglicher Anwendungsfälle verwendet wird. Sie ist am schwächsten, wenn sie als Beweis dafür verwendet wird, dass ein bestimmter Käufer dasselbe Ergebnis sehen wird. Die Aufgabe, die Daten, die Risikotoleranz, der Prüferpool, die Sicherheitsumgebung und der Freigabeprozess des Käufers entscheiden, ob das Ergebnis übertragbar ist.
Dies ist besonders wichtig, weil viele KI-Beschaffungsentscheidungen unter Druck getroffen werden. Führungskräfte wollen sichtbare Adoption. Produktteams wollen schnell handeln. Modellteams wollen bessere Daten. Sicherheitsteams wollen Kontrollen. Finanzteams wollen wissen, ob die Ausgaben eine messbare Modellverbesserung schaffen. Der Nenner der akzeptierten Einheit gibt ihnen allen eine gemeinsame Sprache. Er verschiebt die Diskussion von „Wer sonst verwendet Scale?“ zu „Was genau akzeptieren wir, und welche Nachweise machen es akzeptabel?„
Die Meta-Investition machte Neutralität zu einem Produktthema
Die Unternehmensstruktur gehört normalerweise nicht in eine technische Bewertung, aber im Fall von Scale überschneidet sie sich mit dem Käufervertrauen. Im Juni 2025 kündigte Scale eine Meta-Investition an, die das Unternehmen mit mehr als 29 Milliarden US-Dollar bewertete, wobei Alexandr Wang zu Meta wechselte, während er im Vorstand von Scale blieb, Jason Droege Interims-CEO wurde und Meta eine Minderheitsbeteiligung hielt. Scale erklärte, dass es unabhängig bleibe und weiterhin die Kundendaten schützen werde.
Kurz darauf berichtete TechCrunch unter Berufung auf Reuters und Unternehmensantworten über Bedenken, dass einige Großkunden nach der Meta-Investition ihre Beziehungen überprüften.
Das technische Problem ist nicht, ob jede berichtete Kundenreaktion genau so stattfand. Das Käuferproblem ist einfacher: Scale verarbeitet sensible Nachweise der Modellentwicklung. Ein KI-Labor, ein Unternehmen oder ein Regierungskunde können Daten einreichen, die Modellschwächen, Produktrichtung, Sicherheitsfehler, Bewertungsrubriken, private Anweisungsmuster, domänenspezifische Randfälle, Kundendaten oder zukünftige Release-Prioritäten offenbaren. Selbst wenn die vertraglichen Schutzmaßnahmen stark sind, ist die Wahrnehmung der Neutralität wichtig, weil die eingereichten Daten strategisch sensibel sein können.
Scales Antwort muss betrieblicher Natur sein, nicht rhetorisch. Käufer sollten nach vertraglichen Datennutzungsgrenzen, Zugriffskontrollen, Trennung, Prüfrechten, Aufbewahrungsregeln, Speicherort, Zugriffsrichtlinie für Prüfer, Handhabung durch Unterauftragnehmer, Exportverfahren, Benachrichtigung bei Vorfällen, Löschverfahren und klaren Zusagen zu Wettbewerbsinformationen suchen. Sie sollten auch prüfen, wie Scale kundenspezifische Bewertungssätze behandelt.
Wenn der private Bewertungssatz eines Käufers das Kronjuwel ist, sollte er nicht ohne weiteres wiederverwendet, Wettbewerbern zugänglich gemacht oder zur Verbesserung eines allgemeinen Dienstes ohne ausdrückliche Erlaubnis verwendet werden.
Dies bedeutet nicht, dass die Meta-Investition Scale unbrauchbar macht. Viele Unternehmensanbieter bedienen Konkurrenten unter Wahrung von Datengrenzen. Cloud-Anbieter hosten Rivalen. Softwareanbieter analysieren sensible Kundendaten unter vertraglichen Einschränkungen. Verteidigungsunternehmen unterstützen mehrere Programme. Die Frage ist, ob Scale die Grenze glaubwürdig genug machen kann für Käufer, deren Daten und Bewertungen die Modellstrategie offenbaren.
Die Linse der akzeptierten Einheit hilft wieder. Für jede Einheit sollte ein Käufer wissen, welche Daten in Scale eingegeben wurden, wer oder was sie verarbeitet hat, welches Modell oder welcher Prüfer sie gesehen hat, wo das Ergebnis gespeichert wurde, welche Metadaten daran hängen und ob es gelöscht, exportiert oder isoliert werden kann. Wenn dieser Datensatz stark ist, können Bedenken hinsichtlich der Neutralität des Unternehmens durch Verträge und Kontrollen gemanagt werden. Wenn der Datensatz schwach ist, hängt das Vertrauen von Zusicherungen ab.
Bei KI sind Zusicherungen nicht genug. Die Artefakte sind zu wertvoll.
Die Wirtschaftlichkeit ist marginal, nicht magisch
Scales kommerzielle Frage ist, ob bessere Daten- und Bewertungsergebnisse die Kosten für Annotationsarbeit, Expertenüberprüfung, Sicherheitseinrichtung, Integration, Nacharbeit, Anbieterabhängigkeit und marginale Modellverbesserung übersteigen. Dieser Satz ist bewusst unromantisch, weil Datenqualität für sich genommen keinen Wert schafft. Sie schafft nur Wert, wenn sie ein Modell, ein Produkt oder eine Entscheidung genug verändert, um die Kosten zu rechtfertigen.
Der häufigste Fehler ist, Scales Stückpreis mit einem internen Stundensatz oder einer simplen Modellanbieter-Bewertungsfunktion zu vergleichen. Das übersieht den gesamten Kostenstapel. Ein Käufer bezahlt für Projektentwurf, Taxonomieerstellung, Stichprobenauswahl, Speicherintegration, Sicherheitsüberprüfung, rechtliche Prüfung, Zeit des Modellteams, Prüferkalibrierung, Auditentwurf, Nacharbeit, Export, Überwachung, Dashboard-Interpretation und das nachgelagerte Experiment, das beweist, ob die akzeptierten Einheiten das Modell verbessert haben. Wenn die Modellverbesserung gering ist, kann teure Evidenz dennoch eine schlechte Investition sein.
Der zweite Fehler ist, die menschliche Überprüfung als feste Kosten zu behandeln. Menschliche Überprüfung wird teurer, je mehrdeutiger, sensibler, domänenspezifischer oder mehrsprachiger die Aufgabe wird. Ein allgemeiner Prüfer kann offensichtliche Inhalte klassifizieren. Ein Fachexperte kann für medizinische, rechtliche, verteidigungsbezogene, Netzwerk-, Code-, Finanz- oder Sicherheitsaufgaben erforderlich sein. Scales Positionierung der GenAI Data Engine mit Fachexperten ist aus genau diesem Grund kommerziell attraktiv, aber die Expertenüberprüfung ändert die Wirtschaftlichkeit.
Der Käufer sollte die Kosten pro akzeptierter, von Experten überprüfter Einheit messen, nicht nur die Kosten pro eingereichtem Task.
Der dritte Fehler ist, Nacharbeit zu ignorieren. Nacharbeit umfasst nicht nur abgelehnte Tasks. Sie umfasst unklare Anweisungen, Taxonomieänderungen, Prüferumschulung, Korrekturen von Speicherberechtigungen, Callback-Abstimmung, Aktualisierung von Bewertungssätzen, Kontaminationsuntersuchungen, doppelte Labels, veraltete Beispiele und Modell Experimente, die nicht von den neuen Daten profitieren. Scales Überprüfungs- und Audit-Grundbausteine können Nacharbeit sichtbar machen, wenn Käufer sie instrumentieren. Wenn sie dies nicht tun, wird Nacharbeit zu unsichtbarer Margenerosion.
Die richtige wirtschaftliche Metrik ist die marginale Modell- oder Produktverbesserung pro akzeptierter Einheit. Für Trainingsdaten sollte der Käufer das Modellverhalten vor und nach dem Hinzufügen akzeptierter Beispiele vergleichen, vorzugsweise nach Fehlerklasse. Sind Halluzinationen für die Zielkategorie zurückgegangen? Hat sich die Extraktionsgenauigkeit bei schwierigen Dokumenten verbessert? Hat ein Computermodell den Randfall besser verarbeitet? Hat ein Richtlinienmodell weniger unsichere Genehmigungen erteilt? Hat sich das Modell bei zurückgehaltenen Beispielen verbessert, die nicht zur Optimierung des Prozesses verwendet wurden?
Wenn nicht, können die akzeptierten Einheiten wohlgeformt, aber strategisch von geringem Wert sein.
Für die Bewertung ist die Metrik anders. Ein gutes Bewertungssystem verbessert möglicherweise nicht direkt das Modell. Es kann eine schlechte Version verhindern, einen Fehler frühzeitig finden, die Debugging-Zeit verkürzen, Modellregressionen aufdecken, die Governance unterstützen oder einen riskanten Anwendungsfall als inakzeptabel erweisen, bevor er Schaden verursacht. Dieser Wert ist real, aber schwerer zu zählen.
Käufer sollten vermiedene Versionsvorfälle, Zeit bis zur Identifizierung der Fehlerklasse, Anzahl der versionsblockierenden Erkenntnisse, Reduzierung der manuellen Überprüfung pro Version, Vertrauen in Modellvergleiche und ob die Bewertung beobachtete Produktionsprobleme vorhersagt, verfolgen.
Scales Wertversprechen ist am stärksten, wenn der Käufer wiederholte, folgenreiche Evidenzanforderungen hat und keine Neigung, den gesamten Datenbetrieb allein aufzubauen. Entwickler von Grenzmodellen, KI-Teams in Unternehmen und Regierungsnutzer passen in dieses Profil, weil sie eine stetige Versorgung mit vertrauenswürdigen Beispielen, Bewertungsrubriken, Red-Team-Fällen und Überprüfungsartefakten benötigen. Das Wertversprechen ist schwächer, wenn die Aufgabe einfach, einmalig, risikoarm ist, leicht von internen Prüfern erledigt werden kann oder nicht mit einer messbaren Modellentscheidung verbunden ist.
Weniger von der Aufgabe zu tun, ist eine legitime Alternative. Wenn eine Modellanwendung nicht gut genug bewertet werden kann, kann die Antwort sein, das Produkt einzugrenzen, die menschliche Genehmigung beizubehalten, die Automatisierung in einem sensiblen Segment zu vermeiden oder die Bereitstellung zu verschieben. Scale konkurriert nicht nur mit anderen Anbietern, sondern auch mit Zurückhaltung.
Was Käufer messen sollten, bevor sie skalieren
Ein Käufer, der Scale bewertet, sollte mit einem kleinen, repräsentativen Akzeptanzplan beginnen. Der Plan sollte nicht fragen: „Kann Scale unsere Daten verarbeiten?“ Er sollte fragen: „Kann Scale akzeptierte Einheiten produzieren, die eine Modellentscheidung oder eine Release-Entscheidung in einer nachprüfbaren Weise ändern?„ Dieser Plan benötigt einen Nenner, eine Stichprobe, eine Baseline und eine Fehlertaxonomie.
Für Datenarbeit sollte der Käufer den Einheitentyp definieren: Bildlabel, Dokumentenextraktion, Sicherheitsklassifikation, Code-Antwort-Überprüfung, Reasoning-Trace-Beurteilung, Präferenzpaar, Red-Team-Fall, retrieval-gestützte Antwort, Tool-Call-Bewertung oder Expertenkorrektur. Es sollte die Quelldaten, die Anweisungsversion, die Taxonomie, die Prüferqualifikationen, den Eskalationspfad und das Exportformat definieren. Es sollte bekannte schwierige Fälle und Beispiele enthalten, bei denen die richtige Antwort absichtlich mehrdeutig ist. Wenn jedes Testbeispiel einfach ist, ist der Test meistens Integrations-Theater.
Die erste Metrik ist die Erstakzeptanz. Wie viele eingereichte Einheiten werden ohne Korrektur akzeptiert? Die zweite ist die Uneinigkeit. Wie oft unterscheiden sich Prüfer, und bei welchen Kategorien? Die dritte ist die Nacharbeit. Wie viele Einheiten erfordern geänderte Anweisungen, überarbeitete Labels oder zusätzliche Expertenüberprüfung? Die vierte ist die Vollständigkeit der Herkunft. Kann der Käufer für jede akzeptierte Einheit die Quelle, Anweisungsversion, Prüferpfad, Ergebnis und Exportziel rekonstruieren? Die fünfte ist die Modellauswirkung.
Verbessert das Hinzufügen oder Verwenden der akzeptierten Einheit das Zielverhalten auf einem zurückgehaltenen Satz?
Für Bewertungsarbeit sollte der Käufer Stabilität und Vorhersagekraft messen. Wenn dasselbe Modell zweimal unter denselben Bedingungen bewertet wird, wie stark bewegt sich die Punktzahl? Wenn sich die Prüfer ändern, hält das Ergebnis? Wenn ein automatischer Prüfer verwendet wird, wie oft stimmt er mit der fachlichen Expertenüberprüfung bei schwierigen Fällen überein? Erfasst die Bewertung bekannte historische Fehler? Identifiziert sie neue Fehler, die Produktionsprotokolle später bestätigen? Bleibt sie nützlich, nachdem das Modellteam einige der Beispiele gesehen hat, oder wird sie zu einem Trainingsziel?
Für Sicherheit und Daten-Governance sollte der Käufer den Speicher- und Ergebnispfad überprüfen, bevor sensible Daten eingereicht werden. Welche Cloud-Speicherberechtigungen werden erteilt? Wer kann sie widerrufen? Sind Ergebnis-URLs authentifiziert? Wo werden Traces gespeichert? Was wird nach dem Export aufbewahrt? Sind Callback-Endpunkte authentifiziert und protokolliert? Sind API-Schlüssel nach Umgebung getrennt? Sind Prüfer- und Auditor-Rollen auf die richtigen Daten beschränkt?
Erfordern öffentliche oder regulierte Bereitstellungen FedRAMP-autorisierte Oberflächen, abgeschottete Umgebungen, Regionseinschränkungen oder kundenverwaltete Schlüssel?
Für Zuverlässigkeit sollte der Käufer den Pfad von der Einreichung bis zur nachgelagerten Nutzung instrumentieren. Task eingereicht ist nicht Task akzeptiert. Task akzeptiert ist nicht Task, der vom Trainings- oder Bewertungsprozess konsumiert wird. Training oder Bewertung konsumiert ist nicht Produktverbesserung. Jede Übergabe sollte einen Abgleich haben. Callback-Fehler, verzögerte Batches, Anhangsfehler, Audit-Statusänderungen und abgelehnte Tasks sollten sichtbar sein. Vorfälle auf der Statusseite sollten Playbooks auf Käuferseite haben: was wird angehalten, was wird wiederholt, was fällt zurück, und welche Release-Entscheidungen warten.
Für Anbieterabhängigkeit sollte der Käufer einen Exit-Test entwerfen. Können akzeptierte Einheiten in einem nützlichen Format exportiert werden? Kann die Taxonomie woanders reproduziert werden? Können Prüferkommentare und Audit-Status mitgenommen werden? Sind private Bewertungssätze portabel? Sind Workflow-Definitionen und Dashboards ersetzbar? Kann der Käufer einen reduzierten internen Prozess betreiben, wenn Scale nicht verfügbar oder strategisch ungeeignet ist? Wechselkosten sind kein Grund, einen Anbieter zu meiden, aber sie sollten bekannt sein, bevor die Abhängigkeit wächst.
Diese Messungen sind nicht anti-Scale. Sie sind die Bedingungen, unter denen Scale seinen Wert beweisen kann. Ein Käufer, der diese Arbeit erledigt, kann entdecken, dass Scale signifikant besser ist als interne Operationen oder verstreute Werkzeuge. Er kann auch entdecken, dass ein enger interner Überprüfungsprozess ausreicht. Beides ist besser, als Volumen ohne Akzeptanz zu kaufen.
Das Urteil
Scale AI ist eines der wichtigsten Unternehmen in der KI-Evidenzschicht, weil die Industrie gelernt hat, dass Modelle durch Datenqualität, Bewertungsqualität und die Disziplin der Überprüfung begrenzt werden. Seine öffentlichen Produktoberflächen zeigen ernsthafte Mechanismen: Task- und Batch-APIs, Taxonomien, Callbacks, Audits, Prüfertrennung, Bewertungszeilen, Dashboards, Traces, Workflow-Orchestrierung, Cloud-Speicherintegrationen, Behauptungen zur sicheren Bereitstellung und Signale zur Autorisierung im öffentlichen Sektor.
Dies sind die richtigen Bausteine für ein Unternehmen, das versucht, unsichere Daten in akzeptierte Trainings- und Bewertungseinheiten zu verwandeln.
Die Bausteine entscheiden nicht über die Frage. Die harte Arbeit ist nicht die Existenz von Tasks. Es ist, ob der Task nach Tausenden von Beispielen, mehreren Prüfern, Richtlinienänderungen, Speicherübergaben, Modelliterationen und Freigabeentscheidungen noch dasselbe bedeutet. Es ist, ob ein Bewertungssatz frisch und unkontaminiert bleibt. Es ist, ob automatische Prüfer helfen, anstatt Modellverzerrung in eine Punktzahl zu waschen. Es ist, ob private Daten und private Bewertungslogik innerhalb der beabsichtigten Grenze des Käufers bleiben. Es ist, ob die marginale Verbesserung des Modellverhaltens die Kosten der Evidenzoperation wert ist.
Scales Marktsignale sind stark. KI-Labore, Unternehmen und öffentliche Käufer haben Gründe, ein externes System für Daten- und Bewertungsarbeit zu wollen. FedRAMP-Autorisierung und verteidigungsorientierte Produktaussagen machen Scale in Umgebungen relevant, in denen Käufervertrauen nicht optional ist. Die Meta-Investition und die Berichterstattung über Kundenreaktionen machen Neutralität und Datengrenzen wichtiger, nicht weniger. Kundengeschichten und Vertragsankündigungen sollten die Prüfung erhöhen, nicht ersetzen.
Der beste Fall für Scale ist nicht, dass jeder Kunde die Datenarbeit an den größten sichtbaren Anbieter auslagern sollte. Der beste Fall ist, dass moderne KI-Teams einen wiederholbaren Weg benötigen, um vertrauenswürdige Evidenz herzustellen, und Scale hat viele der erforderlichen Produktgrundbausteine zusammengestellt. Die beste Kritik ist, dass Evidenzqualität lokal ist. Sie hängt von den Anweisungen, Prüfern, Daten, Randfällen, Sicherheitsentscheidungen und der Freigabedisziplin des Käufers ab. Kein Anbieter kann einen schwachen Akzeptanzprozess stark machen, indem er ihn im Maßstab verarbeitet.
Daher sollte die Entscheidung des Käufers konkret sein. Wählen Sie das Modellverhalten, das wichtig ist. Definieren Sie die akzeptierte Einheit. Führen Sie eine repräsentative Stichprobe durch. Messen Sie die Prüferübereinstimmung, Herkunft, Nacharbeit, Kontaminationsrisiko, Sicherheitskonfiguration und Modellauswirkung. Vergleichen Sie Scale mit interner Überprüfung, Modellanbieter-Tools, Open-Source-Bewertungsstapeln und einem engeren Produktumfang. Skalieren Sie den Prozess dann nur, wenn die akzeptierte Einheit überlebt.
Scales wahres Produkt ist Vertrauen in die Dateneinheit, die ein Modellteam verwenden möchte. Dieses Vertrauen ist teuer, fragil und messbar. Es ist auch genau der Ort, an dem die nächste Phase des KI-Wettbewerbs entschieden wird.